做 Python爬虫 的朋友,大多都爬过淘宝、京东,但很少人碰 义乌购(yiwugo.com)。
其实,义乌购才是中国小商品数据的源头——这里的批发价、起订量、真实成交量,直接反映全国线下零售的进货成本。
无论你是做 跨境电商选品、抖音快手带货,还是线下摆摊货源调研,一套稳定的 义乌购爬虫,能帮你省下几千块的选品软件和情报费。
但义乌购的页面结构极其“野生”,价格拆分、销量混淆、验证码拦截,随便一个坑就能让脚本直接报废。
一、为什么义乌购值得爬?
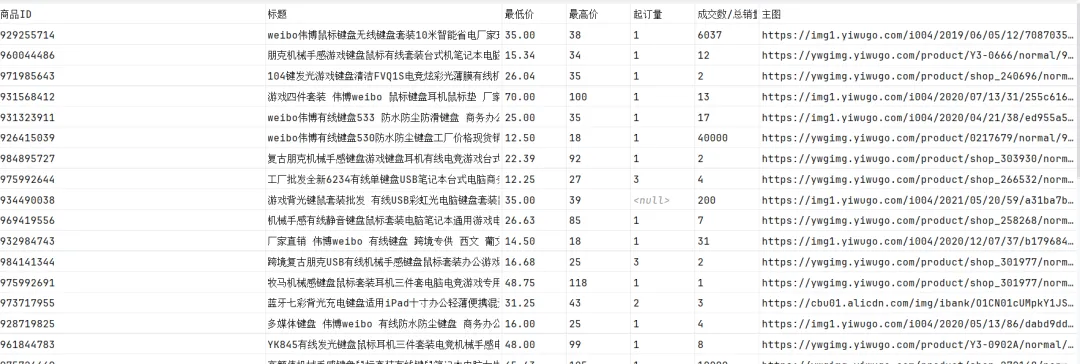
字段 | 商业价值 |
|---|
最低价 / 最高价 | 判断利润空间 |
起订量 | 判断供应链门槛 |
成交数 / 总销量 | 判断爆款潜力 |
开店年数 | 判断供货稳定性 |
主图 & 链接 | 二次选品 / 搬运 |
👉 这些数据,1688 要会员,义乌购免费,但不好拿。
二、核心难点
1️⃣ 价格拆分(最阴间)
义乌购的价格不是“¥12.5”,而是:
<spanclass="start-price">12</span><span>~</span><span><spanclass="f18">25</span><spanclass="f12 c999">.50</span></span>
✅ 难点:高低价拆在两个 span 里,小数点也被拆开
✅ 解法:CSS 精准定位 + 字符串拼接
2️⃣ 成交量混淆(防爬虫设计)
页面上写着:
✅ 难点:高低价拆在两个 span 里,小数点也被拆开✅ 解法:CSS 精准定位 + 字符串拼接(此处省略 15 行代码)2️⃣ 成交量混淆(防爬虫设计)页面上写着:
但 DOM 结构是:
<divclass="start-number">成交 1.2万笔</div><divclass="start-number">起订 20件</div>
✅ 难点:顺序不稳定,有时成交在前,有时起订在前
✅ 解法:正则 + 单位判断(万 = ×10000)
✅ 核心正则:
if '万' in text: number = float(extract_digits) * 10000
👉 完整正则封装函数,暂不公开
3️⃣ 验证码拦截
义乌购对新 IP / 高频请求非常敏感:
✅ 解法:
print('⚠️ 若出现验证码,请手动完成滑块验证')time.sleep(3)
👉 这是唯一靠谱的方案,无头模式直接死
4️⃣ 翻页按钮的“假死”状态
按钮 HTML:
<aclass="btn-next is-disabled">下一页</a>
✅ 难点:按钮永远存在,只是加了个 class
✅ 解法:判断 is-disabled 是否存在(逻辑简单,但容易忽略)
三、我能告诉你的
✅ 搜索框定位:css:.input
✅ 商品卡片容器:css:div.products-box
✅ 商品标题:css:.product-name span
✅ 店铺名:css:.shop_name a.name
✅ 主图地址:css:.thumbnail 的 src
✅ 商品 ID 提取逻辑:从 URL 中切 .html
👉 以上这些,自己试 10 分钟就能写出来
五、这套数据能干什么?(商业想象力)
爬虫不难,难的是在反爬和混乱结构中,稳定拿到干净数据。
 10个月宝宝每天需要喝多少奶粉?