开篇引入
AI Agent 的概念火了很久,但从跑通一个 demo 到真正落地,中间还隔着工程化的鸿沟。LangGraph 提供了一条务实的路径:用图结构编排 Agent 工作流,让每一步都可视化、可控制、可回溯。
这篇文章,我们用 Python 和 Java 双语言实现同一个旅游规划 Agent——从需求收集、目的地搜索、行程规划、预算估算到方案展示,完整走一遍落地流程。
代码仓库地址:learn-ai/langgraph-travel-agent/
LangGraph 核心概念速览
在动手之前,先快速对齐几个核心概念。
StateGraph(状态图)
LangGraph 把 Agent 工作流建模为一张有向图。所有节点共享同一份状态(State),每个节点读取状态、处理逻辑、返回状态更新。你可以把它理解为一条"流水线",每个工位处理不同的任务,传递的是同一份工单。
Node(节点)
节点就是一个普通函数:接收当前状态,返回一个更新字典。不需要继承基类,不需要特殊装饰器(Python 版),写完就能直接挂到图上。
Edge(边)
边控制节点之间的执行顺序。LangGraph 支持两种边:
- • 普通边:A → B,固定流向
- • 条件边:根据状态动态决定下一步走哪个节点,类似
if-else 路由
State(状态)
Python 版用 TypedDict 定义状态结构,Java 版用 AgentState 子类。关键字段可以配置 Reducer——比如 messages 字段使用 add_messages,每次节点返回的消息会自动追加而不是覆盖。
Checkpoint(检查点)
LangGraph 内置状态持久化机制,支持内存、SQLite、PostgreSQL 等后端。这意味着你可以暂停、恢复、回溯 Agent 的执行——这是从 demo 到生产的关键能力。
整体流程
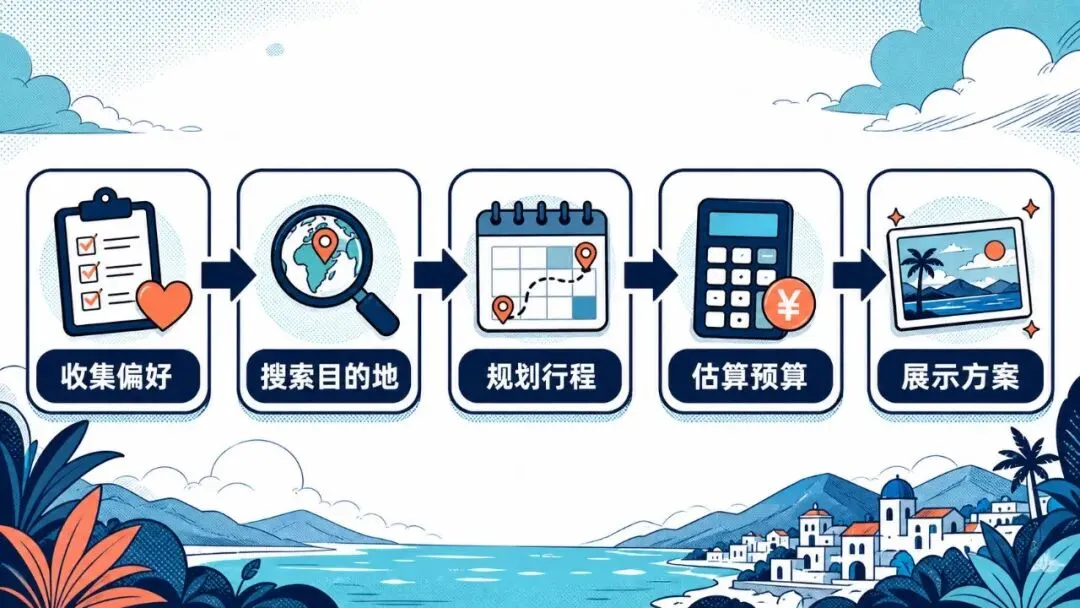
我们的旅游规划 Agent 的工作流如下:
START → 收集偏好 → 搜索目的地 → 规划行程 → 估算预算 → 展示方案 → END
每个节点读取 TravelState,完成自己的任务,把结果写回状态,下一个节点接着用。简单、清晰、可预测。
Python 实战:旅游规划 Agent
3.1 环境准备
需要 Python 3.10+,安装依赖:
pip install -r requirements.txt
依赖清单很精简:
langgraph>=0.2.0
langchain-openai>=0.3.0
langchain-core>=0.3.0
python-dotenv>=1.0.0
配置 .env 文件,填入你的 OpenAI API Key:
OPENAI_API_KEY=your_api_key
3.2 State 设计
状态是整个图的"公共数据区"。TravelState 用 TypedDict 定义,一目了然:
from typing import Annotated
from typing_extensions import TypedDict
from langgraph.graph.message import add_messages

class TravelState(TypedDict):
    messages: Annotated[list, add_messages]
    preferences: dict           # {destination, dates, budget_limit, interests}
    destinations: list[dict]    # 搜索到的目的地选项
    itinerary: list[dict]       # 每日行程安排
    budget_breakdown: dict      # {flights, hotels, food, ...}
注意 messages 字段的 Annotated[list, add_messages]——这是 LangGraph 的 Reducer 机制。当节点返回 {"messages": [new_msg]} 时,新消息会追加到列表末尾,而不是覆盖整个列表。其他字段则默认采用覆盖策略。
3.3 图结构与节点
图构建代码非常直观:
from langgraph.graph import StateGraph, START, END

def build_travel_graph() -> StateGraph:
    graph = StateGraph(TravelState)

    # 添加节点
    graph.add_node("gather_preferences", gather_preferences)
    graph.add_node("search_destinations", search_destinations)
    graph.add_node("plan_itinerary", plan_itinerary)
    graph.add_node("estimate_budget", estimate_budget)
    graph.add_node("present_plan", present_plan)

    # 连接边(线性流程)
    graph.add_edge(START, "gather_preferences")
    graph.add_edge("gather_preferences", "search_destinations")
    graph.add_edge("search_destinations", "plan_itinerary")
    graph.add_edge("plan_itinerary", "estimate_budget")
    graph.add_edge("estimate_budget", "present_plan")
    graph.add_edge("present_plan", END)

    return graph
每个节点就是一个普通函数,接收 TravelState,返回状态更新字典。看两个关键节点:
偏好收集节点——用 LLM 从用户自然语言中提取结构化偏好:
def gather_preferences(state: TravelState) -> dict:
    messages = state["messages"]
    prompt = """你是一个旅行规划助手。请从用户的消息中提取旅行偏好信息。
    请严格以 JSON 格式返回:
    {"destination": "...", "dates": "...", "budget_limit": ..., "interests": [...]}"""

    response = llm.invoke([
        {"role": "system", "content": prompt},
        *messages
    ])

    # 解析 JSON,失败时使用默认值
    try:
        preferences = json.loads(response.content.strip())
    except (json.JSONDecodeError, IndexError):
        preferences = {"destination": "东京", "budget_limit": 10000, ...}

    return {"preferences": preferences}
行程规划节点——结合目的地信息和用户兴趣,生成每日行程:
def plan_itinerary(state: TravelState) -> dict:
    destination = state["preferences"].get("destination", "东京")
    highlights = state["destinations"][0]["info"].get("highlights", [])

    prompt = f"""请为去{destination}的旅行制定详细每日行程。
    目的地亮点:{', '.join(highlights)}
    用户兴趣:{', '.join(interests)}
    请以 JSON 数组格式返回..."""

    response = llm.invoke([{"role": "system", "content": prompt}])
    itinerary = json.loads(response.content.strip())

    return {"itinerary": itinerary}
每个节点的职责单一、边界清晰:读状态 → 处理 → 写回状态。这就是 LangGraph 推崇的"节点即函数"的设计哲学。
3.4 工具定义
工具使用 LangChain 的 @tool 装饰器,返回模拟数据,让 demo 无需真实 API 就能跑起来:
from langchain_core.tools import tool

@tool
def search_flights(origin: str, destination: str, date: str) -> str:
    """搜索航班信息"""
    flights = [
        {"airline": "国际航空", "flight_no": "CA1234",
         "price_cny": 2800, ...},
        # ... 更多航班
    ]
    return json.dumps(flights, ensure_ascii=False)

@tool
def get_destination_info(city: str) -> str:
    """获取目的地旅游信息"""
    # 预设了东京、巴黎、曼谷等城市的旅游数据
    ...
在 search_destinations 节点中,通过 tool.invoke({"city": destination}) 调用工具。实际项目中,只需把模拟数据替换为真实 API 调用即可。
3.5 运行入口
main.py 提供 CLI 交互,核心流程:
def main():
    load_dotenv()
    app = compile_travel_graph()

    user_input = input("> ").strip()
    if not user_input:
        user_input = "我想去东京旅游5天,预算10000元,对文化和美食感兴趣"

    initial_state = {
        "messages": [HumanMessage(content=user_input)],
        "preferences": {}, "destinations": [],
        "itinerary": [], "budget_breakdown": {}
    }

    final_state = app.invoke(initial_state)
    print(final_state["messages"][-1].content)
运行 python -m src.main,输入需求,Agent 自动走完 5 个节点,输出完整的旅行方案。
Java 实战:LangGraph4j 同构实现
Java 版使用 LangGraph4j 框架,整体架构与 Python 版同构,但有一些 Java 特有的设计模式。
4.1 Maven 配置
核心依赖:
<properties>
    <langgraph4j.version>1.8.20</langgraph4j.version>
    <langchain4j.version>1.0.0-beta3</langchain4j.version>
</properties>

<dependencies>
    <!-- LangGraph4j 核心 -->
    <dependency>
        <groupId>org.bsc.langgraph4j</groupId>
        <artifactId>langgraph4j-core</artifactId>
    </dependency>
    <!-- LangChain4j 集成 -->
    <dependency>
        <groupId>org.bsc.langgraph4j</groupId>
        <artifactId>langgraph4j-langchain4j</artifactId>
    </dependency>
    <!-- LangChain4j OpenAI -->
    <dependency>
        <groupId>dev.langchain4j</groupId>
        <artifactId>langchain4j-open-ai</artifactId>
    </dependency>
</dependencies>
LangGraph4j 搭配 LangChain4j 使用,Java 17+ 即可运行。
4.2 状态定义
Java 版的状态需要继承 AgentState,通过 SCHEMA 静态常量定义字段和更新策略:
public class TravelState extends AgentState {
    public static final String KEY_MESSAGES = "messages";
    public static final String KEY_DESTINATION = "destination";
    public static final String KEY_ITINERARY = "itinerary";
    // ... 其他键常量

    public static final Map<String, Channel<?>> SCHEMA = Map.of(
        KEY_MESSAGES, Channels.appender(ArrayList::new),  // 追加模式
        KEY_DESTINATION, Channel.of(),                     // 覆盖模式
        KEY_ITINERARY, Channel.of(),
        // ...
    );

    public TravelState(Map<String, Object> initData) {
        super(initData);
    }

    // 便捷访问方法
    public String destination() {
        return this.<String>value(KEY_DESTINATION).orElse("");
    }
}
对比 Python 的 TypedDict,Java 版多了类型安全的优势:键名是常量、访问有类型推断、编译期就能发现拼写错误。
4.3 图构建与节点
Java 的节点需要实现 NodeAction<TravelState> 接口:
public class GatherRequirementsNode implements NodeAction<TravelState> {
    private final ChatLanguageModel model;

    @Override
    public Map<String, Object> apply(TravelState state) {
        String userInput = state.messages().get(0);

        // 用 LLM 提取结构化信息
        String prompt = """
            请从以下用户输入中提取旅游需求信息:
            用户输入: "%s"
            返回格式: {"destination": "...", "budget": "...", "days": "..."}
            """.formatted(userInput);

        String llmResponse = model.generate(prompt);

        // 返回状态更新
        Map<String, Object> updates = new HashMap<>();
        updates.put(TravelState.KEY_DESTINATION, destination);
        updates.put(TravelState.KEY_BUDGET, budget);
        updates.put(TravelState.KEY_DAYS, days);
        return updates;
    }
}
Java 版还多了一个有意思的设计——审核-修改循环。ReviewPlanNode 审核行程质量,如果不通过就交给 RevisePlanNode 修改,然后再审核,形成循环:
// ReviewPlanNode 中的审核逻辑
String prompt = """
    请审核以下行程规划:
    ...
    如果质量良好,请输出: APPROVED
    如果需要修改,请输出: REVISION: [具体修改建议]
    """;

// RevisePlanNode 根据反馈修改
String prompt = """
    请根据审核反馈修改行程:
    当前行程: %s
    审核反馈: %s
    """;

// 修改后递增 revision_count
updates.put(TravelState.KEY_REVISION_COUNT, revisionCount + 1);
这个循环体现了 LangGraph 条件边的价值——Agent 不是一条直线走到底,而是可以"自查自纠",直到方案质量达标。
4.4 兜底策略
Java 版还有一个值得注意的设计:每个节点都有 LLM 调用失败时的兜底方案。比如 PlanItineraryNode 在 LLM 不可用时,会用模板生成行程:
try {
    itinerary = model.generate(prompt);
} catch (Exception e) {
    // 兜底:使用模板生成行程
    itinerary = generateTemplateItinerary(destination, days, budget);
}
这种"LLM 优先、规则兜底"的策略,在生产环境中非常实用。
Python vs Java 对比与选型
| 维度 | Python(LangGraph) | Java(LangGraph4j) |
|---|
| 上手难度 | 低,TypedDict + 函数即节点 | 中,需实现接口、定义 SCHEMA |
| 生态成熟度 | 高,官方主推,社区活跃 | 成长中,社区较小但功能完整 |
| 类型安全 | 运行时检查 | 编译期检查,IDE 友好 |
| 企业集成 | 一般 | 强,天然融入 Spring 生态 |
| 代码简洁度 | 高,Pythonic | 中,模板代码较多 |
| 适用场景 | 快速原型、研究实验 | 企业级应用、长期维护项目 |
实践建议:
- • 如果你在快速验证想法、做 PoC,Python + LangGraph 是首选,开发效率高,文档丰富
- • 如果你的团队以 Java 为主,项目需要长期维护、与企业系统集成,LangGraph4j 更合适
- • 两者在图编排的核心能力上是对等的,选择取决于团队技术栈和项目生命周期
总结与展望
LangGraph 的核心价值在于:让 Agent 工作流从黑盒变白盒。
传统的 LLM 调用链是一条"隐形"的流水线——你只知道输入和输出,中间发生了什么全靠猜。LangGraph 把每个步骤拆成独立的节点,状态在节点间显式传递,流程由图的边来控制。你可以看到每一步的输入输出,可以在任意节点暂停和回溯,可以针对单个节点做单元测试。
当然,从 demo 到生产还有不少工作要做:
- • 错误处理:LLM 返回格式不可控,需要健壮的解析和兜底
- • 状态持久化:用 Checkpoint 把状态存到 PostgreSQL,支持断点续跑
- • 可观测性:接入 LangSmith 或自建监控,追踪每次调用的耗时和成本
- • 人机协作:在关键节点加入人工确认环节,让 Agent 更可控
LangGraph 生态也在快速演进:LangGraph Platform 提供了一键部署 Agent 的能力,LangGraph Studio 则让图结构的可视化调试成为可能。这些工具链的成熟,会进一步降低 Agent 落地的门槛。
下一篇"AI 落地实战"系列,我们会把这个旅游 Agent 接入真实 API,并部署到生产环境,聊聊中间踩过的坑。
💬 如果你也在探索 LangGraph 与旅游规划 Agent,欢迎在评论区留言或私信交流,一起进步!
