这些 Python 的基础知识还是值得反刍一下的,常看常新,新鲜整理,供小伙伴们收藏。
1. 认识列表
1.1 什么是列表
列表(list)是一种有序、可变的序列。列表中的每个值称为一个元素(element),每个元素都有对应的位置,称为索引(index)。
列表使用方括号 [] 创建,元素之间用逗号分隔:
tasks = ["Read paper", "Clean data", "Write report"]
scores = [86, 92, 78]
empty_list = []
列表有以下特点:
- 可保存任意对象:数字、字符串、布尔值,甚至其他列表都可以作为元素。
values = [10, "Alice", True]
matrix = [[1, 2], [3, 4]]
虽然列表允许混合不同类型,但实际编程中通常让一个列表保存语义一致的数据,例如全部是任务名称或全部是分数,这样更容易理解和维护。
1.2 创建列表的常见方式
最常见的方式是直接使用方括号。也可以使用 list() 将其他可迭代对象转换为列表。
tasks = ["Read paper", "Clean data"]
letters = list("ABC")          # ['A', 'B', 'C'] 依次取出字符串中的每个字符
numbers = list(range(1, 5))   # [1, 2, 3, 4]
list() 会依次读取传入对象中的元素。例如,字符串会被拆分成单个字符,而 range() 生成的整数序列会被转换成数字列表。
1.3 列表与字符串的区别
列表和字符串都有顺序,也都支持索引、切片和遍历。主要区别是:
tasks = ["Read", "Write"]
tasks[0] = "Review"# Valid

title = "Python"
# title[0] = "J"     # TypeError: strings are immutable
2. 读取、切片与修改
2.1 使用索引读取元素
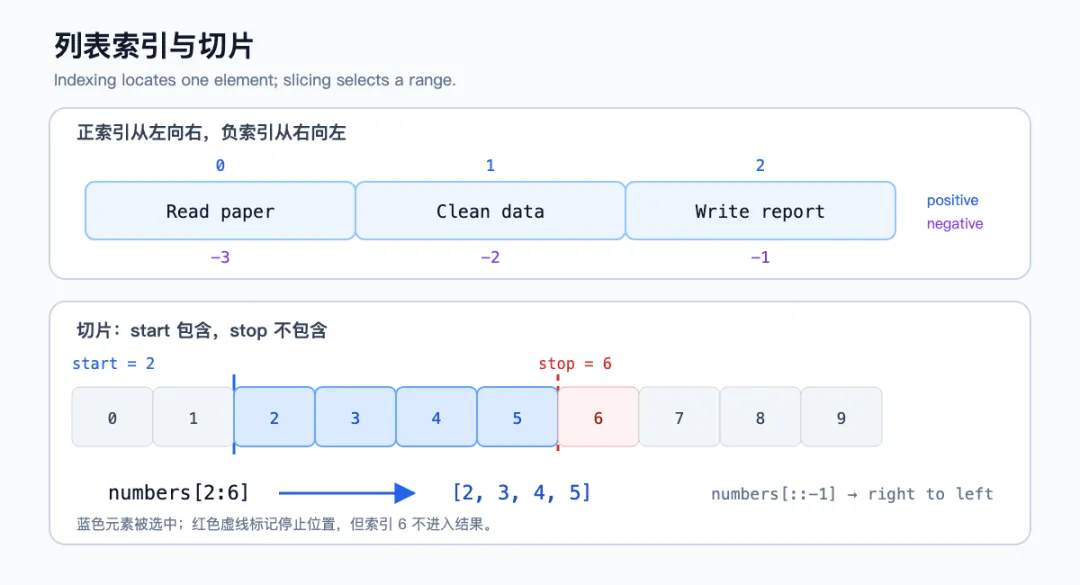
Python 的索引从 0 开始,因此第一个元素的索引是 0,第二个元素的索引是 1。
tasks = ["Read paper", "Clean data", "Write report"]

print(tasks[0])  # Read paper
print(tasks[1])  # Clean data
负索引从列表末尾开始计数:-1 表示最后一个元素,-2 表示倒数第二个元素。
print(tasks[-1])  # Write report
print(tasks[-2])  # Clean data
如果索引超出列表范围,Python 会抛出 IndexError。
# print(tasks[3]) # IndexError: list index out of range
2.2 使用切片取得多个元素
切片的基本语法是:
items[start:stop:step]
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

print(numbers[2:6])   # [2, 3, 4, 5]
print(numbers[:3])    # [0, 1, 2]
print(numbers[7:])    # [7, 8, 9]
print(numbers[::2])   # [0, 2, 4, 6, 8]
print(numbers[::-1])  # [9, 8, 7, 6, 5, 4, 3, 2, 1, 0]
切片通常会创建一个新列表。numbers[::-1] 相当于每次往左挪了一步,因此会得到反转后的副本,而不会修改原列表。
正索引与负索引指向同一组元素;切片包含 start,但不包含 stop。
2.3 修改单个元素
列表是可变对象,可以通过索引给指定位置重新赋值。
tasks = ["Read paper", "Clean data", "Write report"]
tasks[1] = "Analyze data"

print(tasks)  # ['Read paper', 'Analyze data', 'Write report']
2.4 使用切片一次修改多个元素
切片赋值可以同时替换多个连续元素。新元素的数量不必与原切片长度完全一致,因此列表长度也可能发生变化。
tasks = ["Plan experiment", "Collect data", "Analyze data", "Write report"]
tasks[1:3] = ["Validate data", "Write summary"]

print(tasks)
# ['Plan experiment', 'Validate data', 'Write summary', 'Write report']
2.5 判断、定位与计数
使用 in 或 not in 判断某个值是否存在;使用 index() 查找第一个匹配项的位置;使用 count() 统计出现次数。
tasks = ["Read paper", "Clean data", "Write report", "Read paper"]

print("Clean data"in tasks)       # True
print("Submit report"notin tasks)  # True
print(tasks.index("Write report")) # 2
print(tasks.count("Read paper"))   # 2
如果 index() 找不到指定值,会抛出 ValueError。不确定元素是否存在时,应先使用 in 判断。
3. 添加与删除元素
3.1 在末尾添加一个元素:append()
append(value) 将一个值作为单个元素添加到列表末尾,常用于逐步构建列表。
tasks = []
tasks.append("Read paper")
tasks.append("Clean data")

print(tasks)  # ['Read paper', 'Clean data']
3.2 一次添加多个元素:extend()
extend(iterable) 会依次读取另一个可迭代对象中的元素,并逐个添加到原列表末尾。
tasks = ["Read paper"]
tasks.extend(["Clean data", "Write report"])

print(tasks)  # ['Read paper', 'Clean data', 'Write report']
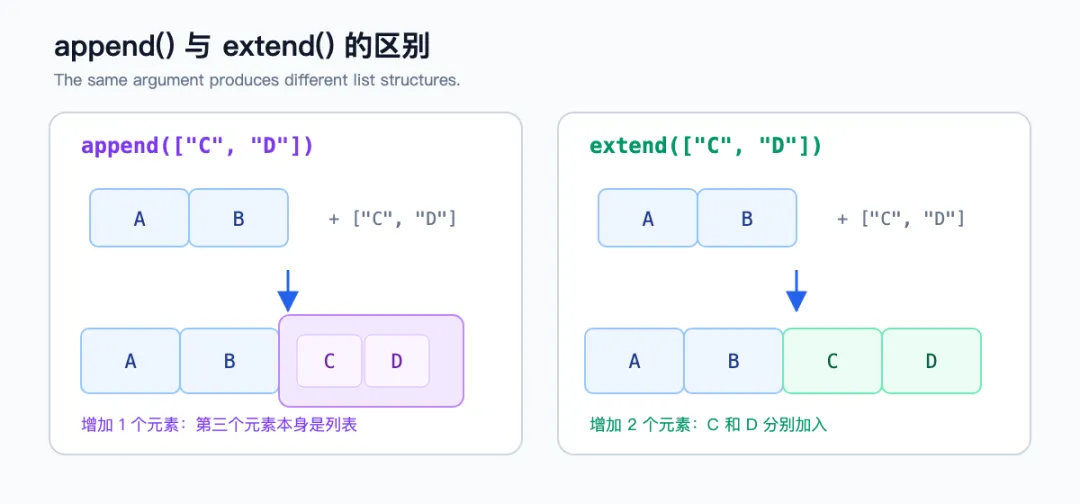
append() 和 extend() 的区别非常重要:
with_append = ["A", "B"]
with_append.append(["C", "D"])
print(with_append)  # ['A', 'B', ['C', 'D']]

with_extend = ["A", "B"]
with_extend.extend(["C", "D"])
print(with_extend)  # ['A', 'B', 'C', 'D']
前者添加了一个嵌套列表,后者添加了两个独立元素。
*append() 把参数作为一个整体添加,extend() 则逐个加入其中的元素。
3.3 在指定位置插入元素:insert()
insert(index, value) 在指定索引前插入一个元素,原位置及其后的元素会向后移动。
tasks = ["Read paper", "Write report"]
tasks.insert(1, "Clean data")

print(tasks)  # ['Read paper', 'Clean data', 'Write report']
频繁在长列表开头或中间插入元素会产生额外移动成本。如果需要大量从两端插入或删除数据,可以考虑 collections.deque。
3.4 删除元素:del、pop() 与 remove()
这三种方式的区别在于:是否按位置删除,以及是否需要继续使用被删除的值。
| | | |
|---|
del items[index] | | | |
items.pop(index) | | | |
items.remove(value) | | | |
tasks = ["Read paper", "Clean data", "Write report", "Archive files"]

del tasks[1]
finished = tasks.pop()
tasks.remove("Write report")

print(finished)  # Archive files
print(tasks)     # ['Read paper']
remove() 只删除第一个匹配值;如果目标值不存在,会抛出 ValueError,可以 if 是否存在再删除。
target = "Archive files"

if target in tasks:
    tasks.remove(target)
3.5 清空列表:clear()
clear() 删除所有元素,但保留原来的列表对象。
tasks = ["Read paper", "Clean data"]
tasks.clear()

print(tasks)  # []
4. 排序、反转与遍历
4.1 sorted():返回排序后的新列表
sorted() 不会修改原列表,而是返回一个新的排序结果。需要保留原顺序时优先使用它。
scores = [86, 92, 78]
ascending = sorted(scores)

print(scores)     # [86, 92, 78]
print(ascending)  # [78, 86, 92]
4.2 sort():直接修改原列表
sort() 在原列表上排序,没有返回新的列表。参数 reverse=True 表示降序排序。
scores = [86, 92, 78]
scores.sort(reverse=True)

print(scores)  # [92, 86, 78]
sort() 的返回值是 None,因此不要写成 sorted_scores = scores.sort()。
4.3 使用 key 指定排序规则
参数 key 接收一个函数。Python 会先用该函数计算每个元素的排序依据,再根据结果排序。
names = ["Mia", "Alexander", "Bo"]
by_length = sorted(names, key=len)

print(by_length)  # ['Bo', 'Mia', 'Alexander']
4.4 reverse():只反转当前顺序
reverse() 会原地反转列表,但不会按照数值或字母大小重新排序。
tasks = ["Read paper", "Clean data", "Write report"]
tasks.reverse()

print(tasks)  # ['Write report', 'Clean data', 'Read paper']
如果想保留原列表,可以使用切片 tasks[::-1] 创建反转后的副本。
4.5 使用 for 遍历列表
for 循环会按照列表顺序依次取出元素。循环体必须缩进,通常使用 4 个空格。
tasks = ["Read paper", "Clean data", "Write report"]

for task in tasks:
    print(f"Processing: {task}")
4.6 同时获取序号和元素:enumerate()
需要元素位置时,不必手动维护计数器,可以使用 enumerate()。参数 start=1 只改变显示编号,不改变列表真实索引。
tasks = ["Read paper", "Clean data", "Write report"]

for number, task in enumerate(tasks, start=1):
    print(f"{number}. {task}")
4.7 避免遍历时直接修改原列表
在遍历列表的同时添加或删除元素,可能导致元素被跳过或重复处理。更稳妥的方式是创建一个新列表。
numbers = [1, 2, 3, 4, 5]
odd_numbers = [number for number in numbers if number % 2 != 0]

print(odd_numbers)  # [1, 3, 5]
5. 生成与处理列表
5.1 使用 range() 生成整数序列
range(start, stop, step) 从 start 开始,在到达 stop 前结束,并按照 step 指定的步长生成整数。结束值不包含在结果中。
numbers = list(range(1, 6))          # [1, 2, 3, 4, 5]
even_numbers = list(range(2, 11, 2)) # [2, 4, 6, 8, 10]
countdown = list(range(5, 0, -1))    # [5, 4, 3, 2, 1]
只传入一个参数时,range(stop) 默认从 0 开始,步长为 1。
5.2 列表推导式
列表推导式用于根据一个可迭代对象快速创建新列表,基本结构如下:
[expression for item in iterable]
例如,生成 1 到 5 的平方:
squares = [number ** 2for number in range(1, 6)]
print(squares)  # [1, 4, 9, 16, 25]
5.3 在列表推导式中添加条件
在末尾加入 if 可以只保留符合条件的元素。
names = ["Mia", "Alexander", "Bo", "Sophia"]
long_names = [name for name in names if len(name) >= 5]

print(long_names)  # ['Alexander', 'Sophia']
列表推导式适合简单的转换和筛选。如果表达式包含多层条件或复杂逻辑,普通 for 循环通常更易读。
5.4 常用统计函数
len() 返回元素个数;数值列表还可以使用 min()、max() 和 sum()。
scores = [86, 92, 78]

print(len(scores))  # 3
print(min(scores))  # 78
print(max(scores))  # 92
print(sum(scores))  # 256

average = sum(scores) / len(scores)
print(average)      # 85.33333333333333
计算平均值前应确认列表不为空,否则会出现除以零错误。
if scores:
    average = sum(scores) / len(scores)
5.5 嵌套列表
列表可以包含其他列表。访问嵌套元素时,需要连续使用多个索引。
matrix = [
    [1, 2, 3],
    [4, 5, 6],
]

print(matrix[1])     # [4, 5, 6]
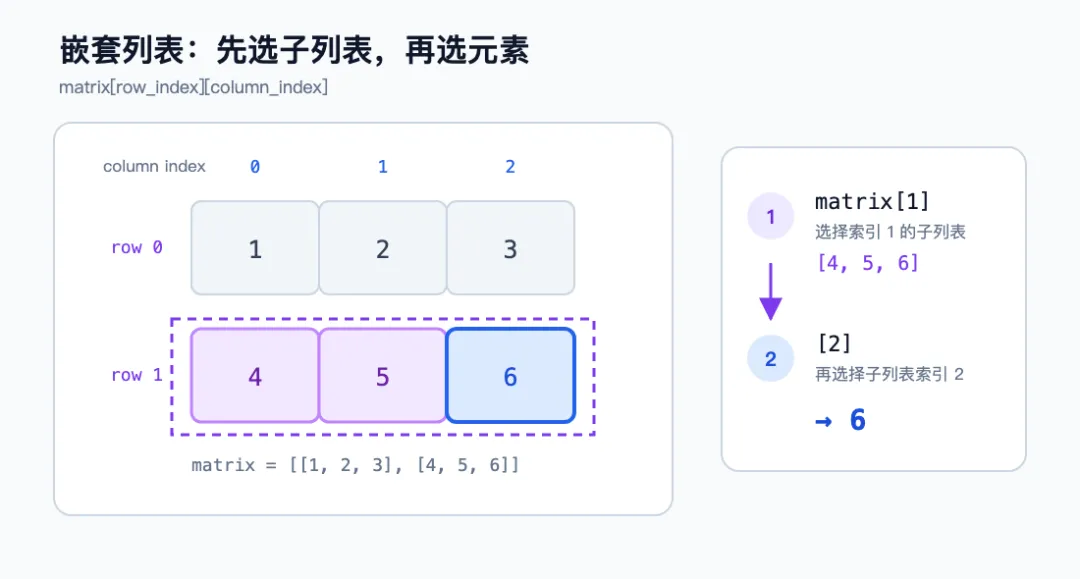
print(matrix[1][2])  # 6
matrix[1][2] 表示先读取索引 1 的子列表,再读取该子列表中索引 2 的元素。
第一次索引选择一行,第二次索引选择该行中的具体元素。
6. 复制列表与常见问题
6.1 直接赋值不会复制列表
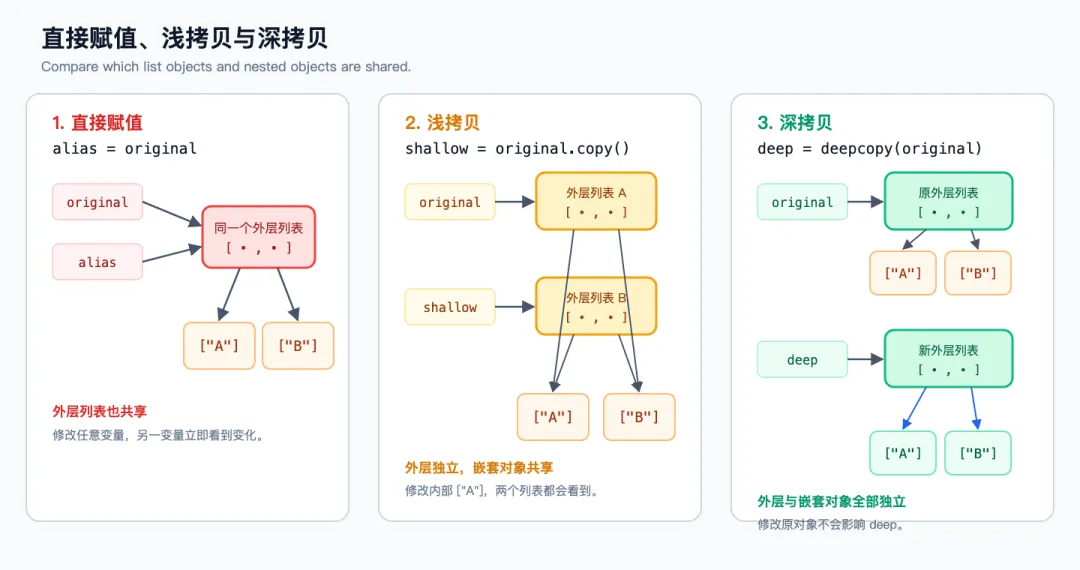
变量保存的是列表对象的引用。直接赋值后,两个变量会指向同一个列表,因此通过任意一个变量进行修改,另一个变量看到的内容也会变化。
original = ["Task A", "Task B"]
alias = original
alias.append("Task C")

print(original)  # ['Task A', 'Task B', 'Task C']
print(alias)     # ['Task A', 'Task B', 'Task C']
6.2 创建独立的浅拷贝
使用 .copy()、切片 [:] 或 list(original) 可以创建一个新的列表对象。
original = ["Task A", "Task B"]
copied = original.copy()
copied.append("Task C")

print(original)  # ['Task A', 'Task B']
print(copied)    # ['Task A', 'Task B', 'Task C']
6.3 浅拷贝与深拷贝
上述方法创建的是浅拷贝:外层列表已经独立,但嵌套的可变对象仍然共享。需要完全独立地复制嵌套对象时,可使用 copy.deepcopy()。
from copy import deepcopy

original = [["A"], ["B"]]
shallow = original.copy()
deep = deepcopy(original)

original[0].append("X")

print(shallow)  # [['A', 'X'], ['B']]
print(deep)     # [['A'], ['B']]
直接赋值共享同一个列表;浅拷贝只复制外层;深拷贝连嵌套对象也会独立复制。
浅拷贝只是创建一个新的外层列表,把原列表中各元素的引用复制过去。
original = [["A"], ["B"]]
copied = original.copy()

print(original is copied)        # False:外层列表不同
print(original[0] is copied[0])  # True:内层列表仍然共享
因此,修改外层结构不会互相影响:
copied.append(["C"])
copied[0] = ["New"]

print(original)  # [['A'], ['B']]
print(copied)    # [['New'], ['B'], ['C'], ['C']]
但修改共享的内层列表会互相影响:
copied = original.copy()
copied[0].append("X")

print(copied)    # [['A', 'X'], ['B']]
print(original)  # [['A', 'X'], ['B']]
6.4 常见错误与处理方法
| | |
|---|
IndexError | | |
ValueError | remove() | |
| | |
| 把 append()、sort() 等原地方法的返回值赋给变量 | |
| | |
原地修改方法通常返回 None:
tasks = ["Write report", "Clean data"]
result = tasks.sort()

print(result)  # None
print(tasks)   # ['Clean data', 'Write report']
6.5 编写清晰列表代码的建议
- 使用复数、含义明确的变量名,如
tasks、scores、sample_names。 - 简单转换或筛选可使用列表推导式,复杂逻辑优先使用普通循环。
- 选择方法前先判断:是否要修改原列表,是否需要被删除或排序后的返回值。
7. 常用操作速查
| |
|---|
| items = [] |
| items[index] |
| items[start:stop:step] |
| items[index] = value |
| items.append(value) |
| items.extend(values) |
| items.insert(index, value) |
| del items[index] |
| items.remove(value) |
| value in items |
| items.index(value) |
| items.sort() |
| items.reverse() |
| for item in items: |
| enumerate(items) |
| items.copy() |
 10个月宝宝每天需要喝多少奶粉?