面试前你背了一晚上 Java 并发和 JVM 调优,结果进去之后 CTO 问你:"你用过 transformers 吗?LoRA 和全量微调哪个更适合我们业务?"你当场想找个地缝钻进去——这不该是 Python 调包侠才要回答的问题吗?🤯
大家好,我是从 Java 后端转型 AI 技术经理的老兵。
今天聊聊一个特别扎心的话题:Python 调包侠,我到底该不该看不起他?
说实话,我 Java 写了 8 年,一度觉得写 Python 的就是"调包侠"——import 一下,三行代码跑个模型,能叫工程?
结果转型 AI 技术经理第一天,我发现自己连 transformers 都没装过,连 BERT 和 GPT 的参数规模都搞不清楚。人家那个我瞧不起的"调包侠",选型比我准、实验比我快、上线比我稳。
那一刻我悟了:在 AI 领域,会调包不是罪过,不会选型才是硬伤。 🎯
一、为什么 AI 技术经理必须拥抱 Python 生态?
先别急着反驳。我知道很多后端同学心里想的是:
"Java 不香吗?Spring Boot 一套多稳。Python 那弱类型、GIL、性能拉胯……"
兄弟,这话我对镜子说过一百遍。但现实是:
| 维度 |
Java 后端生态 |
Python AI 生态 |
| 核心能力 |
高并发、事务、稳定 |
模型训练、实验迭代、数据探索 |
| 工程框架 |
Spring / MyBatis / Dubbo |
PyTorch / Transformers / LangChain |
| 迭代速度 |
天级别 |
小时级别 |
| 人才密度 |
业务后端多 |
AI 算法/工程基本全栈 Python |
| 部署形态 |
服务化、微服务 |
模型推理、GPU 服务、Pipeline |
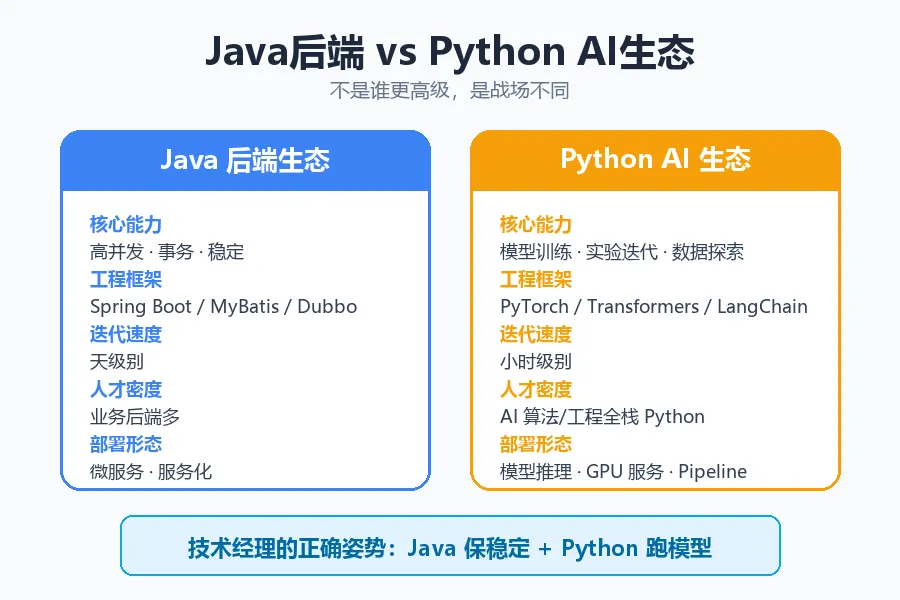
看明白了吗?不是 Python 比 Java 高级,是 AI 这个战场,Python 就是事实标准。 你可以不喜欢,但你转型的时候绕不过去。
我现在的做法是:核心服务用 Java 保稳定,AI Pipeline 用 Python 跑模型。 两边通过 gRPC/HTTP 对接,各干各擅长的。这叫"认怂但务实"。😏
二、Python AI 技术栈,一张图告诉你该学啥
很多后端转 AI 的同学,一打开 GitHub 就懵了:
PyTorch、Hugging Face、LangChain、LlamaIndex、FastAPI、ONNX、vLLM、Triton……这都是啥?从哪开始?
别慌,我帮你分层整理好了:
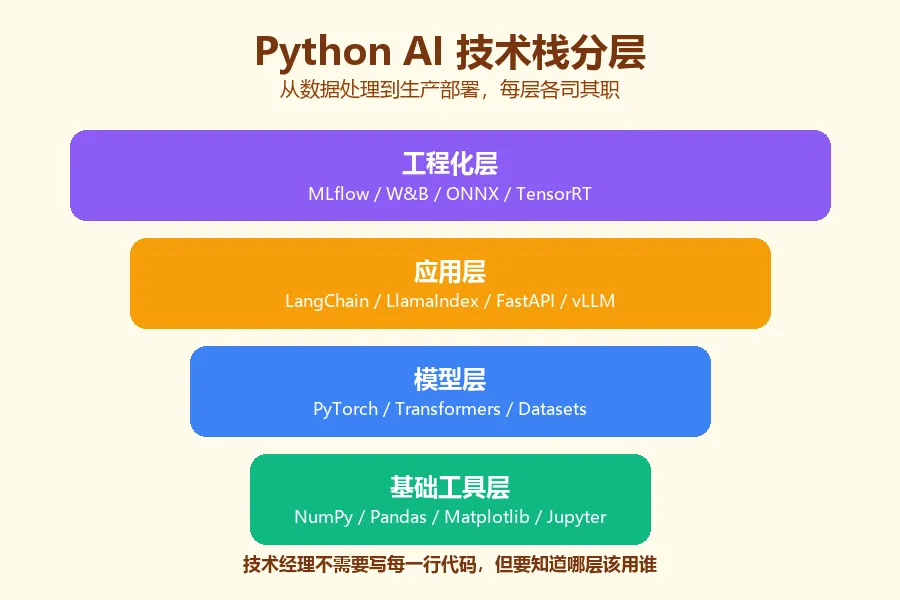
第一层:基础工具层
NumPy / Pandas:数据处理,类似 Java 里的 Stream + 内存表Matplotlib / Seaborn:画图,做实验报告必备Jupyter Notebook:交互式实验,比 IDEA Debug 还方便(真的)
第二层:模型层
PyTorch / TensorFlow:深度学习框架,建议直接学 PyTorchTransformers(Hugging Face):大模型/预训练模型的"Maven 仓库"
第三层:应用层
LangChain / LlamaIndex:RAG、Agent 编排FastAPI:模型服务化,比 Flask 更适合生产
第四层:工程化层
MLflow / Weights & Biases:实验管理
作为技术经理,你不需要每一行代码都自己写,但你要知道:什么场景该用哪个工具、团队里谁该负责哪一层。
三、模型选型实战:任务 → 模型 → 成本 → 上线
好,工具知道了,那模型怎么选?
这是技术经理最容易被挑战的点。业务方张口就是"我们要 GPT-4 的效果",老板一问"成本多少"你就开始冒汗。😅
我总结了一个四步选型法:
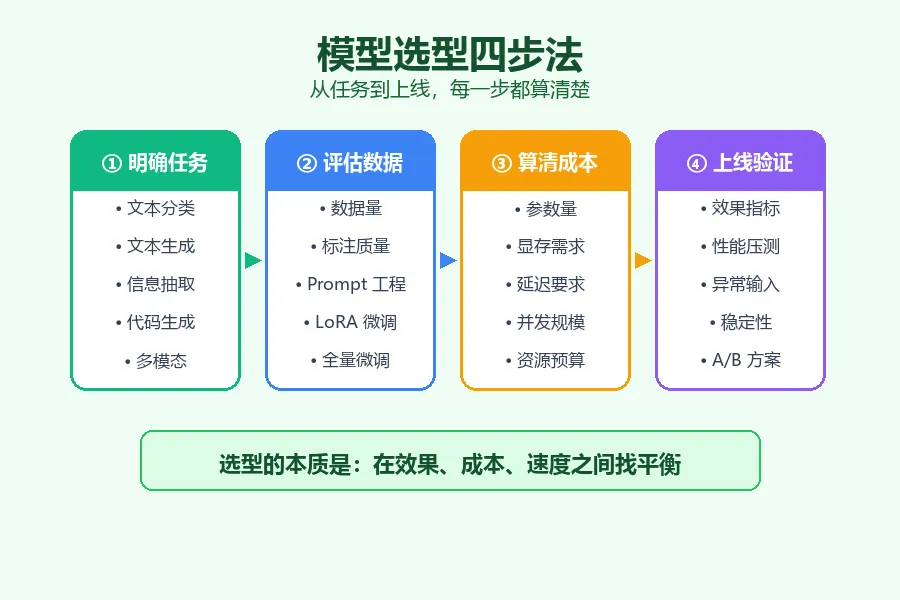
Step 1:明确任务类型
不同任务,适合的模型完全不同:
| 任务类型 |
推荐方向 |
代表模型 |
| 文本分类/情感分析 |
小模型即可 |
BERT-base、RoBERTa、TextCNN |
| 文本生成/问答 |
生成式大模型 |
Qwen、ChatGLM、Llama |
| 信息抽取 |
Encoder 或轻量大模型 |
UIE、BERT-CRF |
| 代码生成 |
代码大模型 |
CodeQwen、CodeLlama、DeepSeek-Coder |
| 多模态 |
视觉语言模型 |
Qwen-VL、LLaVA |
Step 2:看数据量和标注成本
- 数据少 + 没标注:优先 Prompt 工程 + 上下文学习
- 数据少 + 有标注:尝试 LoRA/QLoRA 微调
Step 3:评估部署成本
这一步是后端同学最该擅长的。来算笔账:
# 一个 7B 模型 FP16 推理需要多少显存?
params = 7e9          # 70 亿参数
bytes_per_param = 2   # FP16 = 2 字节
model_memory = params * bytes_per_param / 1024**3  # ≈ 13 GB

# 加上 KV Cache、激活值、框架开销,实际约 16-20 GB
# 所以 7B 模型单卡 A10(24GB) 能跑,但 13B 就悬了
| 模型规模 |
FP16 推理显存 |
适合部署 |
| 1B-3B |
4-8 GB |
CPU/边缘设备 |
| 7B |
14-20 GB |
单卡 A10 / RTX 4090 |
| 13B |
26-35 GB |
单卡 A100 40GB |
| 70B |
130-180 GB |
多卡 A100 / H100 |
Step 4:上线前必须做的验证
- 性能验证:TPS、首 token 延迟、端到端延迟
- 成本验证:单日 Token 量 × 单价 / 折旧成本
四、Java 老兵写 AI vs Python 调包侠:代码对比
来,看个真实的对比。同样是调用一个文本分类模型:
Java 思路(如果你硬要写):
// 你得自己封装 ONNX Runtime,自己处理 tokenizer
// 自己拼 input_ids、attention_mask、token_type_ids
// 自己解析 logits,自己写 softmax
// 100 行过去了,模型还未必跑得起来
Python 调包侠思路:
from transformers import pipeline

classifier = pipeline("sentiment-analysis", model="distilbert-base-uncased")
result = classifier("这家产品体验太棒了!")
print(result)
# [{'label': 'POSITIVE', 'score': 0.998}]
三行。完事。🎯
你说这不算工程?我承认,生产环境不能直接这么写。但实验阶段、POC 阶段、选型阶段,三行代码顶你三小时。
而且现在的 transformers 生态已经高度工程化,部署可以这样:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

model_name = "Qwen/Qwen2-7B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_name)

messages = [{"role": "user", "content": "写一个冒泡排序"}]
text = tokenizer.apply_chat_template(messages, tokenize=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
看到没?Device map 自动分配、Chat Template 自动处理、生成逻辑标准化——这不是"调包",是生态成熟。
五、技术经理的模型选型 Checklist
最后送你一张我贴在工位上的速查卡:
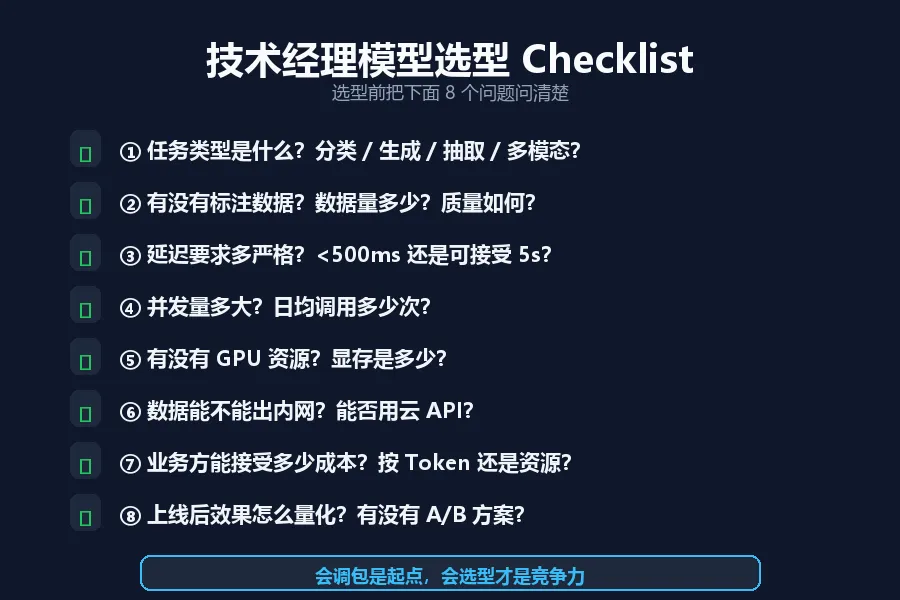
✅ 选型前必问 8 个问题:
- 业务方能接受多少成本?按 Token 还是按资源?
这 8 个问题问完,你心里基本就有答案了。
写在最后
说实话,我到现在还是觉得 Java 写起来更踏实。但转型 AI 技术经理这一年,我学会了:技术经理的价值不是写最多的代码,而是做最对的选型。
那个你瞧不起的"Python 调包侠",也许不懂线程池、不懂分布式事务,但他知道哪个模型在你 8GB 显存的机器上能跑起来、哪个 LoRA 配置能让你的业务 F1 提升 5 个点。
在 AI 这个领域,会调包是起点,会选型才是竞争力。 🚀
下一期,我们聊聊更刺激的话题:第一次做 AI 架构评审,被 CTO 问 GPU 显存怎么算。不见不散!
 10个月宝宝每天需要喝多少奶粉?