一、多线程解决不了所有慢,多进程就是另一条路
上一章讲多线程时,我们反复强调过一句话: 线程更适合等待型任务,比如网络请求、文件读写、数据库访问。
那如果程序不是在等,而是在拼命算呢。
比如:
大批量数据统计 复杂数学运算 图片逐像素处理 视频转码 密码穷举 模型训练前的数据预处理
这种任务的特点是,CPU 一直很忙,程序几乎没有停下来等谁。它慢,不是因为外部响应太慢,而是因为计算本身就很重。
这时候,很多人会很自然地想到: 那我再多开几个线程,不就能同时算得更快了吗。
实际中,往往没那么理想。因为纯计算任务最需要的是更多真正的计算资源,而不是只把任务表面上拆开。也正因为这样,多进程就登场了。
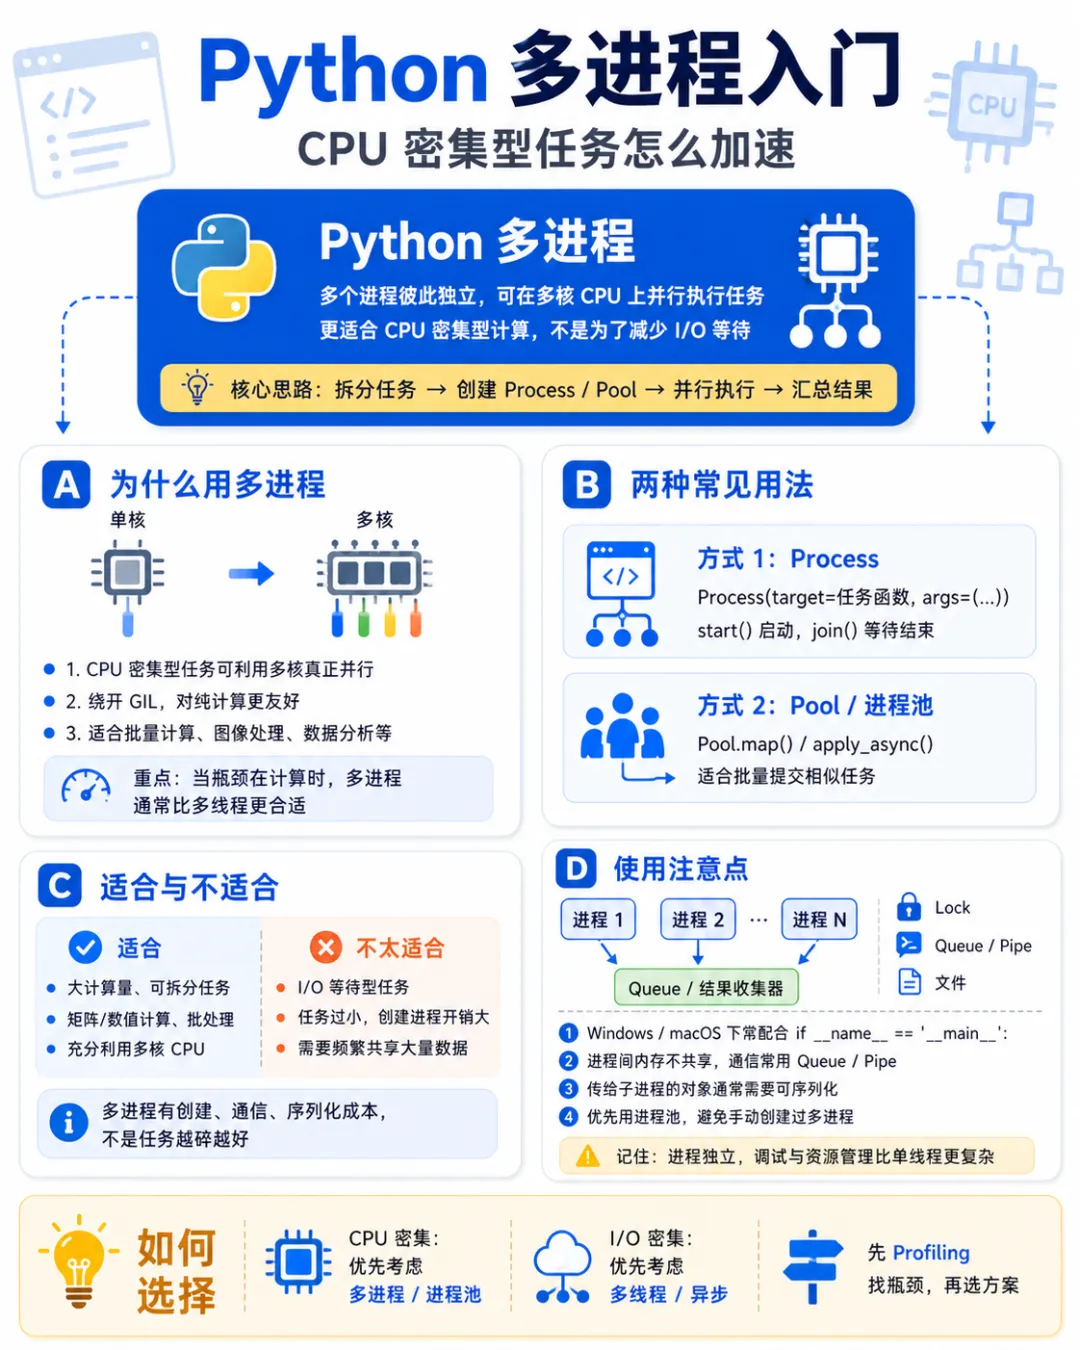
如果说多线程更像一个程序里安排多个工人轮流处理任务,那么多进程更像直接再开几间独立的工厂,让每间工厂各干各的活。
它的目标很明确: 把原本压在一个 CPU 执行流上的重计算任务,拆给多个进程去做,争取真正利用多核能力。
二、什么是进程
先把最基础的概念讲清楚。
你平时打开一个浏览器、一个聊天软件、一个编辑器,它们在操作系统里通常都对应一个个独立运行的进程。
所以,进程可以简单理解为: 一个正在运行的程序实例。
线程是在进程内部执行任务的。 进程则是更外层的运行单位。
你可以这样记:
进程像一套独立房子 线程像房子里干活的人
同一套房子里的工人,共享很多资源。 不同房子之间,相对独立,互不打扰。
这也是多进程和多线程一个非常关键的区别:
线程之间共享同一个进程的资源 进程之间默认是彼此隔离的
这种隔离一方面让进程之间通信更麻烦,另一方面也让它们更适合做真正独立的重任务。
三、为什么多进程特别适合 CPU 密集型任务
因为 CPU 密集型任务最缺的,不是等待时间,而是真正的计算能力。
想象一下,你要处理 4000 张图片,并且每张图片都要做复杂运算。 如果只靠一个执行流,那它只能一张接一张处理。 如果你电脑有 4 个核心,而你只用了一个,那另外 3 个核心其实很闲。
这时,多进程的思路就是:
把任务拆成几份 交给多个进程分别处理 让多个核心尽量同时干活
比如 4000 张图片,可以拆成 4 份,每个进程处理 1000 张。 理论上,只要任务拆得合理,整体耗时就有机会明显下降。
注意,这里强调的是有机会。 不是所有场景都一定线性提速,因为还会有进程创建、数据传输、任务调度这些成本。但对很多重计算任务来说,多进程确实是非常重要的加速手段。
四、先感受一下单进程计算为什么慢
先看一个最基础的例子:
defwork(): total = 0for i in range(100000000): total += i print(total)work()
这段代码逻辑很简单,就是不断累加。 问题在于它全程都在计算,没有任何真正有价值的等待阶段。
如果你把循环次数继续放大,运行时间会越来越明显。 这就是典型的 CPU 密集型任务。
这种任务里,瓶颈就是计算本身。 所以优化方向不是让它少等,而是想办法让更多计算单元一起参与。
五、多进程最核心的想法:任务拆分
多进程不是魔法,它本质上就是把一个大任务拆成多个小任务。
比如原本有一整块工作:
统计 1 到 4 亿之间所有数字的某种结果
你可以拆成:
进程1处理 1 到 1亿 进程2处理 1亿到 2亿 进程3处理 2亿到 3亿 进程4处理 3亿到 4亿
等每个进程都算完,再把结果汇总起来。
所以,多进程有没有价值,很大程度上取决于一个任务是否适合拆分。
适合拆分的任务,通常有这些特点:
每部分计算相对独立 中间不需要频繁互相依赖 最后只需要合并结果 单个子任务足够重,值得为它开一个进程
如果任务本身拆不开,或者拆开以后要频繁通信,那多进程的收益就会下降很多。
六、Python 里做多进程,用 multiprocessing 模块
Python 标准库里专门用于多进程开发的模块,叫 multiprocessing。
它的定位非常明确: 提供和 threading 类似的使用风格,但底层是进程,不是线程。
这点对初学者很友好。因为你刚学完线程,再学进程时,会发现两者写法有不少相似之处。
最基础的导入方式:
import multiprocessing
你可以先把它当成另一个任务调度工具箱。 创建进程、启动进程、等待进程结束、进程间通信,后面都会靠它完成。
这一章先把最基础的用法吃透。
七、创建一个最简单的进程
先看最小示例:
import multiprocessingimport timedeftask(): print("子进程开始执行") time.sleep(2) print("子进程执行结束")if __name__ == "__main__": p = multiprocessing.Process(target=task) p.start() p.join() print("主进程执行结束")
这里面最关键的几个点要看清。
multiprocessing.Process() 用来创建进程对象。target=task 表示子进程要执行的函数。start() 表示启动进程。join() 表示等待进程结束。
你会发现,这套结构和线程特别像。 所以刚接触时,理解成本并不高。
但这里有一个你必须重视的细节:if __name__ == "__main__":
这不是可有可无的装饰,而是多进程代码里非常重要的一道保护。
八、为什么多进程几乎总要写 if name == "main"
这个问题新手特别容易忽略。
在多进程环境下,尤其是在某些操作系统里,启动子进程时会重新导入当前模块。如果你把创建进程的代码直接写在最外层,子进程一导入这个文件,就可能再次执行创建进程的语句,于是不断重复,程序就容易乱掉。
所以规范写法通常都是:
if __name__ == "__main__":# 创建并启动进程
你可以把它理解成一道安全门。 只有当前文件被直接运行时,才执行这里面的代码。 如果是被别的进程导入,就不会重复乱跑。
今后你写多进程程序,基本都应该养成这个习惯。 哪怕暂时还没完全理解底层原因,也先按规范来写。
九、给进程传参数
和线程一样,进程执行的函数通常也要带参数。
看例子:
import multiprocessingimport timedeftask(name, seconds): print(f"{name} 开始执行") time.sleep(seconds) print(f"{name} 执行结束")if __name__ == "__main__": p = multiprocessing.Process(target=task, args=("任务A", 2)) p.start() p.join()
这里的 args 依然是元组形式。 一个参数时,也同样要注意逗号。
args=("任务A",)
这一点和线程完全一致。
所以在传参层面,你可以沿用前面学线程时的理解,不需要重新建立一套体系。
十、一次启动多个进程,才更能体现多进程价值
单开一个进程,只能帮助你理解语法。 真正体现多进程意义的,往往是多个进程一起干活。
看一个基础例子:
import multiprocessingimport timedeftask(name): print(f"{name} 开始") time.sleep(2) print(f"{name} 结束")if __name__ == "__main__": p1 = multiprocessing.Process(target=task, args=("进程1",)) p2 = multiprocessing.Process(target=task, args=("进程2",)) p3 = multiprocessing.Process(target=task, args=("进程3",)) p1.start() p2.start() p3.start() p1.join() p2.join() p3.join() print("所有进程执行完毕")
这个例子虽然用的是 sleep,更像等待型任务,但它能让你先感受到多个进程并行推进的基本结构。
真正到了 CPU 密集型场景时,思路也是一样的: 先拆任务 再分配给多个进程 最后等待结果并汇总
十一、用多进程处理计算任务的一个直观例子
下面看一个更贴近 CPU 密集型任务的例子。 假设我们要计算一大段数字的和,可以把它切成几段分别处理。
import multiprocessingimport timedefcompute(start, end): total = 0for i in range(start, end): total += i print(f"{start} 到 {end} 的计算完成,结果是 {total}")if __name__ == "__main__": start_time = time.time() p1 = multiprocessing.Process(target=compute, args=(0, 25000000)) p2 = multiprocessing.Process(target=compute, args=(25000000, 50000000)) p3 = multiprocessing.Process(target=compute, args=(50000000, 75000000)) p4 = multiprocessing.Process(target=compute, args=(75000000, 100000000)) p1.start() p2.start() p3.start() p4.start() p1.join() p2.join() p3.join() p4.join() print("总耗时:", time.time() - start_time)
这个程序的重点不在打印结果,而在理解拆分思想。
原来一个进程要独自完成全部计算。 现在拆成了四段,交给四个进程分别完成。
如果你的机器有多个核心,而且任务足够重,就有可能看到比较明显的提速效果。
十二、多进程为什么不适合轻量小任务
这也是非常重要的一点。
很多人一学会多进程,就会想:
那以后我干脆什么都开进程,不就更快了吗。
错。
进程不是没有成本的。 创建进程、分配资源、拷贝环境、调度运行,这些都要花时间。
如果你的任务本身非常轻,比如每个任务只算几毫秒,那你还没真正开始干活,进程创建的成本可能已经不低了。
这就像你为了搬一本书,专门叫四辆卡车来拉。 排场很大,但不划算。
所以多进程更适合什么任务? 答案是:足够重、足够独立、值得拆开的任务。
如果任务又小又碎,反而可能越拆越慢。
十三、多进程和多线程最核心的区别
学到这里,最好把二者放在一起做一次对照。
1. 资源关系不同
线程共享同一进程里的资源。 进程彼此独立,默认不共享内存空间。
这意味着线程通信更方便,但也更容易因为共享数据产生冲突。 进程更隔离、更安全,但通信更麻烦。
2. 适用场景不同
线程更适合 I/O 密集型任务。 进程更适合 CPU 密集型任务。
这不是绝对死规则,但作为入门阶段的判断原则,非常实用。
3. 创建成本不同
线程通常更轻。 进程通常更重。
所以不是能开进程就一定划算,得看任务值不值得。
4. 稳定性影响不同
一个线程出问题,可能影响整个进程。 一个子进程崩了,通常不会直接把别的进程一起带崩。
这也是很多高可靠系统喜欢通过进程隔离任务的原因之一。
十四、进程之间为什么不能直接共享普通变量
这是新手特别容易误解的地方。
看线程时,我们知道多个线程可以访问同一个全局变量。 很多人会下意识以为,多个进程也一样。
其实不一样。
看这个例子:
import multiprocessingcount = 0deftask():global count count += 1 print("子进程中的 count =", count)if __name__ == "__main__": p = multiprocessing.Process(target=task) p.start() p.join() print("主进程中的 count =", count)
很多人会以为最后主进程里的 count 会变成 1。 但实际通常不会。
因为子进程操作的是它自己那份独立数据,不是主进程里的原始变量。 进程之间默认是隔离的。
这件事一定要先建立认知。 不然后面你会在进程通信、结果汇总时反复踩坑。
这一章先不展开通信细节,后面会讲 Queue、Pipe 等工具。 你现在只要先记住: 进程之间默认不共享普通变量。
十五、为什么说多进程更像多人分工,而不是多人抢一张桌子
这个比喻特别适合理解线程和进程。
多线程更像几个人围着同一张桌子干活。 桌上的资料、工具、纸张都能一起用,所以协作方便,但也容易抢来抢去。
多进程更像每个人分到一个独立房间。 每个人有自己的桌子和材料,互不打扰,但如果你想交换信息,就得额外沟通。
所以进程的优势是独立。 线程的优势是轻便。
什么时候选哪一个,不是看谁更高级,而是看你的任务更像哪种工作方式。
十六、如何查看当前进程信息
写多进程程序时,常常会想知道:
现在到底是主进程在跑 还是某个子进程在跑
这时可以用:
multiprocessing.current_process()
看例子:
import multiprocessingdeftask(): print("当前子进程:", multiprocessing.current_process().name)if __name__ == "__main__": print("当前主进程:", multiprocessing.current_process().name) p = multiprocessing.Process(target=task, name="计算进程") p.start() p.join()
给进程命名后,调试会更直观。
你会看到主进程和子进程名称不同。 这对日志分析、排错、确认任务分配都很有帮助。
十七、daemon 守护进程要谨慎使用
和线程一样,进程也能设置为守护进程。 守护进程的特点是,当主进程结束时,它也会跟着被结束。
示例:
import multiprocessingimport timedeftask():for i in range(5): print("守护进程运行中") time.sleep(1)if __name__ == "__main__": p = multiprocessing.Process(target=task, daemon=True) p.start() time.sleep(2) print("主进程结束")
这类写法适合做一些辅助性后台任务。 但和守护线程一样,涉及关键数据处理时不要乱用。
因为主进程一结束,它可能就被直接中断,来不及把事情做完。
十八、一个更贴近实战的小案例:批量计算列表平方和
下面写一个小案例,把多进程的思路再落地一点。
假设有一大批数字,要计算平方后求和。我们把数据切成几段,分别让多个进程处理。
import multiprocessingimport timedefpartial_sum(numbers): total = 0for n in numbers: total += n * n print(f"部分结果:{total}")if __name__ == "__main__": numbers = list(range(1, 10000001)) chunk_size = len(numbers) // 4 chunks = [ numbers[0:chunk_size], numbers[chunk_size:chunk_size * 2], numbers[chunk_size * 2:chunk_size * 3], numbers[chunk_size * 3:] ] processes = [] start_time = time.time()for index, chunk in enumerate(chunks, start=1): p = multiprocessing.Process(target=partial_sum, args=(chunk,), name=f"计算进程{index}") processes.append(p) p.start()for p in processes: p.join() print("总耗时:", time.time() - start_time)
这个例子的重点不是最终结果有没有汇总,而是让你直观看到:
大任务可以先切块 每块交给一个进程 多个进程独立处理 最后等待全部完成
后面讲进程间通信时,就可以把这些部分结果进一步收集回来合并。
十九、多进程提速时,真正要注意的三个判断
学到这里,你不能只记住语法,还要记住判断逻辑。
1. 任务是不是 CPU 密集型
如果任务主要在算,多进程很值得考虑。 如果主要在等,优先考虑线程或协程。
2. 任务能不能拆
如果任务天然可以拆成多个独立部分,多进程会更顺手。 如果任务之间依赖很强,就没那么适合。
3. 任务够不够重
如果单个任务太轻,多进程的创建和调度成本可能盖过收益。 任务越重,多进程的优势通常越容易体现。
很多优化失败,不是因为技术不会,而是因为判断错了场景。
二十、什么时候你应该优先想到多进程
下面这些场景,你可以优先联想到多进程:
批量图片处理 批量视频转码 复杂数值计算 数据分析中的重运算 大规模文本统计 需要充分利用多核 CPU 的任务
这些任务通常都有两个特点: 算得多 彼此相对独立
这正是多进程最擅长的地方。
二十一、什么时候不该急着上多进程
下面这些情况,先别一上来就用多进程:
网络请求慢 数据库响应慢 文件读取慢 任务本身很轻 步骤之间强依赖 还没定位瓶颈
如果程序慢的原因其实是网络、磁盘或者数据库,那你多开进程,可能并不能解决根本问题。 这也是为什么我们一直强调: 先判断瓶颈,再选工具。
二十二、入门阶段最容易踩的坑
1. 忘写 if name == "main"
这是多进程最常见的坑之一。 不写可能直接导致程序行为异常,尤其在某些系统环境下更明显。
2. 以为进程和线程一样能直接共享全局变量
进程之间默认不共享普通变量,这一点必须牢牢记住。
3. 任务太小还硬拆进程
轻量任务开太多进程,收益很可能不如串行执行。
4. 只会开进程,不会汇总结果
多进程只是把任务拆开,真正做项目时,往往还要把子进程结果收回来。 这部分后面会专门展开讲。
5. 以为进程越多越好
进程数不是越多越快。 你的 CPU 核心数、内存大小、任务类型,都会影响最优数量。
二十三、本章代码骨架,建议先记熟
先把最常见的多进程模板记下来:
import multiprocessingdefworker(arg): print(f"开始处理 {arg}") print(f"处理完成 {arg}")if __name__ == "__main__": processes = []for item in ["任务1", "任务2", "任务3"]: p = multiprocessing.Process(target=worker, args=(item,)) processes.append(p) p.start()for p in processes: p.join() print("全部任务完成")
这个模板很重要。 以后你无论换成计算任务、图片任务、批处理任务,整体结构基本都还是这一套。
二十四、练习题
写一个单进程版本的大循环累加程序,记录耗时。再把任务拆成 4 段,用 4 个进程处理,对比时间差异。
写一个程序,启动 3 个进程,分别打印不同任务名和当前进程名。
尝试在子进程里修改全局变量,然后在主进程里打印这个变量,观察结果,理解进程隔离。
把一组数字切成几份,每个进程负责统计一部分和,先不要求汇总,只要求看懂拆分思路。
把创建进程的代码故意写到 if __name__ == "__main__" 外面,观察或查阅原因,理解为什么规范写法很重要。
二十五、本章要点整理
进程是正在运行的程序实例,比线程更外层。 多进程特别适合 CPU 密集型任务,因为它更适合利用多核能力。 Python 中创建进程主要使用 multiprocessing 模块。 创建进程用 Process,启动用 start(),等待结束用 join()。 多进程代码通常必须写在 if __name__ == "__main__" 保护下。 进程之间默认是隔离的,不能直接依赖普通全局变量共享数据。 多进程不是越多越快,任务是否够重、是否能拆分,才是关键。
 10个月宝宝每天需要喝多少奶粉?