编排可控、协作效率,还是生产可维护?
官方 SDK(OpenAI / Claude / Google)常有 Python 包,但选型逻辑是厂商绑定,归「其他」,本篇不展开。
一、先看地图
| | | |
|---|
| | StateGraph / plan-reflect | |
| | team + permission + sandbox | |
| | | |
| PydanticAI、Letta、LlamaIndex、Haystack | | |
| | | |
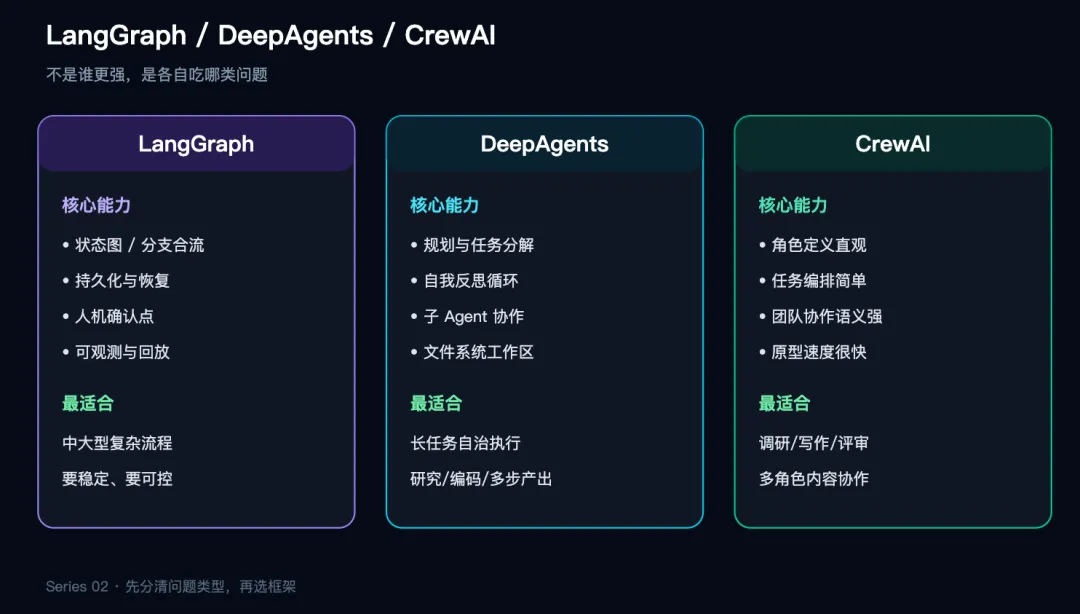
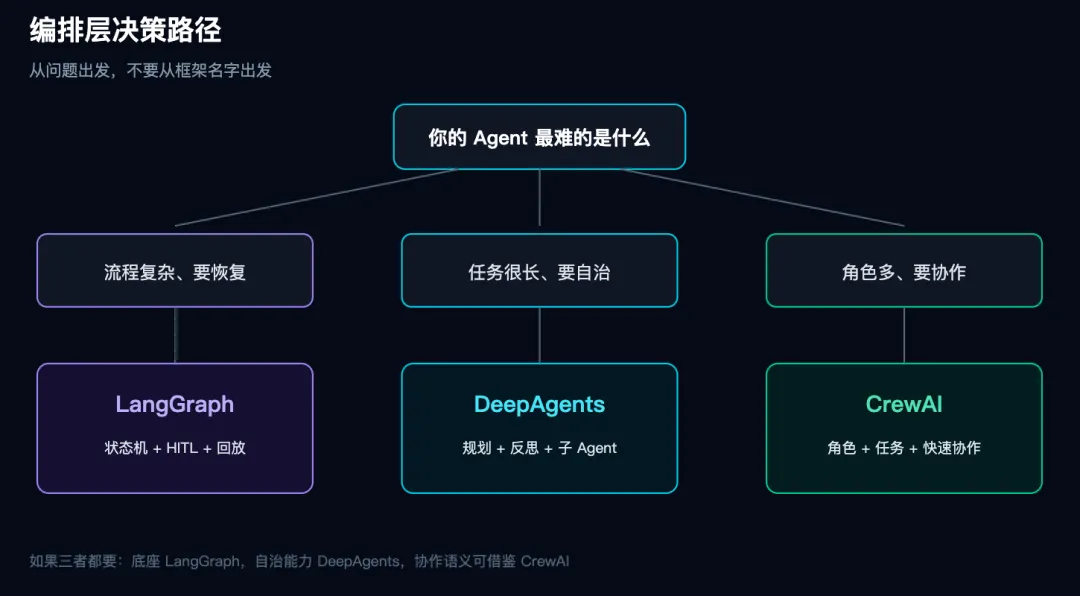
二、重编排:LangGraph vs DeepAgents
LangGraph:把流程收成状态图
它解决的不是“模型更会聊”,而是:
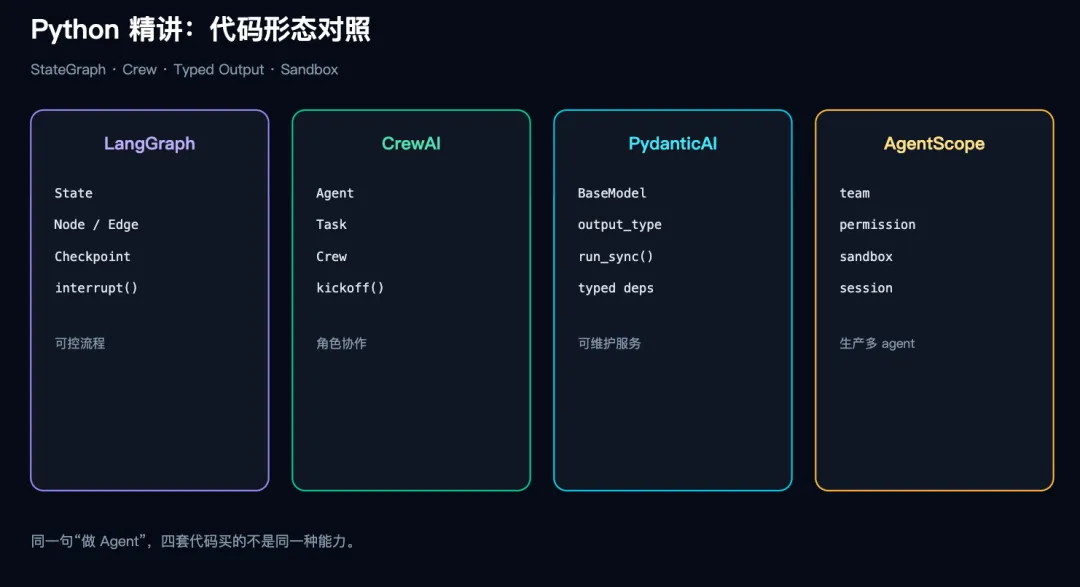
最小形态大致是这样:
from typing import TypedDict, Annotatedfrom langgraph.graph import StateGraph, ENDfrom langgraph.checkpoint.memory import MemorySaverclass State(TypedDict): query: str draft: str approved: booldef research(state: State) -> dict: return {"draft": f"research({state['query']})"}def review(state: State) -> dict: # 真实项目里常配合 interrupt / HITL return {"approved": "风险" not in state["draft"]}def route(state: State) -> str: return "publish" if state["approved"] else "research"g = StateGraph(State)g.add_node("research", research)g.add_node("review", review)g.add_node("publish", lambda s: s)g.set_entry_point("research")g.add_edge("research", "review")g.add_conditional_edges("review", route, {"publish": "publish", "research": "research"})g.add_edge("publish", END)app = g.compile(checkpointer=MemorySaver())app.invoke( {"query": "Q2 复盘", "draft": "", "approved": False}, config={"configurable": {"thread_id": "t-001"}},)
你真正买到的
优
劣
适合:审批流、多系统串联、要断点恢复不适合:还没验证价值就先上重架子
社区两极很稳:生产派夸“能管住”,出活派骂“太重”。
DeepAgents:长任务自治加强层
路径不固定、要 plan → act → reflect 时,它更贴。
goal → plan → sub-agent / tools / workspace → reflect → continue or stop
优:少写大量规划胶水劣:较新;自治越强,边界和权限越要写死和 LangGraph:更像组合/加强,不是简单宣布后者过时
三、多 Agent 生产:AgentScope
若痛点是「多 agent 还要能看懂、能控、能隔离」,AgentScope 比纯角色框架更靠生产议题:
AgentScope 更关心:who can call which toolwhere code runs (sandbox)how session is isolatedhow run is inspected
优:权限、沙箱、会话这些生产面更正面劣:不是 StateGraph 那套心智,要重新适应适合:可控多 agent 应用同类可提:MetaGPT / CAMEL(研究/组织模拟向,工程默认底座要谨慎)
四、重协作:CrewAI vs AutoGen
CrewAI:角色语义最快
自然语言已经是“谁查、谁写、谁审”时,它通常比一上来画状态机顺。
from crewai import Agent, Task, Crew, Processresearcher = Agent( role="研究员", goal="收集可引用的事实", backstory="偏证据,不空泛", verbose=True,)writer = Agent( role="写作者", goal="把材料写成短文", backstory="结构清楚,少废话",)t1 = Task(description="调研主题 X 的争议点", agent=researcher)t2 = Task(description="基于调研写 800 字综述", agent=writer)crew = Crew( agents=[researcher, writer], tasks=[t1, t2], process=Process.sequential,)result = crew.kickoff()
和 LangGraph 的差别
优:原型快劣:细控、复杂恢复、强审计通常不是强项误区:把前期的“快”当成后期的“稳”
AutoGen:先验证“群聊有没有用”
UserProxy ↔ Assistant ↔ Critic conversational multi-agent
优:对话协作、任务分解试验强劣:热闹不等于收敛;生产治理一般适合:研究验证、对话本身就是产品形态不适合:已明确要强状态、强恢复
五、生产 / 记忆 / 数据
PydanticAI:先让代码养得住
from pydantic import BaseModelfrom pydantic_ai import Agentclass Answer(BaseModel): title: str points: list[str] confidence: floatagent = Agent( "openai:gpt-4.1", output_type=Answer, system_prompt="只输出结构化结论,不写套话",)result = agent.run_sync("用三点总结 RAG 的主要风险")print(result.output.points)
买的是:typed deps、structured output、可维护服务代码不是:最热闹的 multi-agent 表演
Letta:长期记忆 runtime
message → memory blocks / recall → agent state persists
长记忆不是“多塞 context”。适合会话很长、状态要沉淀;不是通用 graph 编排器。
LlamaIndex / Haystack
主矛盾是文档怎么切、怎么取、取完怎么行动时,先看它们。
LlamaIndex: index / retriever / query engine / agent toolHaystack: component / pipeline / production RAG orchestration
业务状态机很重时,它们未必是最优底座。
六、轻量:Agno / smolagents
快、轻、适合打样。复杂治理、长期编排通常不是主场。
原则就一句:
轻量证明价值,重框架承接复杂度。别反过来。
七、怎么选
- 多 agent 还要权限沙箱 → AgentScope
- 文档/RAG 驱动 → LlamaIndex / Haystack
- 还在验证想法 → Agno / smolagents
- 已绑定某厂商只想快接 → 去「其他」看官方 SDK
多条同时成立很常见:选一个主底座扛主约束,别并行上三套完整哲学。
八、对照表
九、我怎么用
两种最常见浪费:该快时选太重;该稳时还赖在原型框架上。
下一篇:Java 和其他解决方案。
 10个月宝宝每天需要喝多少奶粉?