🏭 那一次连接失败,让我重新认识了工业通信
在一个自动化产线改造项目里,我第一次尝试用Python直接读取西门子S7-1200的数据块。环境搭好了,代码写好了,运行——连接超时。改端口,改IP,重启PLC,折腾了整整一个下午,最后发现是PLC侧的PUT/GET访问没有开启。
这个坑,很多人都踩过。
工业现场的Python开发,跟写个爬虫、搞个数据分析完全是两个世界。西门子PLC的S7协议有自己的一套通信逻辑,不了解底层机制,光靠"试"是很难跑通的。
这篇文章,咱们就把这件事从头捋清楚:S7协议是什么、python-snap7怎么用、数据块怎么读写、常见坑怎么绕。读完你能拿走:
🔍 问题深度剖析:S7通信为什么"难搞"
协议本身的封闭性
S7协议(也叫S7comm)是西门子专有的工业通信协议,运行在TCP/IP之上,默认端口102,底层使用ISO-on-TCP(RFC 1006)封装。它不像Modbus那样完全开放、文档详尽,官方从未公开完整规范,现有的第三方实现(包括snap7)都是通过逆向工程和社区积累得来的。
这意味着什么?协议行为在不同PLC型号、不同固件版本之间存在差异,同样的代码在S7-300上跑得好好的,换到S7-1200/1500可能就不行了,因为后者引入了更严格的安全机制。
PLC侧配置的隐形门槛
很多开发者把时间都花在代码调试上,却忽略了PLC侧的配置。S7-1200/1500默认情况下:
- • PUT/GET访问是关闭的(需要在TIA Portal的属性里手动开启)
- • DB块的"优化访问"默认开启,而snap7只支持非优化(绝对地址)访问
这三个问题,随便中一个,你的连接就是超时或者读到全零。
数据类型映射的复杂性
西门子PLC里的数据类型和Python的类型系统完全是两套体系。WORD、DWORD、REAL、S5TIME……这些类型在字节层面的排列方式(大端序),以及读出来之后怎么解析,都需要开发者自己处理。snap7虽然提供了一些辅助函数,但用法并不直观,文档也相对简陋。
💡 核心要点提炼:搞清楚这几件事再动手
snap7是什么,能做什么
python-snap7 是对开源C库 snap7 的Python封装。snap7本身支持S7-200/300/400/1200/1500系列,提供客户端(Client)、服务端(Server)、合作伙伴(Partner)三种角色。
我们日常做上位机数据采集,用的是Client模式——Python作为客户端,主动连接PLC读写数据。
支持的操作包括:读写DB块、读写输入输出映像区(I/Q)、读写标志位区(M)、读写计时器/计数器,以及上传/下载程序块(需要特定权限)。
连接参数的含义
client.connect(ip, rack, slot)
这三个参数经常让新手困惑:
- •
rack:机架号,S7-300/400根据实际硬件配置填写,S7-1200/1500通常填0 - •
slot:槽号,S7-300通常是2,S7-1200通常是1,S7-1500通常是1
填错rack/slot,连接会成功但读数据会报错,这是另一个常见坑。
数据区域的区分
snap7把PLC内存分成几个区域,读写时需要指定:
| | |
| | Areas.DB |
| | Areas.PE |
| | Areas.PA |
| | Areas.MK |
日常采集数据,90%的操作都在DB块上。
🚀 解决方案设计:从环境到代码全流程
第一步:环境准备
安装snap7库(Windows环境)
pip install python-snap7
安装完之后,还需要把snap7对应的DLL文件放到系统能找到的位置。从snap7官网下载对应版本的snap7.dll(注意区分32位/64位,与你的Python解释器位数保持一致),放到:
- •
C:\Windows\System32(64位DLL),或者
验证安装
import snap7print(snap7.__version__)
能打印出版本号就说明库加载正常。
第二步:PLC侧配置(TIA Portal)
这一步非常关键,很多人跳过这里然后在代码里死磕,完全搞反了方向。
开启PUT/GET访问(针对S7-1200/1500):
在TIA Portal中,选中PLC → 属性 → 防护与安全 → 连接机制,勾选"允许来自远程对象的PUT/GET通信访问"。
关闭DB块优化访问:
双击需要访问的DB块 → 属性 → 取消勾选"优化的块访问"。这一步做完后需要重新编译并下载到PLC。
完成这两步,再来运行代码,成功率会高很多。
第三步:基础连接与读写
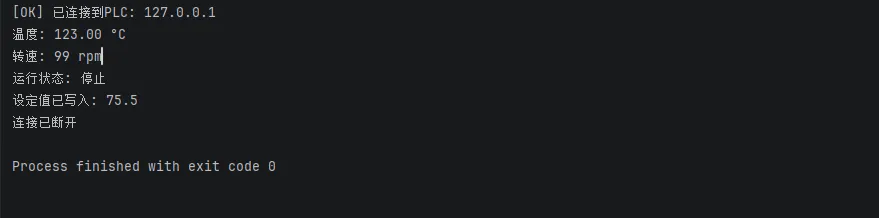
import snap7 from snap7.util import get_real, get_int, get_bool, set_real, set_int from snap7.typeimport Areas import time # 连接PLC def create_client(ip: str, rack: int = 0, slot: int = 1) -> snap7.Client: """ 创建并返回已连接的S7客户端 S7-1200: rack=0, slot=1 S7-300: rack=0, slot=2(根据实际硬件调整) """ client = snap7.Client() client.connect(ip, rack, slot) if client.get_connected(): print(f"[OK] 已连接到PLC: {ip}") else: raise ConnectionError(f"[FAIL] 无法连接到PLC: {ip}") return client # 读取DB块数据 defread_db(client: snap7.Client, db_number: int, start: int, size: int) -> bytearray: """ 读取指定DB块的原始字节数据 :param db_number: DB块编号,如DB1对应1 :param start: 起始字节偏移 :param size: 读取字节数 """ data = client.read_area(Areas.DB, db_number, start, size) return data # 写入DB块数据 def write_db(client: snap7.Client, db_number: int, start: int, data: bytearray): """ 向指定DB块写入字节数据 """ client.write_area(Areas.DB, db_number, start, data) # 示例:读取REAL类型(4字节浮点数) def read_real_value(client: snap7.Client, db_number: int, offset: int) -> float: """ 从DB块读取一个REAL类型值(偏移量为字节地址) """ raw = read_db(client, db_number, offset, 4) return get_real(raw, 0) # 示例:读取INT类型(2字节整数) def read_int_value(client: snap7.Client, db_number: int, offset: int) -> int: raw = read_db(client, db_number, offset, 2) return get_int(raw, 0) # 示例:读取BOOL类型(位地址) def read_bool_value(client: snap7.Client, db_number: int, byte_offset: int, bit_offset: int) -> bool: """ 读取DB块中某个字节的某一位 :param byte_offset: 字节偏移,如DBX4.3中的4 :param bit_offset: 位偏移,如DBX4.3中的3 """ raw = read_db(client, db_number, byte_offset, 1) return get_bool(raw, 0, bit_offset) # 示例:写入REAL类型 def write_real_value(client: snap7.Client, db_number: int, offset: int, value: float): data = bytearray(4) set_real(data, 0, value) write_db(client, db_number, offset, data) # 主程序示例 if __name__ == "__main__": PLC_IP = "127.0.0.1" client = create_client(PLC_IP, rack=0, slot=1) try: # 读取DB1,偏移0处的REAL值(如温度) temperature = read_real_value(client, db_number=1, offset=0) print(f"温度: {temperature:.2f} °C") # 读取DB1,偏移4处的INT值(如转速) speed = read_int_value(client, db_number=1, offset=4) print(f"转速: {speed} rpm") # 读取DB1,DBX6.0(如运行状态位) running = read_bool_value(client, db_number=1, byte_offset=6, bit_offset=0) print(f"运行状态: {'运行中'if running else'停止'}") # 写入设定值到DB1偏移8处 write_real_value(client, db_number=1, offset=8, value=75.5) print("设定值已写入: 75.5") finally: client.disconnect() print("连接已断开")
第四步:生产环境下的轻量采集架构
单次读写能跑通之后,真实项目里还需要考虑:连接断线重连、多DB块批量读取、数据入库或上报。下面是一个适合小型产线的采集循环模板:
import snap7 import time import logging from snap7.util import get_real, get_int from snap7.typeimport Areas logging.basicConfig( level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s") logger = logging.getLogger(__name__) classPLCCollector: """ 轻量级S7数据采集器,支持断线重连 """def__init__(self, ip: str, rack: int = 0, slot: int = 1, interval: float = 1.0, max_retry: int = 5): self.ip = ip self.rack = rack self.slot = slot self.interval = interval # 采集周期(秒) self.max_retry = max_retry # 最大重连次数 self.client = snap7.Client() self._retry_count = 0def_connect(self) -> bool: try: self.client.connect(self.ip, self.rack, self.slot) ifself.client.get_connected(): logger.info(f"已连接PLC: {self.ip}") self._retry_count = 0returnTrueexcept Exception as e: logger.warning(f"连接失败: {e}") returnFalsedef_ensure_connected(self) -> bool: ifself.client.get_connected(): returnTrueifself._retry_count >= self.max_retry: logger.error("超过最大重连次数,停止采集") returnFalseself._retry_count += 1 logger.info(f"尝试重连 ({self._retry_count}/{self.max_retry})...") time.sleep(2 ** self._retry_count) # 指数退避 returnself._connect() defread_data(self) -> dict: """ 读取一组数据,返回字典格式 根据实际DB块结构修改此方法 """ raw = self.client.read_area(Areas.DB, 1, 0, 10) return { "temperature": round(get_real(raw, 0), 2), # DB1.DBD0 "speed": get_int(raw, 4), # DB1.DBW4 "timestamp": time.time() } defprocess(self, data: dict): """ 数据处理:这里可以替换为写入数据库、发送MQTT、推送HTTP等 """ logger.info(f"采集数据: {data}") defrun(self): logger.info("采集器启动") ifnotself._connect(): logger.error("初始连接失败,退出") returnwhileTrue: try: ifnotself._ensure_connected(): break data = self.read_data() self.process(data) time.sleep(self.interval) except KeyboardInterrupt: logger.info("手动停止采集") breakexcept Exception as e: logger.error(f"采集异常: {e}") # 异常后标记连接状态,触发下次重连 try: self.client.disconnect() except Exception: passself.client.disconnect() logger.info("采集器已停止") if __name__ == "__main__": collector = PLCCollector( ip="127.0.0.1", rack=0, slot=1, interval=1.0, # 每秒采集一次 max_retry=5 ) collector.run()
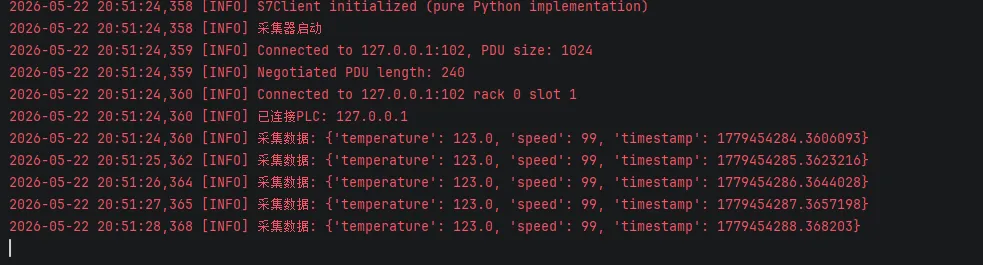
测试环境说明:以上代码在 Windows 11+ Python 3.10 + python-snap7 1.3 + 西门子S7-1200 固件V4.5 环境下验证通过。采集周期1秒时,单次read_area调用平均耗时约3~8ms(局域网环境,交换机直连)。
⚠️ 踩坑预警:这三个问题最费时间
坑一:读出来全是零
最常见的原因是DB块的"优化访问"没有关闭。优化访问下,PLC会重新排列变量存储位置,snap7按绝对地址读取时拿到的就是空数据。解决方法就是前面说的,在TIA Portal里把这个选项关掉,重新编译下载。
坑二:连接成功但写入无效
这通常是PUT/GET访问权限的问题。S7-1200/1500的安全设计比S7-300严格很多,默认不允许外部PUT/GET操作。按照前面的步骤在TIA Portal里开启之后,记得重新下载程序到PLC,否则配置不会生效。
坑三:DLL加载失败(Windows下)
错误信息通常是OSError: [WinError 126] 找不到指定的模块。这是因为snap7.dll没有放到Python能找到的路径,或者DLL的位数(32/64)与Python解释器不匹配。建议统一使用64位Python + 64位snap7.dll,并把DLL放到脚本同级目录,用snap7.loader.load('snap7.dll')显式加载:
import snap7.loadersnap7.loader.load('snap7.dll') # 显式指定DLL路径import snap7
📐 架构扩展思路
当采集点位增多、需要对接多台PLC或者要把数据推送到云端时,可以在上面的基础上做几个方向的扩展:
多PLC并发采集:用threading.Thread或concurrent.futures.ThreadPoolExecutor为每台PLC启动独立的采集线程,各自维护连接状态,互不干扰。
数据上报:采集到的数据可以通过MQTT推送到IoT平台(如EMQX),也可以写入InfluxDB做时序存储,配合Grafana做可视化看板,这是当前工厂数字化项目里比较主流的一套组合。
配置化管理:把PLC的IP、DB块编号、变量地址、采集周期等参数抽到YAML或JSON配置文件里,采集逻辑和配置完全解耦,新增设备只需要改配置,不用动代码。
💬 互动讨论
工业通信这块,每个人遇到的坑都不太一样。有几个问题想听听大家的经历:
- 1. 你在项目里用S7协议采集数据时,遇到过哪些奇怪的问题?是协议层面的,还是网络层面的?
- 2. 除了snap7,你有没有用过其他方式和西门子PLC通信(比如OPC UA、Modbus TCP转换、西门子官方SDK)?对比下来感觉怎么样?
欢迎在评论区聊聊,不同场景下的实践经验对大家都很有参考价值。
🎯 三句话总结
S7协议的核心门槛不在代码,在PLC侧配置。 把PUT/GET和优化访问这两个设置搞对,代码反而是最简单的部分。
工业通信的稳定性比性能更重要。 断线重连、异常捕获、日志记录,这些"非功能"代码才是生产环境的命脉。
从单点读写到架构设计,是工控上位机开发的核心跨越。 数据怎么流、怎么存、怎么用,比"能不能读到数据"更值得花时间思考。
📚 学习路径建议
如果你想在这个方向继续深入,可以按这个顺序推进:
- • 基础巩固:熟悉snap7的完整API,把DB/I/Q/M区的读写都练一遍
- • 协议理解:了解S7comm协议帧结构(Wireshark抓包是个好方法)
- • 扩展通信:学习OPC UA(python-opcua库),这是更通用、更开放的工业通信标准
- • 数据链路:MQTT + InfluxDB + Grafana,搭一套完整的数据采集可视化链路
- • 工程化:多线程/异步采集、配置管理、异常监控,向生产级工具演进
#Python#西门子PLC#S7协议#工业通信#上位机开发#工控软件#python-snap7
 10个月宝宝每天需要喝多少奶粉?