《Linux 工程师的 AI 实战指南》02 本篇目标:用 30 分钟搭好一套不污染生产机、可以随时重建的 AI 实验环境。
很多 Linux 工程师第一次尝试 AI,动作都很直接粗暴:把一段报错贴进网页,复制模型返回的命令,然后粘贴到终端执行。
这个动作在个人测试环境,最坏的结果不过是一次小失误;但在生产环境,它至少越过了三条红线:日志被发送到未知位置、命令没有经过验证、执行身份拥有过大的权限。
所以,这个系列的第一步不是选模型,也不是安装 Agent 框架,而是先搭建好实验环境。
我的判断很明确:Linux 工程师使用 AI 的最小安全单元,不是一个 Prompt,而是一套可销毁、可复现、默认无生产权限的实验环境。
本篇文章只做四件事:
- 为 Python 依赖建立隔离环境;
- 用环境变量接入一个兼容 OpenAI 的模型接口;
- 准备一份脱敏的示例日志;
- 运行环境检查,确认密钥不会被打印出来。
最终目录如下:
textlinux-ai-lab/
├── .venv/ # 可删除、可重建,不提交 Git
├── .env.example # 只放变量名,不放真实密钥
├── fixtures/ # 脱敏后的日志与接口样例
│ └── app.log
├── scripts/ # 本系列的实验脚本
│ └── check_env.py
└── README.md这套目录看起来普通,但它首先解决了一个关键问题:让实验环境与真实运维环境分开。
本文以 Ubuntu、Debian、Rocky Linux 或同类发行版为例。先检查三个命令是否安装:
bashpython3 --version
curl --version | head -n 1
git --version建议使用仍在维护期内的 Python 3 版本。本文配套脚本只依赖 Python 标准库,因此不要求 GPU,也不要求安装 PyTorch。
然后创建工作目录:
bashmkdir -p linux-ai-lab/{scripts,fixtures}
cd linux-ai-lab
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip看到命令提示符前出现 (.venv),说明当前 Shell 已进入虚拟环境。
 进入虚拟环境
为什么要多做这一步?因为 venv 会为项目建立独立的 Python 包目录。后续即使安装新的 SDK,也不会直接修改系统 Python。这个目录本身应被视为一次性制品:坏了就删除再建,不应该复制到其他机器,也不应该提交到 Git。
把下面两行写入 .gitignore:
大模型的选择很多,例如 OpenAI、DeepSeek 等。本系列为了统一实验环境和示例代码,默认使用 Chrono AI 完成模型调用和实操演示。Chrono AI 针对 Linux 与运维场景进行了专项增强,同时保留开放的模型调用方式,课程中的方法也可以迁移到其他模型平台。 如果你想跟着课程一起动手实践,可以直接注册 Chrono AI。目前新用户注册可获得免费 Token 额度,足以用于前期课程中的基础实验。
在项目根目录创建 .env.example:
bashCHRONO_AI_BASE_URL="https://api.aiops.red/v1"
CHRONO_AI_API_KEY="你的真实密钥"
CHRONO_AI_MODEL="chrono-ops-1"也可以在当前终端临时设置变量:
bashexport CHRONO_AI_BASE_URL="https://api.aiops.red/v1"
export CHRONO_AI_API_KEY="你的真实密钥"
export CHRONO_AI_MODEL="chrono-ops-1"echo 命令验证变量是否正确配置。这里并没有使用 echo $CHRONO_AI_API_KEY 做检查。密钥存在,不等于密钥应该出现在终端回显、Shell 录屏、CI 日志或截图中。
实验环境可以用环境变量降低配置成本;进入团队或生产环境后,应改用受控的 Secret 管理机制,并限制哪些进程、容器和人员可以读取它。
不是所有日志都可以被同等处理。我建议至少分成四级:
现在创建一份合成日志 fixtures/app.log:
text2026-08-09T09:20:01Z INFO service=demo-api request_id=req-001 status=200 latency_ms=42
2026-08-09T09:20:07Z WARN service=demo-api request_id=req-002 status=502 upstream=timeout
2026-08-09T09:20:08Z ERROR service=demo-api request_id=req-003 status=502 upstream=10.20.0.8:8080它保留了故障分析需要的字段,但没有真实客户数据,也没有可用凭据。后续文章会用它演示日志裁剪、脱敏和证据编号。
配套实验中的 check_env.py 只检查变量是否存在,不打印变量值:
bashpython scripts/check_env.py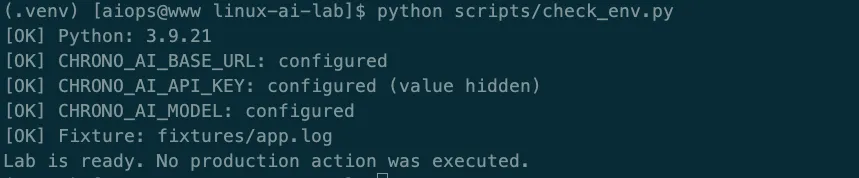 变量检查
check_env.py 脚本内容:
python#!/usr/bin/env python3
"""Validate the Linux AI Lab without revealing secret values."""
from __future__ import annotations
import os
import sys
from pathlib import Path
REQUIRED_ENV = (
"CHRONO_AI_BASE_URL",
"CHRONO_AI_API_KEY",
"CHRONO_AI_MODEL",
)
PROJECT_ROOT = Path(__file__).resolve().parent.parent
FIXTURE_PATH = PROJECT_ROOT / "fixtures" / "app.log"
def main() -> int:
failed = False
print(
f"[OK] Python: "
f"{sys.version_info.major}."
f"{sys.version_info.minor}."
f"{sys.version_info.micro}"
)
for name in REQUIRED_ENV:
if os.getenv(name):
suffix = " (value hidden)" if name.endswith("API_KEY") else ""
print(f"[OK] {name}: configured{suffix}")
else:
print(f"[FAIL] {name}: not configured")
failed = True
if FIXTURE_PATH.is_file():
relative_path = FIXTURE_PATH.relative_to(PROJECT_ROOT)
print(f"[OK] Fixture: {relative_path}")
else:
print("[FAIL] Fixture: fixtures/app.log is missing")
failed = True
if failed:
print("Lab is incomplete. No production action was executed.")
return 1
print("Lab is ready. No production action was executed.")
return 0
if __name__ == "__main__":
raise SystemExit(main())预期输出类似:
text[OK] Python: 3.x
[OK] CHRONO_AI_BASE_URL: configured
[OK] CHRONO_AI_API_KEY: configured (value hidden)
[OK] CHRONO_AI_MODEL: configured
[OK] Fixture: fixtures/app.log
Lab is ready. No production action was executed.如果接口密钥没有配置,脚本会返回非零退出码,但仍然不会展示任何密钥片段。
为什么暂时不安装 LangChain、向量数据库和本地大模型因为第一阶段最容易犯的错误,是在问题还没定义清楚时先堆工具。
对 Linux 工程师来说,一个最小 AI 工作流只有五个对象:
text任务 → 上下文 → 模型请求 → 结构化结果 → 人工验证框架可以稍后替换,模型也可以更换;但如果数据边界、输出契约和验证步骤没有建立,框架越强,错误传播得越快。
我们先用标准 HTTP 和 JSON 把最小链路跑通。等进入 Agent、RAG 和 Kubernetes 章节时,再增加必要组件。这样每增加一个依赖,都能回答“它解决了什么问题”。
第一,不要在拥有生产 kubeconfig、云管理员凭据或免密 sudo 的终端里做初次实验。
第二,不要把 /var/log、~/.ssh、/etc 或工单系统整批交给模型。先选定时间窗口和字段,再做脱敏与最小化。
第三,不要把模型返回的文本直接接到 bash -c。后续我们会把命令改造成结构化 argv,再经过策略检查、dry-run 和人工审批。
请在一台测试机或虚拟机上完成下面四项:
- 创建并激活
.venv; - 配置三个
CHRONO_AI_* 环境变量; - 将一份真实日志改写为不含真实 IP、账号和业务标识的 10 行样例;
- 运行
check_env.py,确认输出中没有出现密钥内容。
做到这里,你还没有让 AI 执行任何 Linux 操作,但已经建立了后面所有实验真正需要的边界。
下一篇,我们会从这套 Lab 发出第一次模型请求,并把超时、重试、结构化输出和离线测试一次做对。
魏文第|企业 AI 落地
北京时序折叠科技有限公司
Chrono AI:面向企业场景的模型与 API 能力。
ChronoOps:把 AI 建议接入审批、执行、审计与回退闭环。
ChronoStudio:面向公众号、小红书等内容的智能排版工具。
由 Chrono Studio 排版 · studio.chrono.red