你一定遇到过这种崩溃 moment
写着 Python,代码逻辑完美,跑起来一看——慢到怀疑人生。
一个循环跑了 30 秒,隔壁用 C 的同事 0.3 秒就完事了。你盯着终端,开始灵魂拷问:要不要把这段代码用 C 重写?
但一想到 C 语言那套指针、内存管理、编译链接的流程,又默默关掉了编辑器。
其实,Python 转 C 这件事,远没有你想的那么难。关键不在于「能不能转」,而在于「用什么方法转」。
选错工具,白忙活三天。选对工具,10 分钟提速几十倍。
今天就把市面上所有主流方案摊开来比一遍,再手把手带你跑通 Cython 这条最实用的路。
六大方案横评:谁是真正的「提速王」
先上一张对比表,心里有个数:
一句话总结:
极致提速选 Cython,省心打包选 Nuitka,零成本加速选 PyPy。
Cython 到底是什么?一句话讲清楚
Cython 不是一门新语言,它是 Python 的超集。
什么意思?你写的几乎每一行 Python 代码,Cython 都能直接编译。它真正的威力在于:你可以在某些关键地方加上静态类型声明,让编译器跳过 Python 的动态类型检查,直接生成高效的 C 代码。
打个比方:
Python 是自动挡汽车,灵活但油耗高。Cython 给你开了一个手动挡模式,在关键路段自己换挡,速度直接起飞。
最核心的语法就一个字:cdef。
用 cdef 声明变量类型,Cython 就知道这个变量是 int、double、float 数组,不需要每次运行时再猜。这一步省下的开销,往往就是提速的关键。
一个例子,看懂 Cython 到底改了什么
来看一段最常见的 Python 代码,计算第 n 个斐波那契数:
def fib(n): a, b = 0, 1 for i in range(n): a, b = b, a + b return a
Cython 版本:
cpdef int fib(int n): cdef int a = 0 cdef int b = 1 cdef int i for i in range(n): a, b = b, a + b return a
看出区别了吗?
- • cpdef int fib(int n):函数返回值和参数都声明为 int。
- • cdef int a = 0:局部变量 a 是 int。
- • cdef int b = 1:局部变量 b 是 int。
- • cdef int i:循环变量 i 是 int。
就是这些 cdef 声明,让 Cython 能生成几乎和纯 C 一样快的代码。实测这个例子,n 很大的时候,Cython 版本可以比纯 Python 快 50-100 倍。
Cython 完整转换流程:六步跑通
下面把整套流程拆成六步,照着做就行。
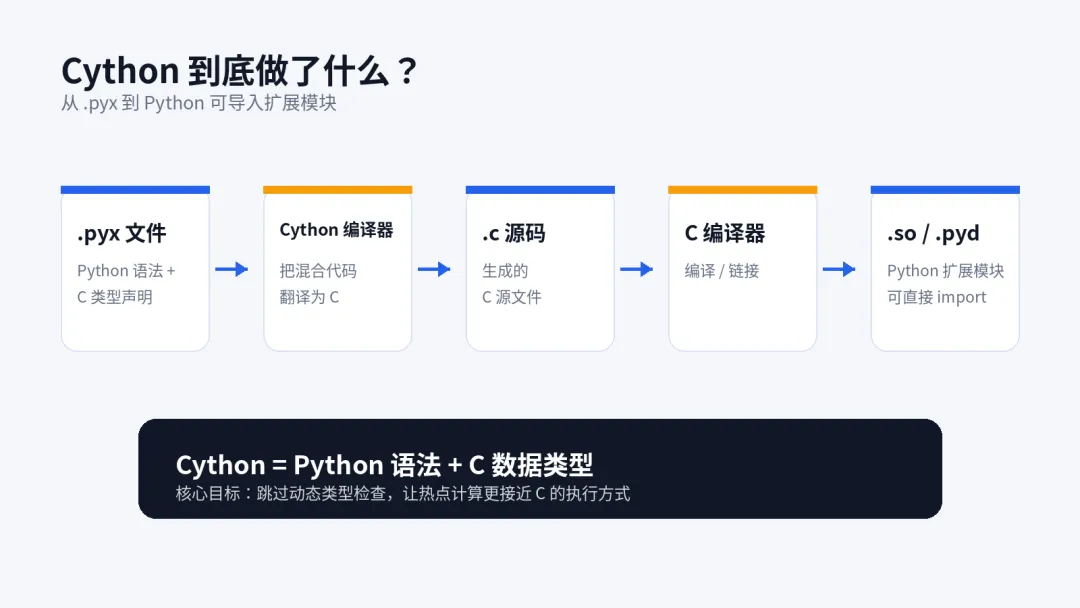
第一步:安装 Cython
pip install cython
Windows 用户如果后面编译报错,建议先装一个 Visual C++ 构建工具。最简单的方式是安装 Microsoft C++ Build Tools,勾选「使用 C++ 的桌面开发」。
第二步:把 .py 改成 .pyx
把你想要加速的 Python 文件,后缀改成 .pyx。
比如原来叫 calc.py,现在叫 calc.pyx。
这个文件里的代码可以大部分是普通 Python,只在关键位置加 cdef 类型声明。
第三步:写一个 setup.py 用来编译
在同级目录新建 setup.py,内容如下:
from setuptools import setupfrom Cython.Build import cythonizeimport numpy as npsetup( ext_modules=cythonize("calc.pyx"), include_dirs=[np.get_include()])
如果你用了 NumPy 数组,一定要记得加 include_dirs=[np.get_include()],否则编译会找不到 NumPy 的头文件。
第四步:编译生成 C 扩展
在终端运行:
python setup.py build_ext --inplace
这条命令会生成两个关键产物:
- • calc.cp311-win_amd64.pyd(Windows)或 calc.cpython-311-x86_64-linux-gnu.so(Linux):最终的二进制扩展模块。
编译成功后,你就可以像导入普通 Python 模块一样使用它。
第五步:在 Python 里正常调用
import calcresult = calc.fib(1000000)print(result)
调用方式和原来的 Python 代码完全一样,不需要改业务逻辑。
第六步:进阶提速技巧
如果还不够快,可以加一些编译器指令,进一步压榨性能:
# cython: language_level=3# cython: boundscheck=False# cython: wraparound=Falseimport numpy as npcimport numpy as npcpdef double sum_array(double[:] arr): cdef int i cdef int n = arr.shape[0] cdef double total = 0.0 for i in range(n): total += arr[i] return total
几个关键指令的含义:
- • boundscheck=False:关闭数组越界检查,省掉每次索引时的安全检查。
- • wraparound=False:关闭负数索引处理(比如 arr[-1]),进一步提速。
- • double[:] arr:声明 memoryview 类型的数组,直接操作底层内存,避免 Python 对象开销。
- • nogil:在确定没有 Python 对象交互的代码块里,可以释放 GIL,实现真正的多核并行。
但注意:boundscheck=False 和 wraparound=False 会牺牲安全性。如果数组访问越界,程序可能直接崩溃。只在性能瓶颈且逻辑可控的地方用。
最后一句
Python 转 C,不是为了把 Python 变成 C,而是让 Python 在关键的地方借用 C 的速度。
Cython 就是这个桥梁。它不需要你抛弃 Python 的优雅,只需要你在瓶颈处加上几行类型声明,就能让程序快一个数量级。
下次再遇到 Python 慢到想砸键盘的时候,别急着重写,试试 Cython。
关注我,不迷路 🚀
搞技术不绕弯,讲干货不注水。点个「关注」和「收藏」,下次遇到性能问题直接翻出来用。
