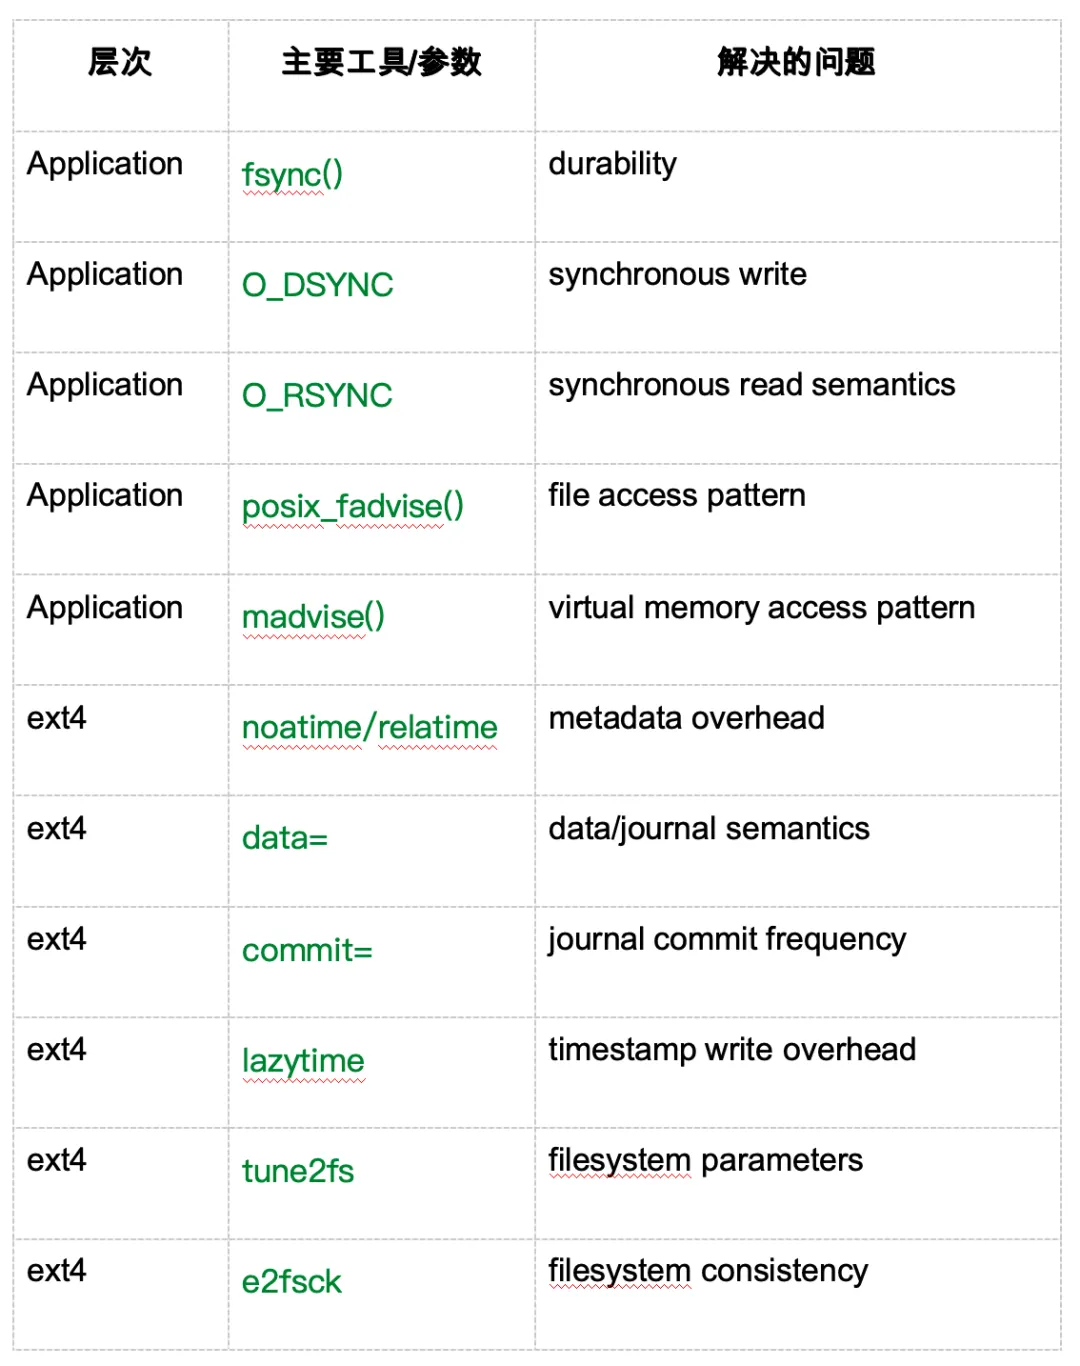
Linux 文件系统调优
Linux 文件系统性能并不只是“磁盘快不快”的问题。应用的 I/O 模式、页缓存策略、文件系统 mount options,以及 ext4 的内部参数,都会影响最终的吞吐、延迟和 CPU 消耗。

1. 应用层 I/O 调优
应用层最重要的问题不是“怎么让磁盘更快”,而是:
应用到底需要什么样的 durability、cache 和 access pattern?
如果应用错误地要求了过强的持久化保证,性能可能下降一个数量级。
1.1 fsync vs O_DSYNC / O_RSYNC
fsync()
fsync(fd) 的语义是:
将文件相关的脏数据以及必要的元数据刷新到底层存储,使数据达到持久化要求。
例如:
write(fd, buf, size);
fsync(fd);
这种模式意味着每次写入后都要求显式 flush。
如果:
write
fsync
write
fsync
write
fsync
那么性能很容易受到 storage latency 限制。
尤其是在随机小 I/O 场景:
Application
│
write
│
fsync
│
▼
Storage
如果一次 fsync() 的实际持久化延迟是 1 ms,那么理论上单线程同步写入的上限可能只有约:
1000 fsync/s
因此,数据库、日志系统等通常会使用 batching/group commit,把多个逻辑操作合并到一次 flush 中。(比较常见)

O_DSYNC
打开文件时可以使用:
open("file", O_WRONLY | O_DSYNC);
它要求写操作的数据满足同步 I/O 的持久化语义,而不需要每次显式调用 fsync()。
典型模式:
write()
│
▼
O_DSYNC
│
▼
persistent storage
它适合:
●WAL
●journal
●transaction log
●对数据持久性要求较高的应用
但代价是每次相关写操作都可能受到存储设备 flush latency 的影响。
O_RSYNC
O_RSYNC 是一个比较容易被忽略的 flag,它主要用于控制同步读取的完成语义,要求 read 操作在相关写入满足同步条件后完成。
实际生产环境中,O_RSYNC 的使用远少于 fsync() 和 O_DSYNC。
因此面试中更重要的是理解:
fsync()
→application 主动要求同步
O_DSYNC
→write 本身具有同步 durability 语义
O_RSYNC
→read 的同步完成语义
1.2 posix_fadvise()
posix_fadvise() 用来向 kernel 提供:
“接下来我大概会怎么访问这个文件。”
例如:
posix_fadvise(fd, 0, 0, POSIX_FADV_SEQUENTIAL);
常见参数包括:
POSIX_FADV_SEQUENTIAL
告诉 kernel:
我会顺序读取这个文件
例如:
0 → 4K → 8K → 12K → 16K → ...
适合:
●日志扫描
●大文件读取
●backup
●ETL
POSIX_FADV_RANDOM
告诉 kernel:
访问模式是随机的
例如:
4K → 1GB → 32MB → 700MB → 128KB
这样 kernel 可以避免针对顺序访问进行不必要的 readahead。
POSIX_FADV_WILLNEED
告诉 kernel:
这些数据很快就会被访问
可以让 kernel 提前准备 page cache。
POSIX_FADV_DONTNEED
告诉 kernel:
这些 page 短期内不会再使用
例如扫描一个 100 GB 的文件:
read 4K
read 4K
read 4K
...
如果这些数据全部留在 page cache,可能挤掉真正有价值的 cache。
因此可以结合:
posix_fadvise(fd, offset, length,
POSIX_FADV_DONTNEED);
降低 cache pollution。
1.3 madvise()
madvise() 与 posix_fadvise() 很像,但作用对象不同。
简单理解:
posix_fadvise()
→file descriptor / file I/O
madvise()
→process virtual memory
例如:
madvise(addr, length, MADV_SEQUENTIAL);
它告诉 kernel:
这个 virtual memory region 接下来会被顺序访问。
常见选项包括:
MADV_SEQUENTIAL
MADV_RANDOM
MADV_WILLNEED
MADV_DONTNEED
MADV_HUGEPAGE
MADV_NOHUGEPAGE
这对于 mmap() 类型的应用尤其重要:
File
│
▼
mmap()
│
▼
Virtual Memory
│
└── madvise()
因此:
read()/write()
→posix_fadvise()
mmap()
→madvise()
这是面试中非常值得记住的一组对比。
2. ext4 文件系统调优
应用层解决的是:
How does the application access data?
而 ext4 调优解决的是:
How does ext4 organize and persist data?
主要涉及:
mount options
tune2fs
e2fsck
2.1 ext4 mount options
查看当前 mount options:
mount | grep ext4
或者:
findmnt -t ext4
典型输出:
/dev/nvme0n1p1 on / type ext4
(rw,relatime,data=ordered)
noatime / relatime
传统情况下,Linux 会维护文件的 access time:
atime
读取文件可能导致 inode metadata 更新。
对于大量 read workload:
read file
│
├──read data
│
└──update atime
可能产生额外的 metadata I/O。
因此常见优化是:
noatime
完全关闭 atime 更新。
或者:
relatime
只在必要情况下更新 atime。
现代 Linux 系统一般默认使用 relatime,因此不应该在没有 workload 证据的情况下盲目修改。
commit=
例如:
mount -o commit=30
控制 journal commit 的周期。
默认通常是几秒级。
更大的 commit interval:
更多数据
│
▼
batch
│
▼
一次 commit
可能减少 metadata/journal 操作,但同时意味着:
●crash 后可能有更多未提交数据
●durability latency 可能增加
所以它是一个典型的:
performance ↔ durability
trade-off。
lazytime
可以使用:
lazytime
减少时间戳更新产生的额外写入。
它让 inode timestamp 的更新更多地保留在内存中,再与其他 inode 写回一起处理。
对于 metadata-heavy workload 有时比较有价值。

2.2 tune2fs
tune2fs 主要用于修改 ext2/ext3/ext4 文件系统的参数。
查看文件系统信息:
sudo tune2fs -l /dev/nvme0n1p1
可以看到:
Filesystem volume name
Filesystem UUID
Filesystem features
Block size
Inode size
Mount count
Maximum mount count
Check interval
Journal size
例如:
sudo tune2fs -l /dev/nvme0n1p1 | less

Reserved blocks
ext4 通常会保留一部分 block:
Reserved block percentage
可以查看:
tune2fs -l /dev/nvme0n1p1
对于普通 server,默认保留空间可能比较合理。
但是对于一个非常大的数据盘,例如:
10 TB
即使只保留 5%,也意味着:
500 GB
因此对于专门的数据盘,可以根据实际用途调整 reserved blocks。
例如:
sudo tune2fs -m 1 /dev/nvme0n1p1
将 reserved blocks percentage 调整为 1%。
但不要把它简单理解为“reserved blocks 越少越好”。
Reserved blocks 可以帮助:
●root/admin 在磁盘接近满时继续工作
●避免 filesystem 完全耗尽
●降低严重 fragmentation 的风险
所以生产系统需要根据磁盘用途决定。

2.3 e2fsck
e2fsck 用于检查和修复 ext2/ext3/ext4 filesystem。
最基本:
sudo e2fsck /dev/nvme0n1p1
但是要特别注意:
不要在正在挂载并使用的 filesystem 上随意运行 e2fsck。
通常应该:
unmount
│
▼
e2fsck
│
▼
mount
例如:
sudo umount /data
sudo e2fsck /dev/nvme0n1p1
sudo mount /data

e2fsck 和性能的关系
e2fsck 本身不是日常性能调优工具。
它解决的是:
filesystem consistency
例如:
inode
block bitmap
directory
journal
extent
之间出现不一致时,通过检查和修复恢复 filesystem consistency。
因此:
tune2fs
→filesystem configuration
e2fsck
→filesystem integrity
不要把 e2fsck 当成类似 fsck = filesystem performance optimizer。

3. 一套实际的 ext4 调优思路
生产环境中,不应该一上来执行:
mount -o noatime,...
而应该先确认 workload。
例如一个数据库服务器:
Application
│WAL
▼
fsync / O_DSYNC
│
▼
Page Cache
│
▼
ext4
├──journal
├──metadata
└──data
▼
NVMe
首先观察:
iostat -xz 1
vmstat 1
pidstat -d 1
再结合:
cat /proc/meminfo
mount
findmnt
tune2fs -l /dev/xxx
判断瓶颈到底属于:
Application I/O pattern
│
├──sync I/O
├──random I/O
├──sequential I/O
└──excessive fsync
│
▼
PageCache
│
▼
ext4
│
├──journal
├──metadata
└──fragmentation
│
▼
BlockDevice
4. 总结
Linux filesystem tuning 最重要的不是记住几个 sysctl 或 mount option,而是建立完整的 I/O 模型:
最终可以把 filesystem performance 简化成三个核心问题:
1. Application:
我到底需要什么durability?
2. Cache:
哪些数据应该进入/留在page cache
3. Filesystem:
ext4应该用什么方式组织、journal 和写回数据?
最好的 filesystem tuning 往往不是“把参数调得更激进”,而是让 application I/O semantics、page cache 和 filesystem semantics 与实际 workload 相匹配。