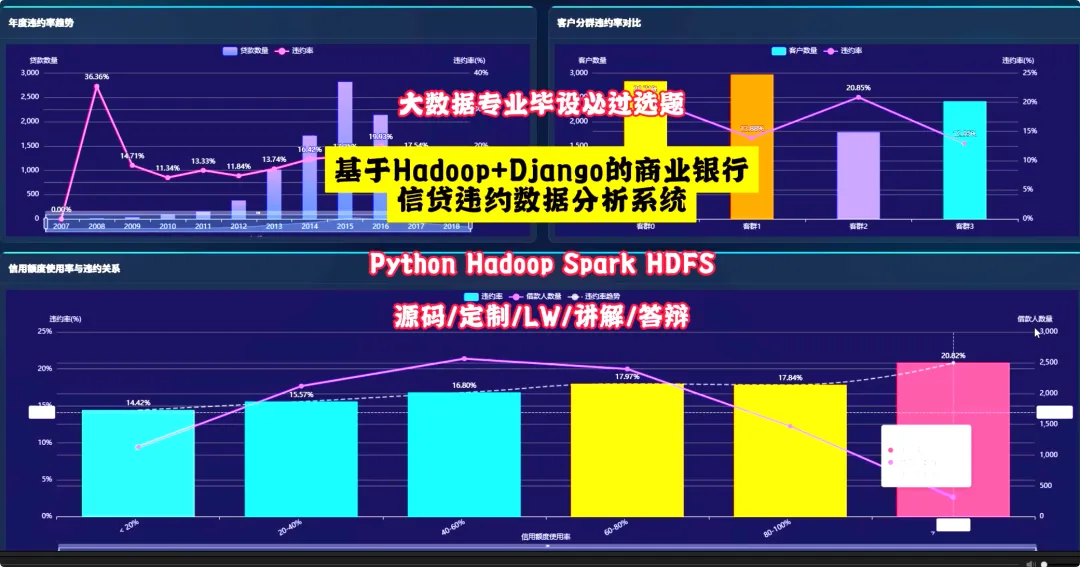
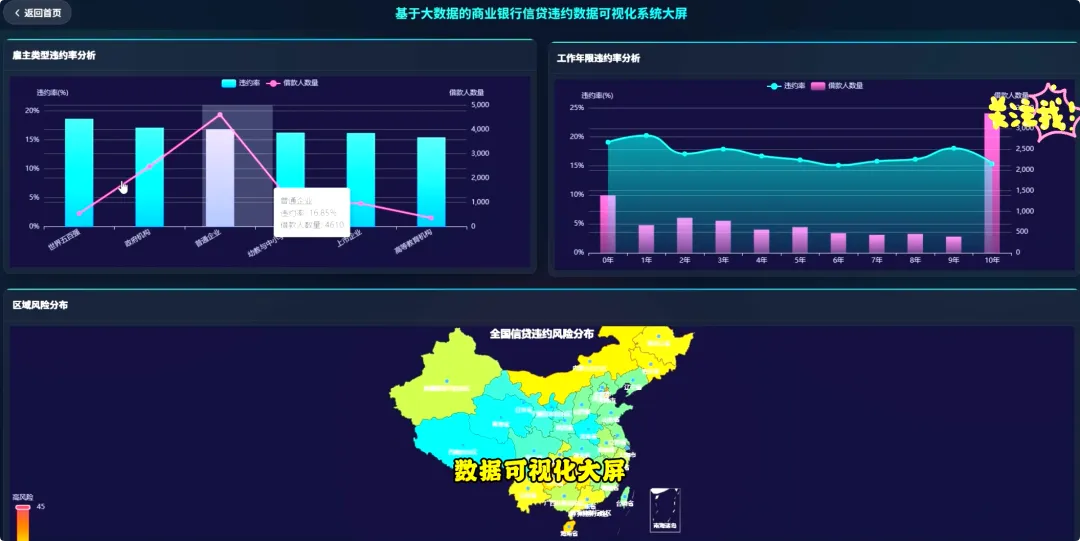
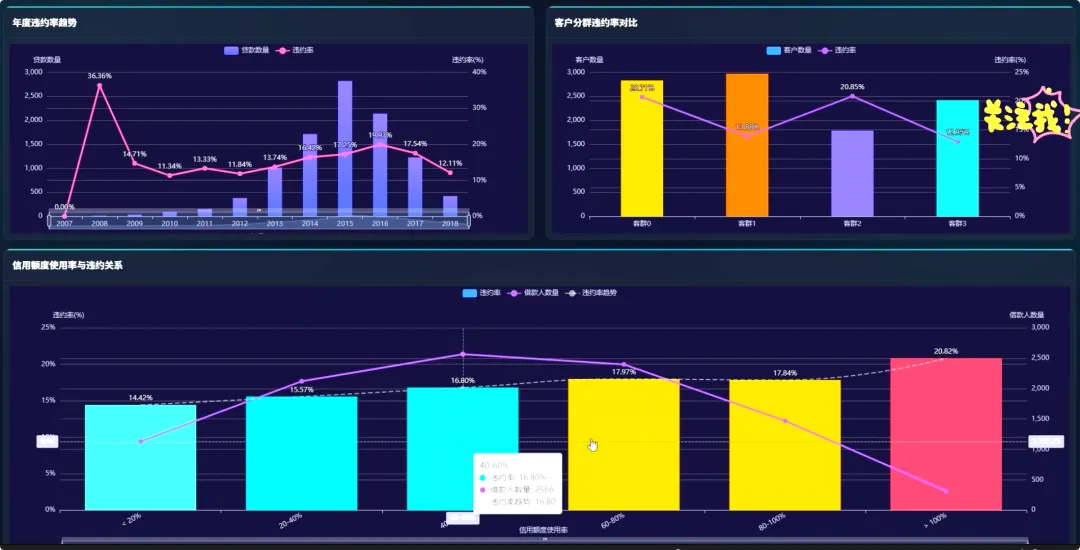
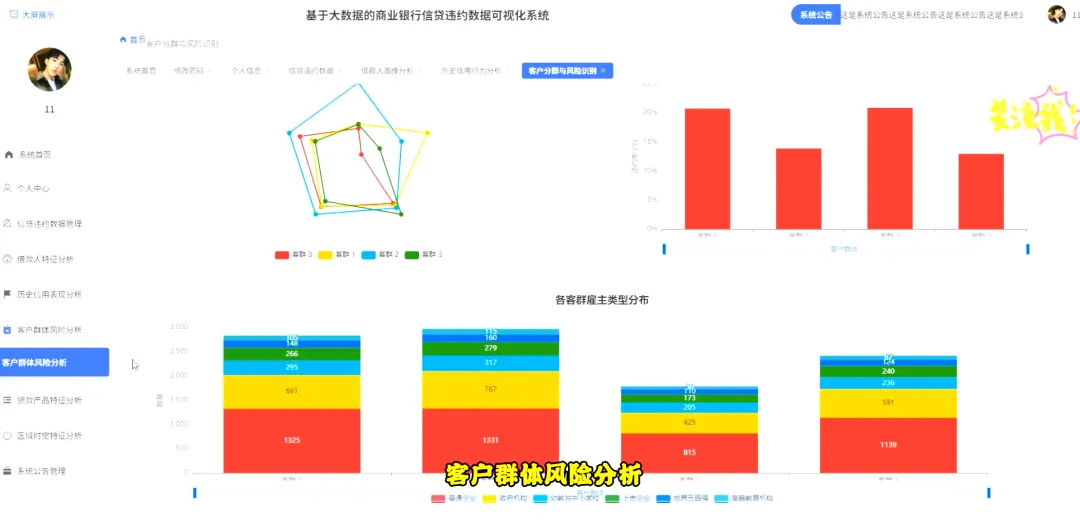
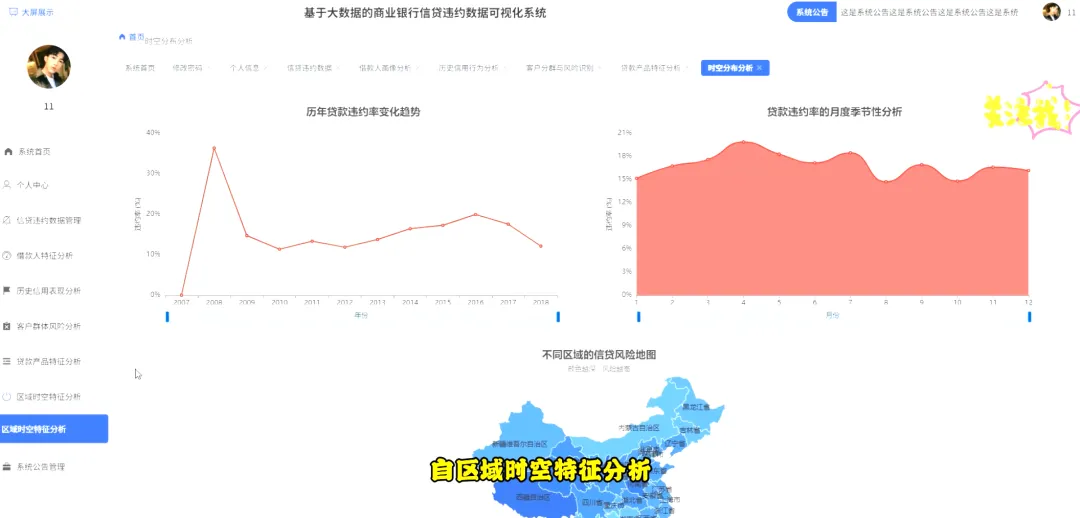
from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col, count, when, avg, descfrom pyspark.ml.feature import VectorAssemblerfrom pyspark.ml.clustering import KMeans# 初始化SparkSession,连接大数据集群环境spark = SparkSession.builder \ .appName("BankCreditAnalysisSystem") \ .config("spark.sql.warehouse.dir", "/user/hive/warehouse") \ .enableHiveSupport() \ .getOrCreate()# 功能一:借款人画像维度分析 - 不同雇主类型的违约率统计def analyze_employer_default_rate(spark_df): # 筛选有效数据,排除employer_type为空的记录 valid_data = spark_df.filter(col("employer_type").isNotNull()) # 按雇主类型分组,统计总人数和违约人数 group_df = valid_data.groupBy("employer_type").agg( count("id").alias("total_count"), count(when(col("isDefault") == 1, True)).alias("default_count") ) # 计算违约率,保留4位小数,并按违约率降序排列 result_df = group_df.withColumn("default_rate", (col("default_count") / col("total_count")) * 100) \ .select("employer_type", "total_count", "default_rate") \ .orderBy(desc("default_rate")) # 将分析结果转换为Django接口需要的字典列表格式 analysis_result = [row.asDict() for row in result_df.collect()] return analysis_result# 功能二:时空分布维度分析 - 区域信贷风险地图数据处理def analyze_region_risk_map(spark_df, top_n=5): # 从原始数据中选取地区和违约字段,进行分组统计 region_stats = spark_df.groupBy("region").agg( count("id").alias("loan_count"), count(when(col("isDefault") == 1, True)).alias("default_count") ) # 计算每个地区的违约率 region_risk = region_stats.withColumn("risk_rate", (col("default_count") / col("loan_count")) * 100) # 筛选出违约率最高的TOP N高风险地区,用于重点展示 high_risk_regions = region_risk.orderBy(desc("risk_rate")).limit(top_n) # 同时筛选出违约率最低的低风险地区作为对比 low_risk_regions = region_risk.orderBy("risk_rate").limit(top_n) # 合并高险与低险数据,统一返回给前端Echarts渲染 final_data = {"high_risk": high_risk_regions.collect(), "low_risk": low_risk_regions.collect()} return final_data# 功能三:客户分群与风险识别 - 基于K-Means的贷款客户聚类def cluster_customer_profiles(spark_df): # 选取用于聚类的关键数值特征:贷款金额、利率、债务收入比、信用评分 feature_cols = ["total_loan", "interest", "debt_loan_ratio", "scoring_avg"] # 数据清洗:剔除包含缺失值的行,确保聚类算法稳定运行 clean_data = spark_df.na.drop(subset=feature_cols) # 将多列特征向量合并成一列,作为K-Means的输入 assembler = VectorAssembler(inputCols=feature_cols, outputCol="features") feature_data = assembler.transform(clean_data) # 初始化K-Means算法,设定聚类中心数K为4,种子固定以便复现结果 kmeans = KMeans(k=4, seed=1, featuresCol="features", predictionCol="cluster") # 训练模型并预测每个样本所属的簇 model = kmeans.fit(feature_data) predictions = model.transform(feature_data) # 统计每个簇的平均特征值,以此给客群打标签(如“高负债类”) cluster_summary = predictions.groupBy("cluster").agg( avg("total_loan").alias("avg_loan"), avg("interest").alias("avg_interest"), avg("scoring_avg").alias("avg_score"), count("*").alias("cluster_size") ) return cluster_summary.collect()