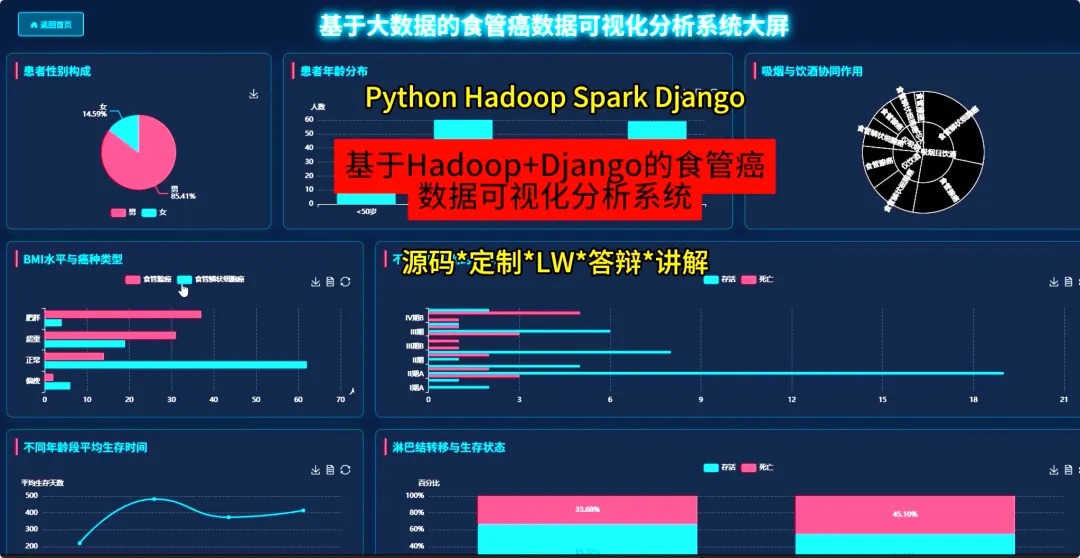
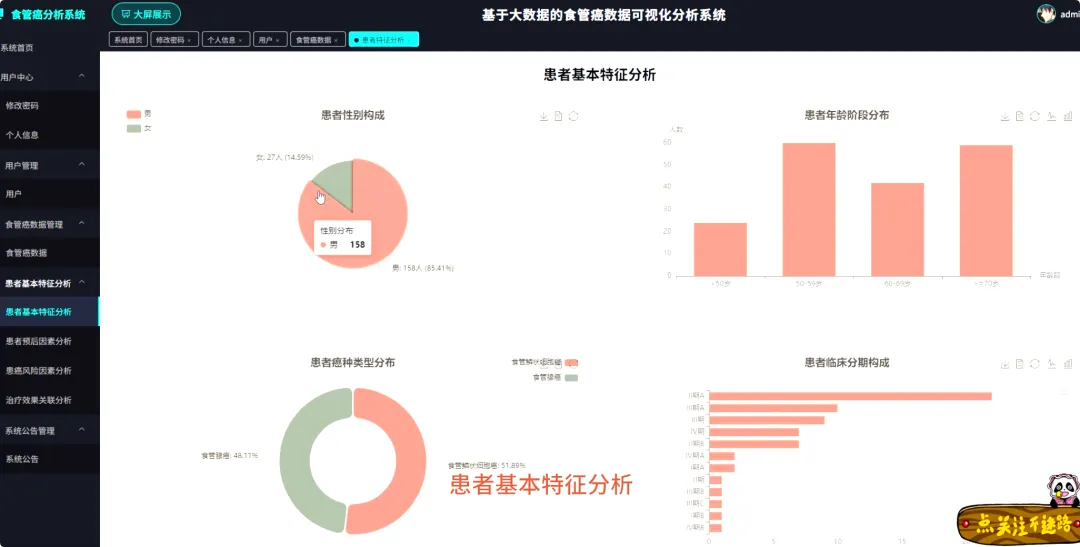
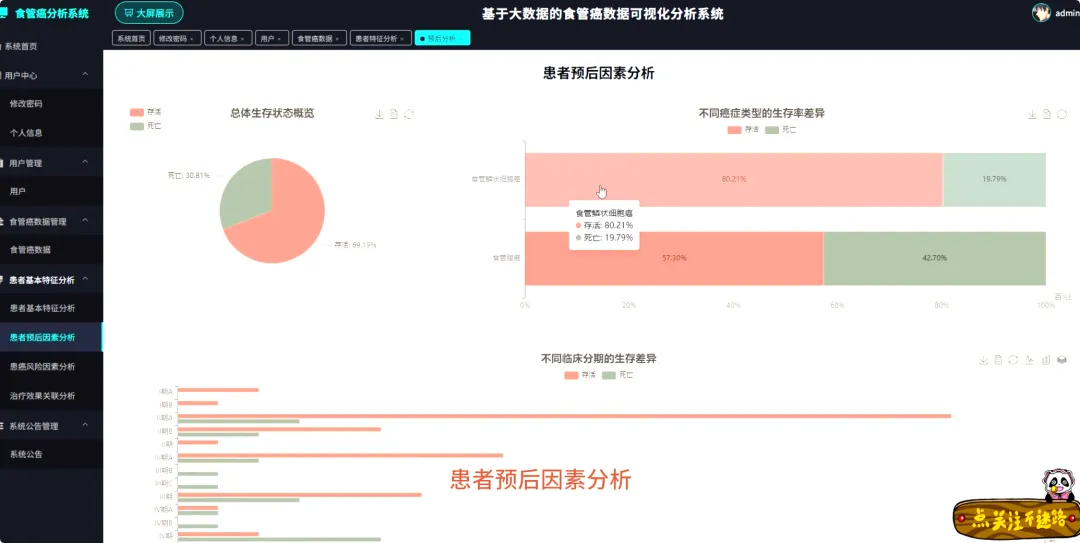
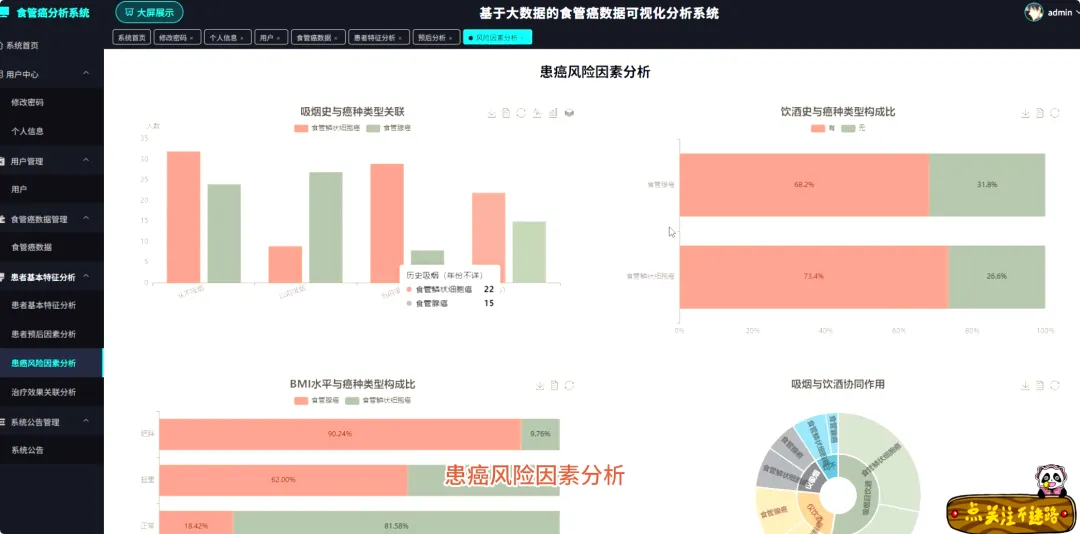
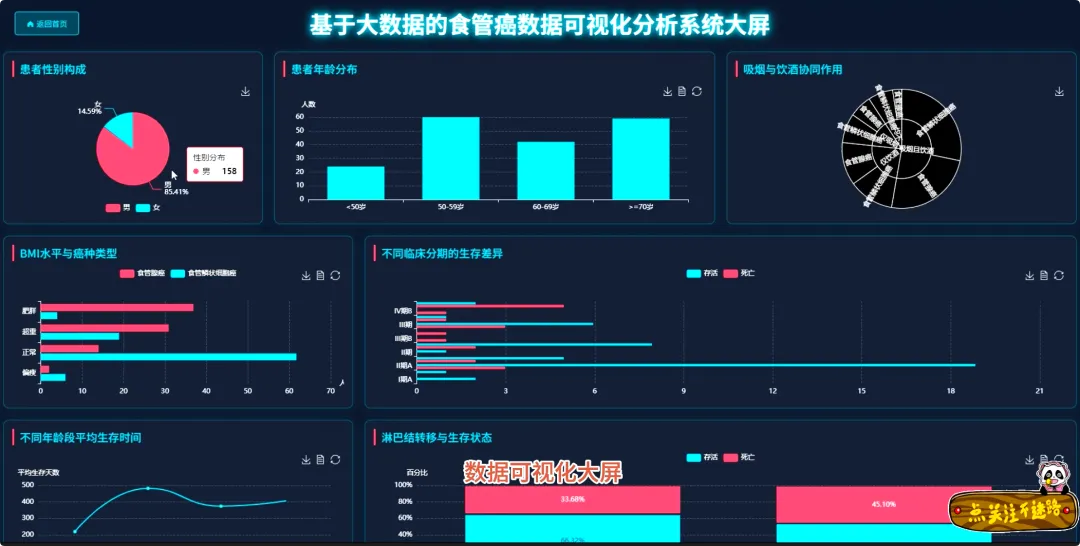
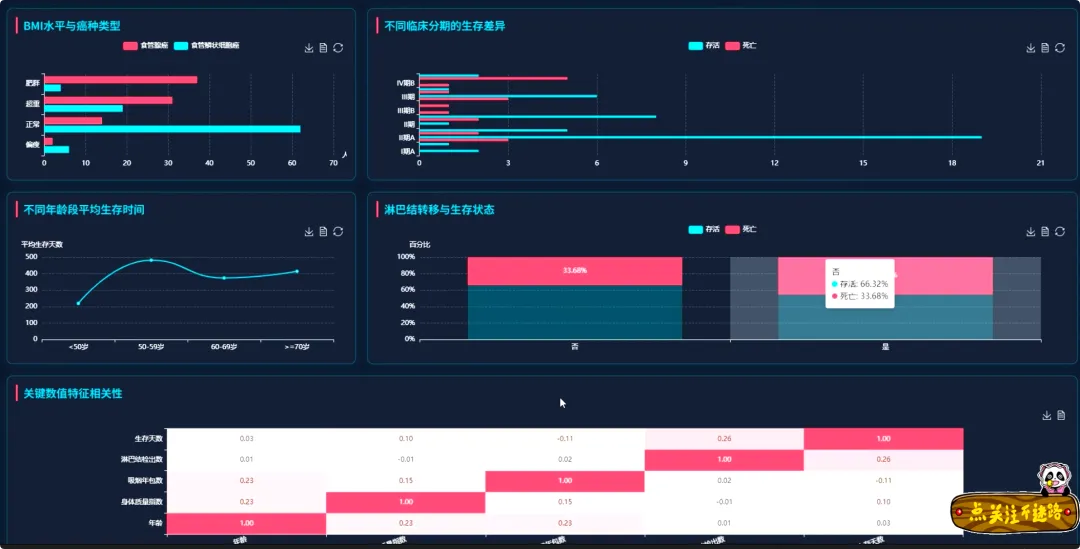
from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col, count, when, isnan, isnullspark = SparkSession.builder.appName("EsophagealCancerAnalysis").getOrCreate()# 假设df是从HDFS加载的包含所有食管癌患者数据的Spark DataFrame# 核心功能1: 患者性别构成分析def analyze_gender_distribution(df): # 筛选性别字段非空的记录 filtered_df = df.filter(col("gender").isNotNull() & (col("gender") != "")) # 按性别分组并计算每组的人数 gender_counts_df = filtered_df.groupBy("gender").agg(count("*").alias("patient_count")) # 将结果转换为字典列表以便前端使用 result = gender_counts_df.collect() gender_distribution = [{"gender": row["gender"], "count": row["patient_count"]} for row in result] return gender_distribution# 核心功能2: 吸烟史与食管癌类型的关联分析def analyze_smoking_histology_link(df): # 筛选吸烟史和病理类型字段均非空的记录 relevant_df = df.filter(col("tobacco_smoking_history").isNotNull() & (col("primary_pathology_histological_type").isNotNull()) & (col("tobacco_smoking_history") != "") & (col("primary_pathology_histological_type") != "")) # 按吸烟史和病理类型进行分组,统计每组的患者数量 link_df = relevant_df.groupBy("tobacco_smoking_history", "primary_pathology_histological_type").agg(count("*").alias("patient_count")) # 收集结果并转换为前端易于处理的格式 result = link_df.collect() smoking_histology_link = [{"smoking_history": row["tobacco_smoking_history"], "histology": row["primary_pathology_histological_type"], "count": row["patient_count"]} for row in result] return smoking_histology_link# 核心功能3: 不同临床分期的生存差异分析def analyze_survival_by_stage(df): # 筛选临床分期和生存状态字段均非空的记录 survival_df = df.filter(col("stage_event_clinical_stage").isNotNull() & (col("vital_status").isNotNull()) & (col("stage_event_clinical_stage") != "") & (col("vital_status") != "")) # 按临床分期和生存状态分组,计算每组的患者数 stage_survival_df = survival_df.groupBy("stage_event_clinical_stage", "vital_status").agg(count("*").alias("patient_count")) # 收集结果,并按分期整理成结构化数据 result = stage_survival_df.collect() survival_by_stage = {} for row in result: stage = row["stage_event_clinical_stage"] status = row["vital_status"] count = row["patient_count"] if stage not in survival_by_stage: survival_by_stage[stage] = {} survival_by_stage[stage][status] = count return survival_by_stage
 10个月宝宝每天需要喝多少奶粉?