用Python+Whisper打造语音转文字神器,轻松搞定会议记录和视频字幕!
还在为手动整理录音发愁?这一行代码就能帮你省下90%的时间!
为什么你需要Whisper?
你有没有遇到过这样的场景:开完两个小时的项目会议,面对满屏的录音文件不知从何下手?或者想给制作的视频配上字幕,却要花几个小时逐句听写?
别愁了。OpenAI开源的Whisper语音识别模型,就是为了解决这些问题而生的。
相比传统的语音识别方案,Whisper有三大杀手锏:
- 支持99种语言识别
- 抗噪能力超强:即使在咖啡馆、地铁等嘈杂环境下,识别准确率依然在线
- 完全本地部署
更香的是,这一切完全免费!
硬件要求高吗?
很多人一听到“AI模型”就以为需要高配电脑,其实Whisper非常灵活:
普通办公电脑(i5处理器 + 8GB内存)跑base或small模型完全没问题,处理10分钟音频大约30秒到1分钟。
5分钟快速上手
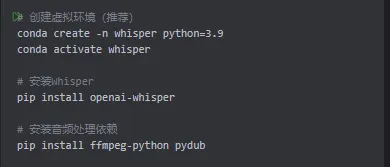
第一步:安装环境
# 创建虚拟环境(推荐)conda create -n whisper python=3.9conda activate whisper# 安装Whisperpip install openai-whisper# 安装音频处理依赖pip install ffmpeg-python pydub
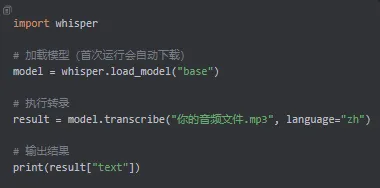
第二步:三行代码实现语音转文字
就这三行,搞定!是不是比你想象的要简单得多?
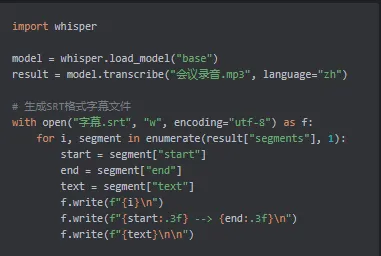
第三步:进阶功能——生成带时间轴的字幕
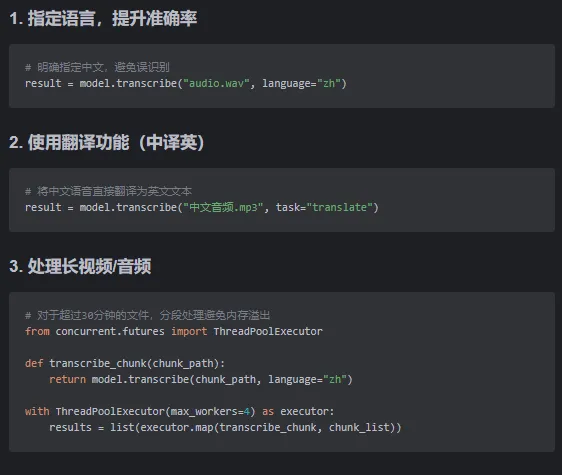
进阶技巧:让识别更准确
实战场景应用
场景一:会议录音转文字
直接把录音文件丢给Whisper,几分钟就能拿到完整的会议纪要文本,还带时间戳,方便定位关键信息。
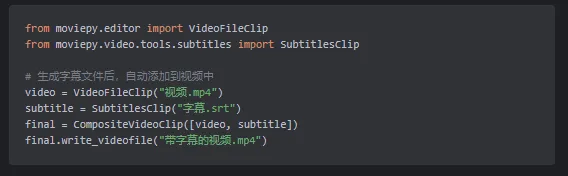
场景二:视频自动加字幕
结合moviepy库,可以实现视频+字幕一键合成:
场景三:实时语音识别
配合sounddevice库,还能实现麦克风实时转录,适合做会议实时记录或语音助手。
场景四:视频音频转录文字
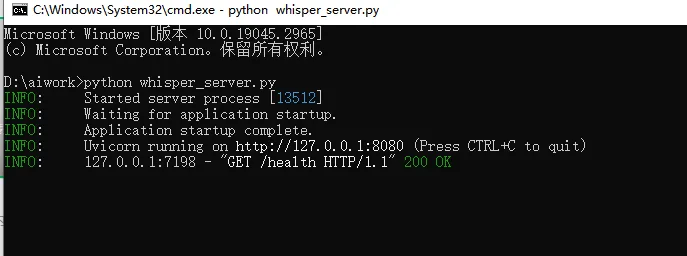
from fastapi import FastAPI, File, UploadFilefrom fastapi.responses import JSONResponseimport uvicornimport tempfileimport osfrom faster_whisper import WhisperModelimport ctranslate2app = FastAPI()# 模型配置 模型选择:如果需要调整模型大小,只需修改 model_size = "small",可选项为:tiny, base, small, medium, large。model_size ="small"# 指定模型下载目录为 D 盘model_dir ="D:/aiwork/whisper-models"# 确保模型目录存在os.makedirs(model_dir, exist_ok=True)# 重要: 使用新版API加载模型# 先通过 ctranslate2 的 Whisper 类指定模型路径model_path = os.path.join(model_dir,f"faster-whisper-{model_size}")# 检查模型是否已下载,如果没有则先下载ifnot os.path.exists(model_path): print(f"模型 {model_size} 未在 {model_path} 找到,准备下载...")# 这里会触发 faster-whisper 自动下载到 model_dir# 但新版需要先创建一个临时模型对象来触发下载 temp_model = WhisperModel(model_size, device="cpu", compute_type="int8")# 获取实际下载路径并移动import shutilfrom huggingface_hub import snapshot_download# 下载模型到指定目录 snapshot_download( repo_id=f"Systran/faster-whisper-{model_size}", local_dir=model_path, local_dir_use_symlinks=False,) print(f"模型下载完成到: {model_path}")# 加载模型model = WhisperModel(model_path, device="cpu", compute_type="int8")@app.post("/v1/audio/transcriptions")asyncdef transcribe(file: UploadFile = File(...)):# 保存上传的音频到临时文件with tempfile.NamedTemporaryFile(delete=False, suffix=".mp3")as tmp: content =await file.read() tmp.write(content) tmp_path = tmp.nametry:# 使用 faster-whisper 进行转录 segments, info = model.transcribe(tmp_path, language="en") full_text =" ".join([seg.text for seg in segments])return{"text": full_text}finally:# 清理临时文件if os.path.exists(tmp_path): os.unlink(tmp_path)@app.get("/health")asyncdef health():return{"status":"ok"}if __name__ =="__main__": uvicorn.run(app, host="127.0.0.1", port=8080)
常见问题解决
Q:报错“ffmpeg not found”?A:需要安装FFmpeg。Windows用户去ffmpeg官网下载,添加到系统PATH即可。
Q:处理中文时识别效果不好?A:务必指定language="zh"参数,同时确保音频采样率为16kHz单声道。
Q:模型下载太慢?A:首次运行会下载模型文件(base约142MB),建议使用稳定的网络环境,或从Hugging Face手动下载放入缓存目录。
Q:跑大型模型内存不足?A:换用tiny或base模型,或者使用faster-whisper这个优化版本,内存占用降低80%。
写在最后
Whisper让语音转文字从“专业开发者的专属工具”变成了“人人都能用的效率神器”。无论你是内容创作者、上班族还是科研工作者,这套工具都能帮你节省大量时间和精力。
从今天开始,让Whisper帮你把声音变成文字吧!
如果你觉得这篇教程有用,欢迎点赞、收藏、转发!有任何问题,评论区见~
 10个月宝宝每天需要喝多少奶粉?