学数据科学,为什么不能只从 Python 开始? 读:《Discrete Mathematics for Data Science》
- 2026-09-10 20:07:18
先装 Anaconda,学一点 NumPy,再学 Pandas:
import pandas as pddf = pd.read_csv(”data.csv”)df.describe()
一张 CSV 进来,很快就变成 DataFrame。
接下来是清洗、可视化、回归、机器学习。
这条路线当然没问题。工具足够成熟以后,很多原来要自己实现的东西,现在一行函数就能完成。
但 Jack Pope 在《Discrete Mathematics for Data Science》里,偏偏没有这么教。
第一章讲到编程时,他甚至专门问了一句:
Why not use Python or R?
作者的担心不是 Python 或 R 不好,而是工具太好用了以后,一个初学者可能已经能调用现成函数,却还不知道自己究竟在处理什么问题。
所以这本 2026 年出版的书,走了一条有点反常的路线。
它没有从 Pandas、Scikit-learn 开始,而是一路往下:
数据是什么↓数字怎么被机器表示↓逻辑、集合和函数↓递归与算法复杂度↓列表、栈、队列、树、图↓概率、统计、回归↓信息论与高维数据
换句话说,它不是教你怎么更快地操作 DataFrame。
它想让你看看:
DataFrame 下面,到底垫着什么。
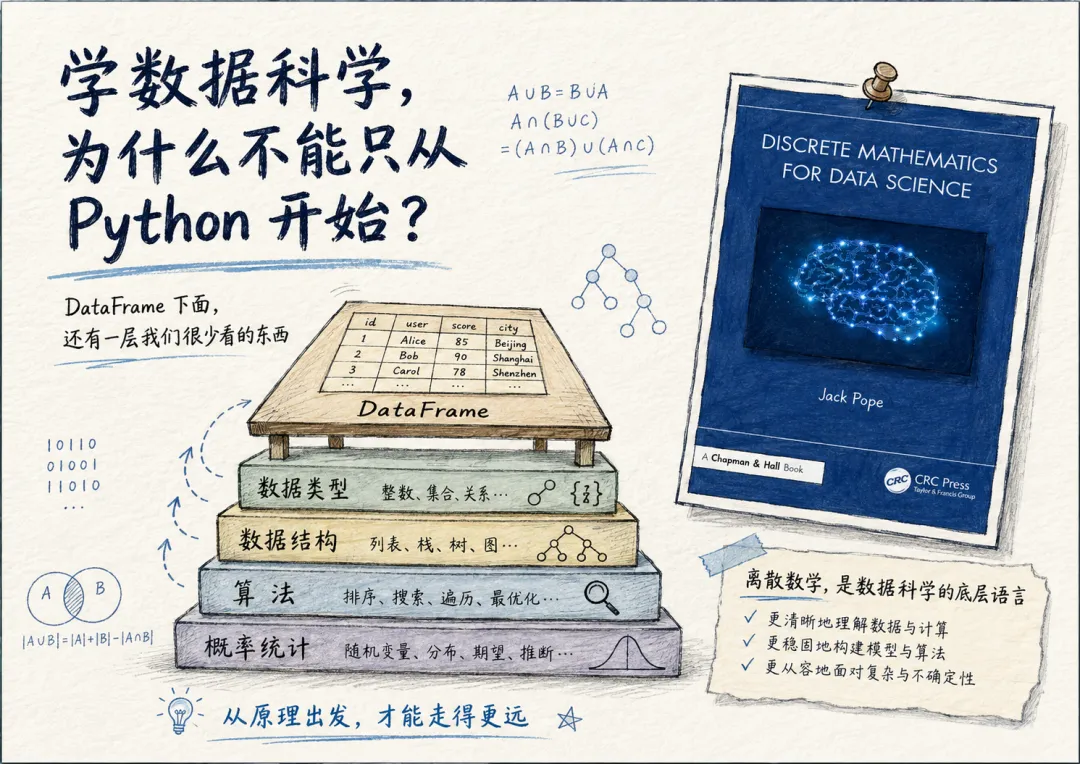
一、这不是一本“用数学包装的数据科学速成书”
先说清楚它是什么。
《Discrete Mathematics for Data Science》由 Jack Pope 编写,CRC Press 2026 年出版。作者把它定位成一门面向数据科学学生的早期数学思维课程。
目标读者不只来自计算机专业,也包括商业、统计、经济、心理等背景。
所以它没有假定读者已经会编程和统计,只要求具备大学代数基础。
这也决定了它并不是一本很深的纯数学教材。
如果已经系统学过离散数学、数据结构、概率统计和计算机组成,书里相当一部分内容会比较基础。
它真正特别的地方,不是某个知识点有多新,而是怎么把这些本来散落在不同课程里的东西重新连起来。
全书 23 章,大体可以压成六块:
正常的数据科学入门课,可能很早就开始做回归。
这本书一直到第 20 章才进入线性回归。
前面十几章都在处理一个更基础的问题:
数据是如何被表示、组织和计算的?
二、DataFrame 看起来是一张表,下面却不是“一张表”
Pandas 把很多东西藏得很好。
我们看到:
name age scoreA 21 87.5B 22 91.0C 20 84.5
很自然会把它理解成“一张表”。
但机器面对的并不是表格这个视觉概念。
往下拆,先是不同的数据类型:
IntegerFloatCharacterBoolean
再往下,是这些数据如何在机器里表示。
书里用了相当多篇幅讲二进制、十六进制、补码、浮点数,以及 IEEE 754。
这部分乍看甚至有点不像“数据科学”。
但它对应的是一些很现实的问题。
比如:
0.1 + 0.2 == 0.3结果为什么可能是:
False不是 Python 算错了。
而是很多十进制小数无法被有限长度的二进制浮点数精确表示。
我们平时直接看到一个 float64,背后其实已经做了:
现实中的数值↓离散表示↓二进制编码↓有限精度存储↓程序里的 float
这就是这本书一个很明确的倾向:
不要只认识抽象之后的接口,也要知道抽象之前发生了什么。
当然,做普通数据分析并不需要每天手算 IEEE 754。
作者也不是要求每个数据科学家去写 CPU 指令。
它更像是在补一层认知:
你平时使用的“数据”,从来不是现实本身,而是现实经过采样、编码、类型和结构处理之后留下来的离散表示。
三、为什么作者连 Python 都不急着让你用
这本书有一个挺有个性的选择。
它没有主要使用 Python 或 R 来演示概念,而是用了作者设计的教学语言epop。
epop 受 Forth 影响,采用大量后缀表达式。
例如普通写法:
3 + 5在后缀形式里是:
3 5 +作者这么做,不是因为 epop 比 Python 更适合真实的数据科学项目。
恰恰相反,真工作里几乎没人会因为这本书换掉 Python。
他的目的比较单纯:
把库先拿走。
Python 最大的优势之一,就是有大量现成抽象:
sum(x)sorted(x)df.mean()model.fit(X, y)
这也是学习时的一个风险。
你可能会很快学会:
这个问题 → 调这个函数但不知道:
为什么能这么算这个函数假设了什么输入的数据结构是什么计算成本是多少结果什么时候会失效
作者因此主张先理解基本问题和计算结构,再使用已经封装好的库。
这个观点不必走到“学数据科学不能用 Python”那么极端。
更准确地说是:
Python 可以是入口,但不应该成为边界。
会调用库,和理解库在替你做什么,是两种不同的能力。
四、从 List 到 Tree,数据结构不是为了应付面试
书的中段开始进入 Data Organization。
作者先把数据集合粗略区分成几类:
无连接Set / Bag线性连接List / Stack / Queue分支连接Tree / Graph
这部分很像传统的数据结构课。
但放进数据科学语境里,意义会稍微不一样。
因为我们习惯了把各种数据最终都“拍平”成表:
row × column可现实中的数据并不天然都是二维表。
比如:
用户 → 好友 → 好友更接近图。
文件系统:
root├── folder A│ ├── file 1│ └── file 2└── folder B
更接近树。
事件按时间到达:
event1 → event2 → event3 → event4更接近序列。
选择什么数据结构,也就选择了什么样的访问、搜索和计算方式。
这也是为什么书里在数据结构之后紧接着讲Big-O。
同样叫“找一个元素”,在不同结构和不同算法里,成本可能完全不一样。
数据小时这些差异经常感觉不到。
数据一大,就变成:
能算和算得完
之间的区别。
所以这部分虽然不“新”,却把一个容易被工具遮住的问题重新暴露出来:
数据不只有值,还有结构。
五、作者其实比“补数学”更在意问题有没有问对
如果只看书名,很容易觉得这是一本从集合、逻辑一路讲到概率统计的教材。
但第一章很不数学。
标题叫:
Your Mind: A Programming Environment
作者先谈的是问题求解。
其中有一段甚至给“大数据”泼了冷水。
他用了一个词:
data fever。
意思大概是,人很容易因为能够收集更多数据,就默认更多数据一定更有价值。
于是:
更多字段+更多变换+更多时间滞后+更多特征
最后得到一个越来越大的数据集。
但规模上去了,相关性未必上去。
作者特别警惕三件事:
为了目标挑数据把复杂度本身当成果把精确误认为相关
这个判断后来又在最后的高维数据章节里出现。
维度不断增加,样本并不会自动跟着变得更充分。
特征越来越多以后,一些变量没有增加信息,反而可能带来多重共线性、样本稀疏和过拟合。
所以这本书从第一章走到最后一章,其实有一条隐藏得很稳定的线:
计算能力不能替你定义问题。
这点甚至比“离散数学很重要”更值得拿走。
因为今天有 Python,明天有 AutoML,现在又有大模型。
工具越来越容易替我们完成“怎么做”。
于是剩下那个问题反而更重要:
你到底在算什么,为什么要算?
六、最后才来到我们熟悉的“数据科学”
到了第 18 章以后,内容终于变得很像通常意义上的数据分析教材:
排列组合↓概率↓统计↓Pearson 相关系数↓线性回归↓多元回归↓重采样↓信息论↓高维数据
第 22 章的信息论尤其能说明全书的结构。
作者从最基础的“symbol”开始,把信息看成符号组成的消息,再讨论概率、噪声、熵、联合熵、条件熵、互信息、信道容量和 Huffman 编码。
这时候前面的内容开始重新接回来:
bit↓symbol↓data↓structure↓probability↓information
到了最后的高维数据,又回到今天机器学习里很熟悉的问题:
维度灾难、样本密度、泛化和过拟合。
所以它不是一本把 23 个数学知识点并排放好的“知识菜单”。
至少从作者的组织方式看,他想建立的是一条从机器表示一直通到数据分析的连续链条。
七、那学数据科学,到底能不能只从 Python 开始?
当然可以从 Python 开始。
甚至对大多数人来说,从 Python 开始可能仍然是效率最高的方式。
先把一个真实问题跑起来:
读数据↓清洗↓画图↓建模↓得到结果
比一开始就学半年数学更容易建立反馈。
所以《Discrete Mathematics for Data Science》并不能证明一种固定的学习顺序:
先学完离散数学↓再碰 Python
我也不觉得这是最好的理解。
这本书真正提醒我的,是另外一件事。
Python、Pandas、Scikit-learn 把很多层封装掉以后,我们很容易产生一种错觉:
DataFrame≈数据本身
实际上下面还有很长一条链:
现实世界↓采样↓离散化↓编码↓数据类型↓数据结构↓算法↓统计与模型↓我们最后看到的结果
平时不需要每层都往下挖。
但当数据出现精度问题、规模问题、结构问题,或者模型结果开始变得奇怪时,知道下面还有这些层,就很重要。
这可能就是这本书最合适的位置。
它不是劝人放弃 Python。
也不是说每个数据分析师都应该重新学一遍计算机底层。
而是提醒我们:
工具让很多事情变简单了,但被工具藏起来的东西,并没有因此消失。
DataFrame 下面,确实还有一层。
而且不止一层。
#数据科学 #离散数学 #Python #数据结构 #数学基础
恰饭👇:
