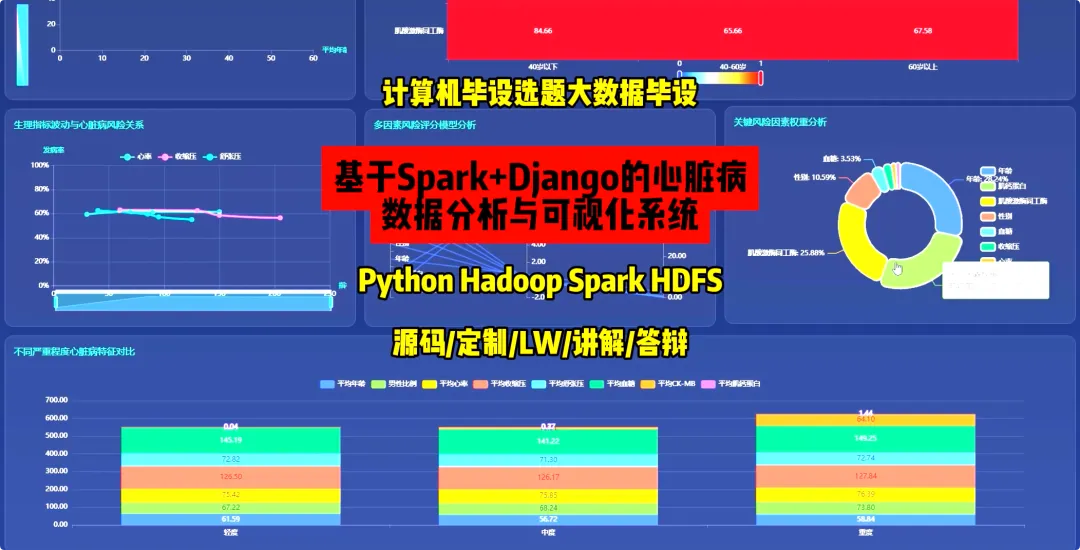
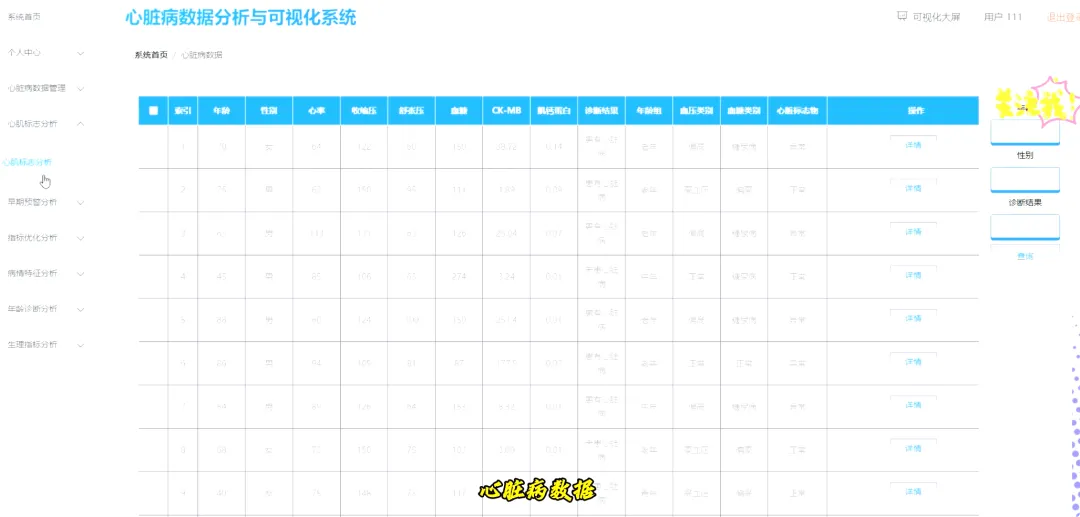
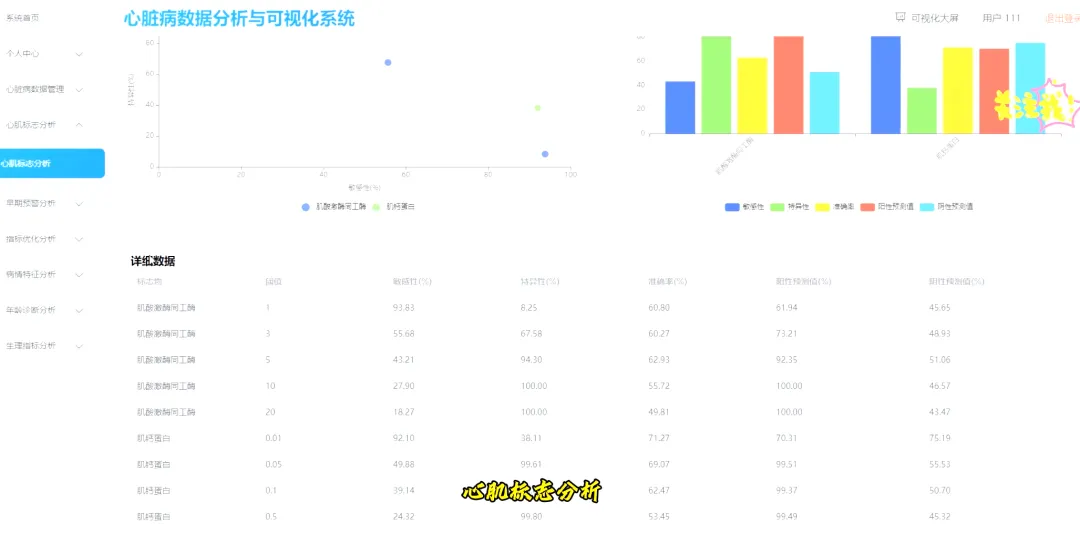
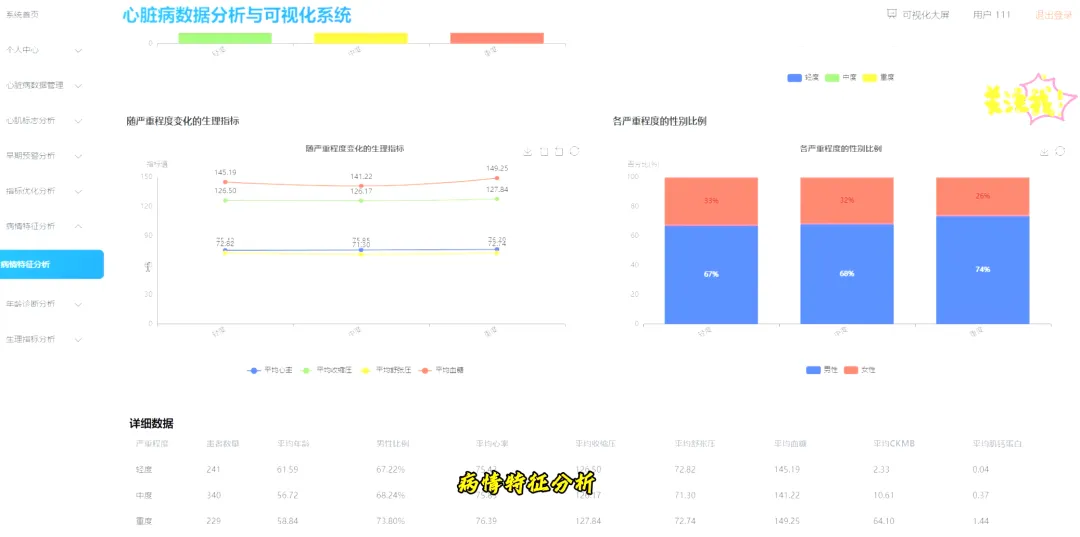
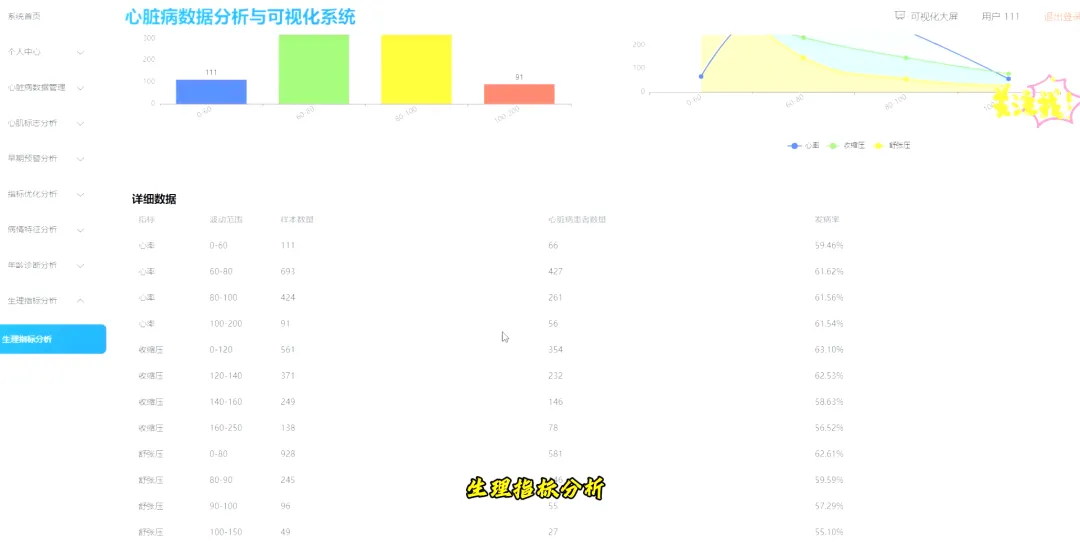
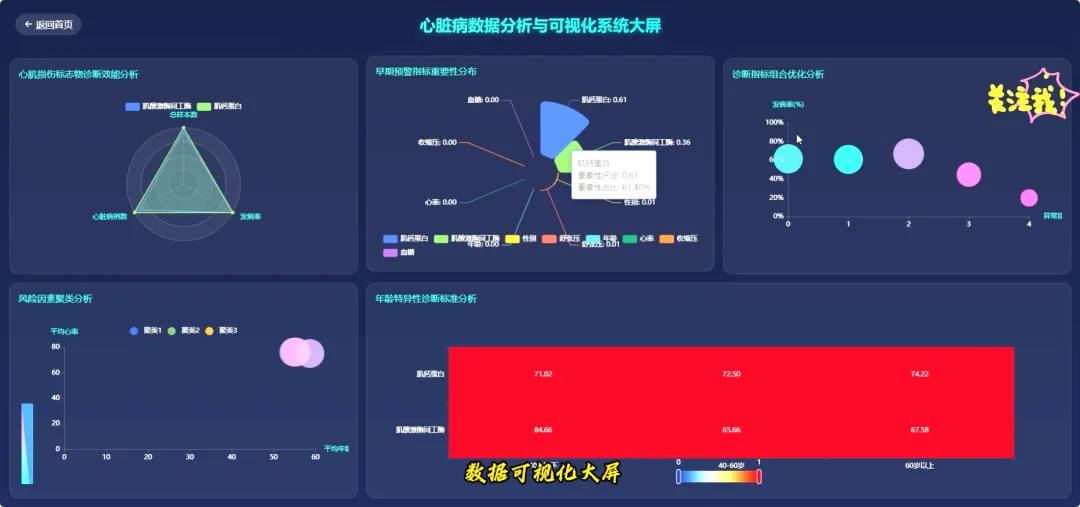
from pyspark.sql import SparkSessionfrom pyspark.sql.functions import col, avg, count, whenfrom pyspark.ml.feature import VectorAssemblerfrom pyspark.ml.clustering import KMeansspark = SparkSession.builder.appName("HeartDiseaseAnalysis").getOrCreate()def analyze_demographics_and_risk(df): """ 核心功能1:人口统计学特征与心脏病发病率分析 业务逻辑:读取数据,按年龄段和性别分组,统计各组的心脏病发病率 """ # 注册临时视图以便使用SQL df.createOrReplaceTempView("medical_data") # 执行Spark SQL查询,统计不同年龄段和性别的发病人数与总数 result_df = spark.sql(""" SELECT CASE WHEN Age < 30 THEN 'Under 30' WHEN Age BETWEEN 30 AND 50 THEN '30-50' WHEN Age BETWEEN 51 AND 70 THEN '51-70' ELSE 'Over 70' END as AgeGroup, Gender, COUNT(*) as Total_Count, SUM(CASE WHEN Result = 1 THEN 1 ELSE 0 END) as Disease_Count, (SUM(CASE WHEN Result = 1 THEN 1 ELSE 0 END) * 100.0 / COUNT(*)) as Incidence_Rate FROM medical_data GROUP BY AgeGroup, Gender ORDER BY AgeGroup, Gender """) # 将结果收集并转换为字典列表返回给Django视图 data_list = [{"age_group": row['AgeGroup'], "gender": row['Gender'], "total": row['Total_Count'], "rate": row['Incidence_Rate']} for row in result_df.collect()] return data_listdef analyze_physiological_indicators(df): """ 核心功能2:生理指标与心脏病关系的量化分析 业务逻辑:计算患病组与健康组的关键生理指标平均值,对比差异 """ # 筛选出关键生理指标列 indicators = ["Heart rate", "Systolic blood pressure", "Diastolic blood pressure", "Blood sugar", "CK-MB", "Troponin"] # 按照Result字段分组,计算各项指标的平均值 avg_df = df.groupBy("Result").agg({col: "avg" for col in indicators}) # 整理数据格式,方便前端Echarts直接使用 # 假设0代表健康,1代表患病 healthy_data = avg_df.filter(col("Result") == 0).first() disease_data = avg_df.filter(col("Result") == 1).first() comparison_result = [] if healthy_data and disease_data: for i, indicator in enumerate(indicators): comparison_result.append({ "indicator": indicator, "healthy_avg": healthy_data[i+1], # 跳过第一个Result列 "disease_avg": disease_data[i+1] }) return comparison_resultdef perform_risk_clustering_analysis(df): """ 核心功能3:基于生理指标的风险聚类分析 业务逻辑:利用KMeans算法对生理指标进行聚类,识别高风险人群模式 """ # 选择用于聚类的特征列 feature_cols = ["Heart rate", "Systolic blood pressure", "Diastolic blood pressure", "Blood sugar", "CK-MB", "Troponin"] # 处理空值,填充为0 df_clean = df.na.fill(0, subset=feature_cols) # 使用VectorAssembler将特征列合并为特征向量 assembler = VectorAssembler(inputCols=feature_cols, outputCol="features") vec_df = assembler.transform(df_clean) # 构建KMeans模型,设置K=3将人群分为低、中、高风险三类 kmeans = KMeans(k=3, seed=1, featuresCol="features", predictionCol="prediction") model = kmeans.fit(vec_df) # 获取聚类中心点,分析各簇的特征均值 centers = model.clusterCenters() cluster_info = [] for i, center in enumerate(centers): cluster_info.append({ "cluster_id": i, "center_values": center.tolist() }) # 将预测结果附加回原数据并统计各簇的患病比例 transformed = model.transform(vec_df) cluster_stats = transformed.groupBy("prediction").agg( count("*").alias("count"), avg("Result").alias("disease_rate") ).orderBy("prediction").collect() # 合并中心点数据和统计信息 final_result = [] for stat in cluster_stats: cid = stat['prediction'] center_data = cluster_info[cid]['center_values'] final_result.append({ "cluster": cid, "user_count": stat['count'], "risk_probability": float(stat['disease_rate']), "features_avg": center_data }) return final_result
 10个月宝宝每天需要喝多少奶粉?