我们来拆解典型的 Python 爬虫入门代码。这段代码涵盖了 Python 网络请求的两个主流库:标准库 urllib 和第三方库 requests,并且演示了 GET 请求、POST 请求、请求头伪装、参数传递、JSON 解析、文件保存 等核心知识点。from encodings import utf_8from urllib.request import urlopenurl = "https://www.baidu.com"resp = urlopen(url)with open("baidu.html",mode="w",encoding="utf-8") as f: f.write(resp.read().decode()) print("over")
from urllib.request import urlopen
url = "https://www.baidu.com"
urlopen 向百度服务器发送一个 GET 请求。
返回的 resp 是一个 HTTPResponse 对象,可以理解为服务器返回的“响应包”,里面包含状态码、响应头、响应体等信息。
注意:urlopen 默认的 User-Agent 是 Python-urllib/3.x,很多网站会识别出这是爬虫并拒绝访问。百度首页通常可以访问,但有些网站会返回 403。
with open("baidu.html", mode="w", encoding="utf-8") as f:
使用 with 语句打开(或创建)当前目录下的 baidu.html 文件。
mode="w":以写入模式打开,如果文件不存在则创建,存在则清空内容。
encoding="utf-8":指定写入文件时使用 UTF-8 编码,避免中文乱码。
as f:文件对象赋值给变量 f,with 块结束后自动关闭文件。
运行结果
执行后,当前目录下会生成一个 baidu.html 文件,打开后可以看到百度首页的 HTML 源代码(可能会因为缺少样式而显示不完整,但源代码是完整的)。控制台输出 over。
我们接下来再看一段代码:
import requestsquery = input("输入你要搜索的内容:")url = f"https://cn.bing.com/search?q={query}"headers = { "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/138.0.0.0 Safari/537.36 Edg/138.0.0.0"}resp = requests.get(url, headers=headers)print(resp)print(resp.text)
现在我们逐步解释代码:
query = input("输入你要搜索的内容:")
url = f"https://cn.bing.com/search?q={query}"
headers = { "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/138.0.0.0 Safari/537.36 Edg/138.0.0.0"}
resp = requests.get(url, headers=headers)
核心知识点
GET 请求:参数拼接在 URL 中,使用 requests.get(url, headers=headers)。
请求头伪装:通过 User-Agent 模拟浏览器。
响应对象:resp 包含状态码、响应头、响应体等,resp.text 获取字符串,resp.content 获取 bytes。
运行结果
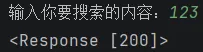
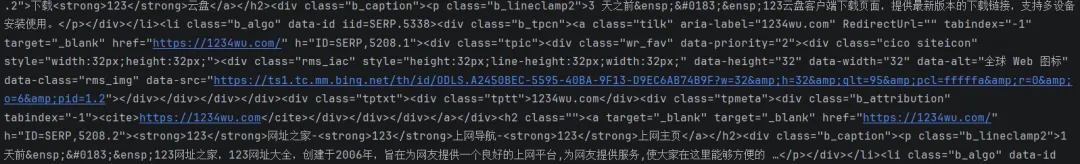
用户输入“Python爬虫”,程序会请求必应搜索,然后打印出响应状态码和搜索结果的 HTML 源代码。控制台会输出很多 HTML 代码。
例如:在终端中输入123,就会返回状态码200,翻找源代码就会找到与123相关的内容。
接下来我们来看一下如何用python调用百度翻译:import requestss = input("请输入你要翻译的单词:")dat = { "kw": s}url = "https://fanyi.baidu.com/sug"resp = requests.post(url, data=dat)print(resp.json())
url = "https://fanyi.baidu.com/sug"
resp = requests.post(url, data=dat)
核心知识点
POST 请求:使用 requests.post(url, data=data),数据放在请求体中,适合提交表单。
表单数据与 JSON 数据的区别:
data= 参数用于发送表单数据(Content-Type: application/x-www-form-urlencoded)。
如果要发送 JSON 数据,应该使用 json= 参数(Content-Type: application/json)。
这里百度翻译接口期望的是表单数据,所以用 data=。
JSON 解析:resp.json() 自动将 JSON 字符串转为 Python 对象,非常方便。
运行结果
用户输入 apple,程序会输出类似下面的 JSON 数据:
接下来我们来看看如何爬取豆瓣榜单:
import requestsparam = { "type": "24", "interval_id": "100:90", "action": "", "start": "0", "limit": "20"}headers = { "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/138.0.0.0 Safari/537.36 Edg/138.0.0.0"}url = "https://movie.douban.com/typerank"resp = requests.get(url=url, params=param, headers=headers)resp.encoding = "utf-8"print(resp.text)
param = { "type": "24", # 电影类型 "interval_id": "100:90", # 评分区间 "action": "", # 动作 "start": "0", # 起始位置 "limit": "20" # 每页数量}
这是一个字典,包含了请求豆瓣电影排行榜所需的多个查询参数。
type:电影类型,24 可能代表“喜剧”等。
interval_id:评分区间,100:90 表示 9.0 到 10.0 分。
action:空字符串,可能是一个占位参数。
start:起始位置,0 表示从第一条开始。
limit:每页数量,20 表示获取 20 条。
这些参数会被拼接到 URL 后面,形成查询字符串。
resp = requests.get(url=url, params=param, headers=headers)
核心知识点
多个查询参数:使用 params 字典传递,避免手动拼接 URL,自动处理 URL 编码。
手动设置编码:当自动解码不正确时,可以通过 resp.encoding 属性手动指定编码。
请求头伪装:同样使用 User-Agent 模拟浏览器。
运行结果
程序会打印豆瓣电影排行榜页面的 HTML 源代码(部分截图)。由于豆瓣有反爬机制,可能返回 418 或需要验证码,或者返回的 HTML 中数据是动态加载的,直接打印可能看不到电影列表。但作为教学示例,它演示了多参数 GET 请求的写法。
四段代码对比总结
| 代码段 | 库 | 请求类型 | 参数传递方式 | 主要知识点 |
|---|
| 第一段 | urllib | GET | URL 直接拼接 | urlopen、read、decode、文件保存 |
| 第二段 | requests | GET | URL 拼接 | requests.get、headers、resp.text |
| 第三段 | requests | POST | data 表单 | requests.post、data、resp.json |
| 第四段 | requests | GET | params 字典 | params、resp.encoding |
库的选择
GET 与 POST 的区别
GET:参数放在 URL 后面,适合获取数据,长度有限。
POST:参数放在请求体中,适合提交数据,更安全,长度无限制。
在 requests 中,GET 用 params 传参,POST 用 data(表单)或 json(JSON 数据)传参。
请求头伪装
响应处理
resp.read()(urllib)返回 bytes,需 .decode() 转为字符串。
resp.text(requests)自动解码为字符串,必要时可手动设置 resp.encoding。
resp.json() 直接解析 JSON 响应为 Python 字典/列表。
参数传递
遵守目标网站的 robots.txt 协议。
控制请求频率,避免对服务器造成压力。
仅用于学习目的,不爬取敏感或隐私数据。
请不要盲目、无节制爬取网站内容,遵守相关法律法规