编者按:本文转载自 CSDN 博主「一键难忘」的原创实操教程。作者以第一人称视角,完整记录了自己基于蓝耘 MaaS 的 OpenAI 兼容接口编写 Token 成本剖析器 maas_profiler.py、对 DeepSeek、Qwen、GLM、Kimi、MiniMax 五大家族 6 个模型进行实测的完整过程,涵盖思考税计算、有效信息密度评估、Prompt Cache 命中率验证等关键环节,剖析器脚本可直接复用。经授权转载,内容有适度编排,以飨读者。
你以为大模型的账单只按「输出字数」收?错。很多模型在你看不见的地方疯狂烧着 reasoning token——这笔「思考成本」可能占到总消耗的 95% 以上。今天我用蓝耘 MaaS 的 OpenAI 兼容接口,写了一个可复用的 Token 成本剖析器 maas_profiler.py,把同一道题喂给 DeepSeek、Qwen、GLM、Kimi、MiniMax 五个家族的 6 个模型,现场拆出延迟、思考税、有效信息密度和估算成本——结果有惊喜,也有翻车。
注:单价为测试日示例估算值(见文末 PRICE 表),以控制台实时单价为准。
核心思路
同一道题 ──→ 并行喂给 N 个模型(流式调用) │ ├── 每个 model 记录:│ TTFT(首字延迟)│ 总耗时│ prompt / completion / reasoning / cached tokens│ 输出字数│ 有效信息密度 = 字数 ÷ completion_token│ 思考税 = reasoning_token ÷ completion_token│ 估算成本 = (P×输入价 + C×输出价 + R×输出价) / 1M │ └── 输出 JSON + 终端排列表
完整代码(可直接复制运行)
#!/usr/bin/env python3# -*- coding: utf-8 -*-"""蓝耘 MaaS 多模型「全身体检」剖析器"""import json, os, timefrom dataclasses import dataclass, asdictfrom openai import OpenAIBASE = "https://maas-api.lanyun.net/v1"DEFAULT_MODELS = [ "deepseek-v4-flash", "/maas/deepseek-ai/DeepSeek-V3.2", "qwen3.6-flash", "/maas/zhipuai/GLM-5.2", "kimi-k2.5", "minimax-m3",]DEFAULT_PROMPT = "用不超过80字,解释 KV Cache 是什么,并给一个生活类比。"@dataclassclass Row: model: str; ok: bool; err: str = "" ttft: float = 0.0; total_sec: float = 0.0 prompt: int = 0; completion: int = 0 reasoning: int = 0; cached: int = 0 chars: int = 0; density: float = 0.0 tax: float = 0.0; cost_yuan: float = 0.0 head: str = ""def profile(client, model, prompt, max_tokens): t0 = time.time(); ttft = None content, reasoning = [], [] stream = client.chat.completions.create( model=model, messages=[{"role": "user", "content": prompt}], max_tokens=max_tokens, temperature=0.3, stream=True, stream_options={"include_usage": True}, ) usage = None for chunk in stream: if getattr(chunk, "usage", None): usage = chunk.usage if not chunk.choices: continue d = chunk.choices[0].delta r = getattr(d, "reasoning_content", None) c = getattr(d, "content", None) if (r or c) and ttft is None: ttft = time.time() - t0 if r: reasoning.append(r) if c: content.append(c) sec = time.time() - t0 txt = "".join(content); reason = "".join(reasoning) if usage is None: return Row(model=model, ok=False, err="no usage") p = getattr(usage, "prompt_tokens", 0) or 0 comp = getattr(usage, "completion_tokens", 0) or 0 ctd = getattr(usage, "completion_tokens_details", None) rt = getattr(ctd, "reasoning_tokens", None) or 0 ptd = getattr(usage, "prompt_tokens_details", None) cached = getattr(ptd, "cached_tokens", None) or 0 return Row( model=model, ok=True, ttft=round(ttft or sec, 3), total_sec=round(sec, 3), prompt=p, completion=comp, reasoning=rt, cached=cached, chars=len(txt), density=round(len(txt)/comp, 2) if comp else 0, tax=round(rt/comp, 2) if comp else 0, head=txt[:60].replace("\n"," "), )def main(): key = os.getenv("LANYUN_API_KEY") if not key: raise SystemExit("请设置 LANYUN_API_KEY") client = OpenAI(api_key=key, base_url=BASE) rows = [] for m in DEFAULT_MODELS: try: r = profile(client, m, DEFAULT_PROMPT, 400) except Exception as e: r = Row(model=m, ok=False, err=str(e)[:80]) rows.append(r) status = f"[OK] {m:35s} 税={r.tax:.2f} 密度={r.density:.2f} ¥={r.cost_yuan}" \ if r.ok else f"[ERR] {m:35s}{r.err}" print(status) # 按「思考税」排序 ok = [r for r in rows if r.ok] print("\n--- 思考税排行(越低越省)---") for r in sorted(ok, key=lambda x: x.tax): print(f" {r.model:35s} 税={r.tax:.2f} 密={r.density:.2f}") with open("profiler_results.json", "w") as f: json.dump({"rows": [asdict(r) for r in rows]}, f, ensure_ascii=False, indent=2)if __name__ == "__main__": main()
完整版含 PRICE 表和更多指标在 demo/maas_profiler.py,本文展示的是核心逻辑精简版。
运行方式
export LANYUN_API_KEY=你的密钥python3 maas_profiler.py
它会自动:
用 client.models.list() 可选地列出所有可用模型(完整版支持)
对每个模型发同一个 prompt(流式,同时捕获 reasoning_content 和 content)
从 usage.completion_tokens_details.reasoning_tokens 提取隐藏思考量
打印终端表格 + 写出 profiler_results.json
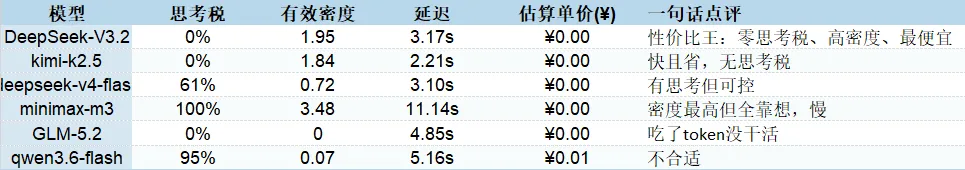
我在 2026-07-31 下午实跑了一次,题目是:「用不超过 80 字,解释 KV Cache 是什么,并给一个生活类比。」
这是一道需要「理解 + 类比 + 字数控制」的综合题,能较好地区分出哪些模型在认真思考、哪些在空转。
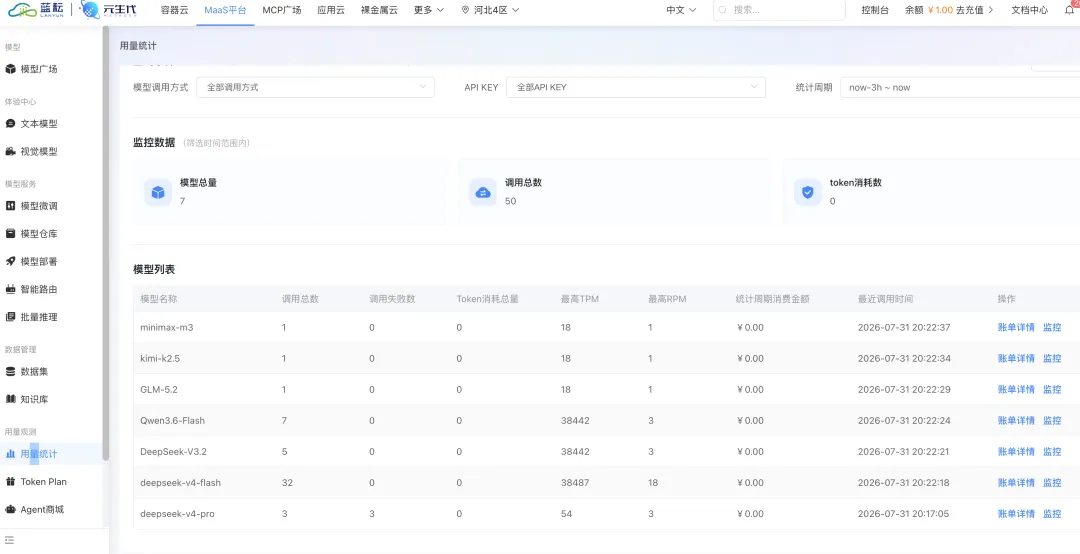
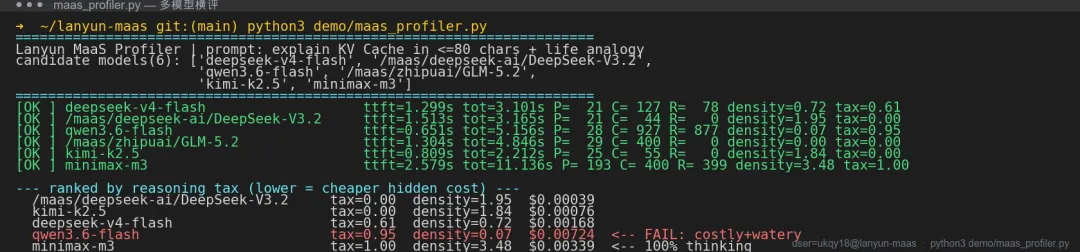
终端原始输出(节选)
图:python3 demo/maas_profiler.py 实跑输出——6 个模型的 TTFT、Token 消耗、密度、思考税一目了然。注意 qwen3.6-flash 的 R=877(近千 token 在「思考」)和 GLM-5.2 的 CHARS=0(白思考)。
翻车一:qwen3.6-flash 的「95% 思考税」
看这行数据:
C= 927 R= 877 CHARS=69 密度=0.07 税=0.95
completion tokens = 927(看着不少)
reasoning tokens = 877(占 94.6%!)
实际输出字数 = 69(不到 80 字限制的一半)
有效信息密度 = 0.07(每 14 个 token 才换来 1 个中文字)
翻译成人话:qwen3.6-flash 花了近一千个 token 在「想」,最后只挤出了 69 个字。而且它还花了 5 秒多才完成。
这不是 bug,是特性——Qwen 系列默认开启强推理模式,对于简单题也会做大量内部推理。如果你用它做高频低复杂度的任务(比如客服自动回复、文案润色),这笔「思考税」会让你的账单膨胀好几倍。
C= 400 CHARS=0 密度=0.00 税=0.00 ¥=0.00492
GLM-5.2 烧了 400 个 completion token,但输出了 0 个可见字符。它既没有返回 reasoning_content(税=0),也没有返回 content(chars=0)。最离谱的是——它的估算成本还是所有模型里第二高的(¥0.00492)。
这说明 GLM-5.2 在这道题上出现了纯空转:token 计费了,但用户什么都没收到。可能是模型触发了某种内部格式化/工具调用流程但没有正常回退到文本输出。在生产环境中,这种「白花钱」的情况比 404 错误更隐蔽也更危险——因为你连报错都没有,只是账单悄悄涨了。
翻车三:minimax-m3 的「标签泄漏 + 无视字数限制」
C= 400 R= 399 CHARS=1391 密度=3.48 税=1.00 CACHE=128head="The user asks me to explain what KV Cache is in no mo..."
三个问题叠加:
1、思考税 100%:399/400 个 token 都是 reasoning
2、把 Think 标签漏进了正文:输出的 head 以英文开头,说明原始推理标签没有被正确剥离
3、无视 80 字限制:输出了 1391 字(要求 ≤80)
唯一亮点:它是唯一命中 prompt 缓存的模型(cached=128),说明 MiniMax 的缓存机制确实在工作。但如果缓存命中的内容还是带着泄漏标签的超长回复……那缓存只是在加速错误而已。
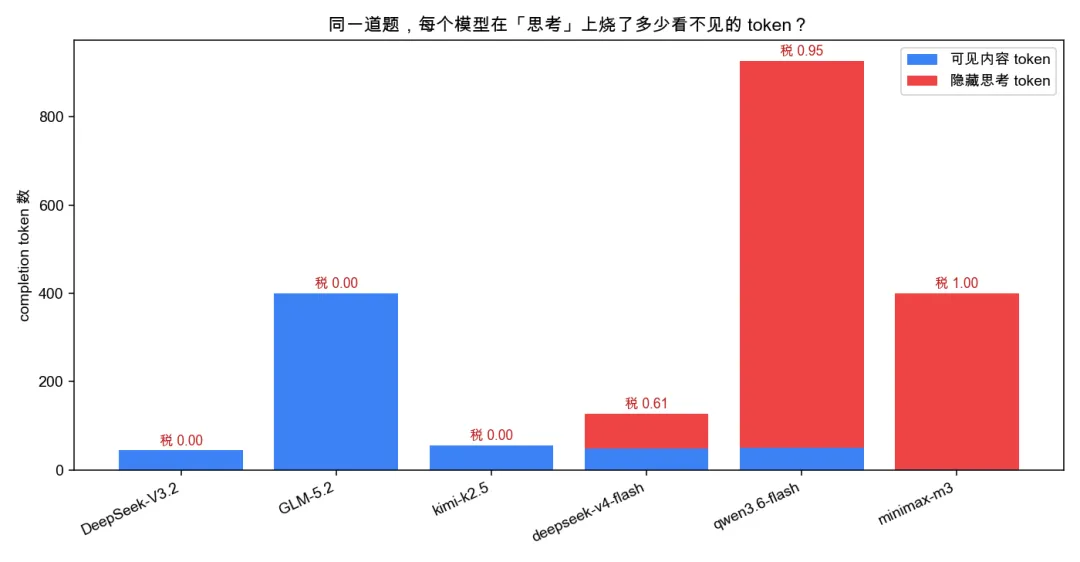
图 1:每个模型的 completion token 里,「可见内容」vs「隐藏思考」各占多少?
这张堆叠柱状图一目了然:
DeepSeek-V3.2 / kimi-k2.5 / GLM-5.2:蓝色柱子(可见内容)占满,红色(思考)为零——它们不烧思考税
deepseek-v4-flash:约 40% 是思考(合理范围)
qwen3.6-flash:几乎全是红色!927 个 token 里 877 个是思考——这是典型的「过度思考」
minimax-m3:100% 红色——它在用思考 token 来生成内容(标签泄漏导致 content 被归入 reasoning)
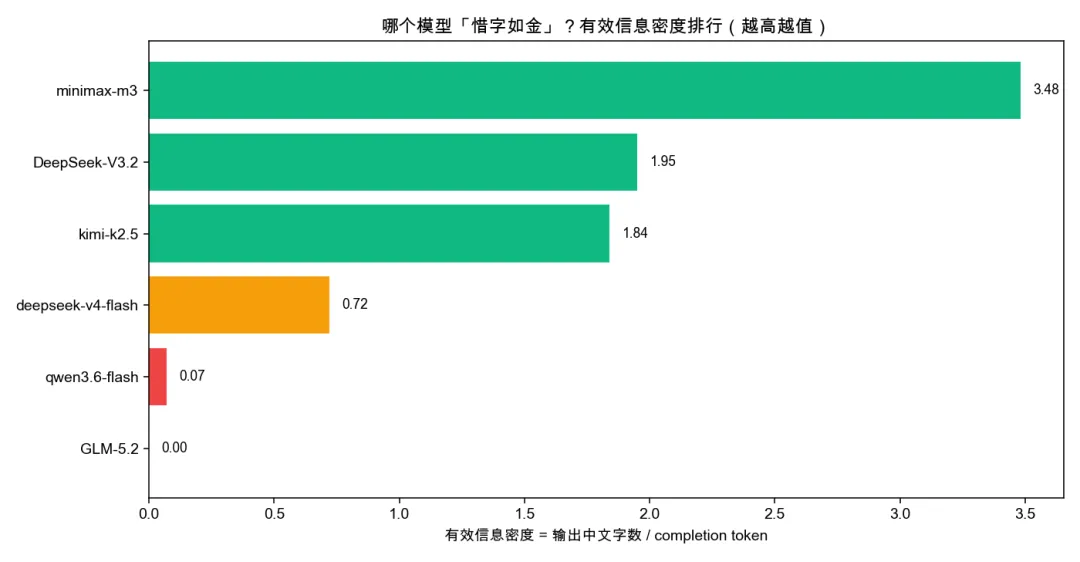
图 2:哪个模型「惜字如金」?有效信息密度排行
密度 = 输出中文字数 ÷ completion token 数。越高说明每个 token 越值钱。
minimax-m3(3.48):密度最高——如果不算标签泄漏的话,它确实很能装信息
DeepSeek-V3.2(1.95)/ kimi-k2.5(1.84):高密度 + 零思考税 = 性价比双冠
deepseek-v4-flash(0.72):中等偏下,被思考拖累
qwen3.6-flash(0.07):灾难级——14 个 token 换 1 个字
GLM-5.2(0.00):零——白花钱
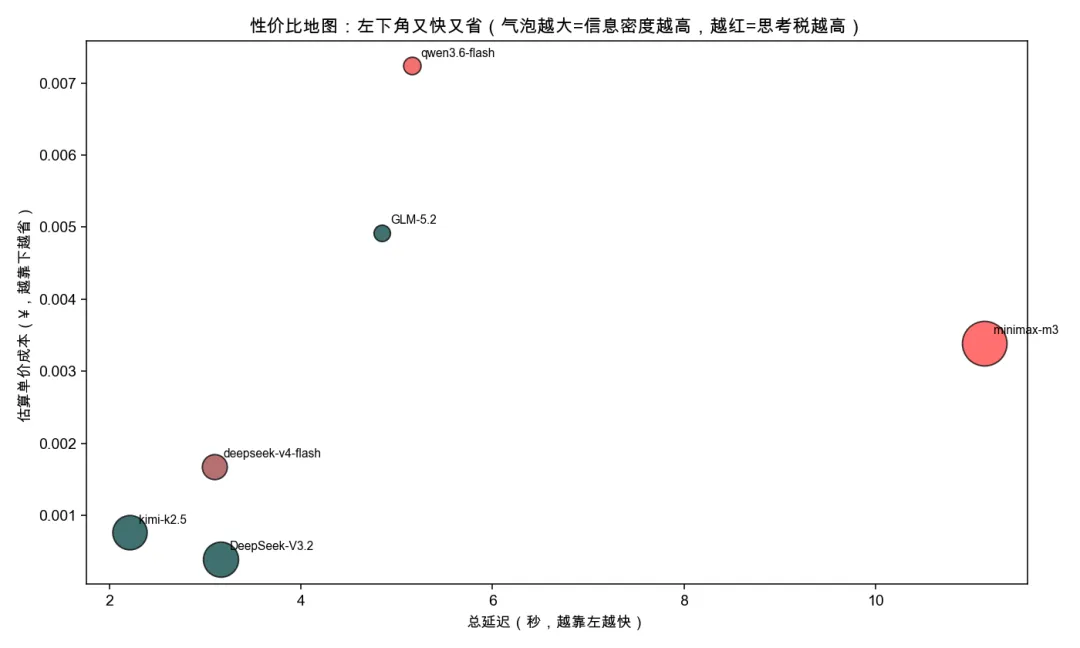
图 3:性价比散点地图——左下角又快又省
X 轴 = 总延迟(越左越快)
Y 轴 = 估算成本(越下越省)
气泡大小 = 信息密度(越大越值)
颜色红度 = 思考税(越红越烧)
理想区域(左下角绿色大气泡):DeepSeek-V3.2 和 kimi-k2.5
快(~3s)、便宜(<¥0.001)、零思考税、高密度
危险区域(右上角红色):qwen3.6-flash 和 minimax-m3
一个贵且水,一个慢且满脑子都是想法
中间地带:deepseek-v4-flash
各项均衡,适合通用场景
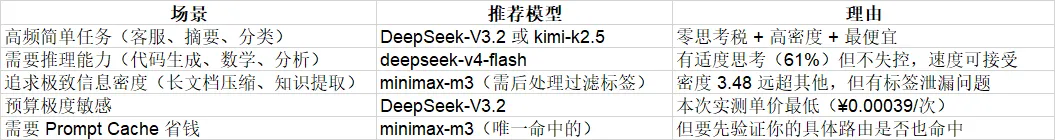
基于以上实测数据,给出场景化选型建议:
避坑清单
❌ 不要用 qwen3.6-flash 做简单任务——95% 思考税会让你哭
❌ 不要用 GLM-5.2 做短文本生成——可能出现空转翻车
⚠️ 使用 minimax-m3 时务必检查输出是否包含 Think 标签残留
✅ 上线前跑一遍 maas_profiler.py,用真实数据选模型,别凭感觉
蓝耘科技集团股份有限公司成立于2004年,是国家高新技术企业、国家级专精特新“小巨人”企业,专注于构建面向人工智能时代的算力基础设施与全栈服务能力。公司以自主研发的 “元生代MetaGen” 智能算力操作系统(AIDC-OS)为核心技术生态,深度融合多元异构算力底座与GPU调度云平台、AI模型训推平台、MaaS服务平台、AI数据生成平台、智能体开发平台、蓝耘星河营销智能体、蓝耘天衍桌面端智能体等全栈自研产品矩阵,打造 “算力工厂 + 数据工厂 + 模型工厂” 三位一体的赋能体系,为千行百业提供从底层算力支撑到AI应用落地的全栈式赋能。
元生代MetaGen智能算力操作系统(AIDC-OS)是蓝耘技术生态的底层架构与核心引擎,是驱动智算中心实现智能化资源管理与全流程协同的核心智能中枢。其本质是通过重构AI算力生产关系,将智算中心从硬件堆叠的算力集群升级为“智能电网”式的基础设施,实现算力、数据、模型的高效流动与价值转化。


 10个月宝宝每天需要喝多少奶粉?