谁在“盯上”你的住院记录?10行Python代码,揪出藏在数据里的秘密
- 2026-09-25 14:48:31
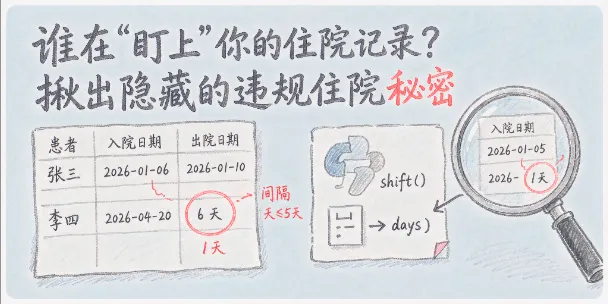
引子:一个来自医保审核员的困惑
上个月,我的一位读者私信我:
“我们科室在审核医保数据时,发现有些患者一年内住院好几次。领导要求筛查出**‘同一身份证、同一年住院2次以上,且入院日期和上次出院日期相隔5天内’**的情况。
我用Excel手工筛了一周,眼睛都快瞎了。而且有些患者住了3次、4次,每次间隔都要算,Excel根本搞不定。有没有什么自动化的办法?”
当然有。
这个问题看似简单,但用Excel处理确实非常痛苦——因为你需要逐行比较同一患者的上一次出院日期和本次入院日期,还要按年分组。
而用Pandas,十几行代码就能解决。
今天我就把这套完整的方案分享出来,希望能帮到同样被这个问题困扰的朋友。
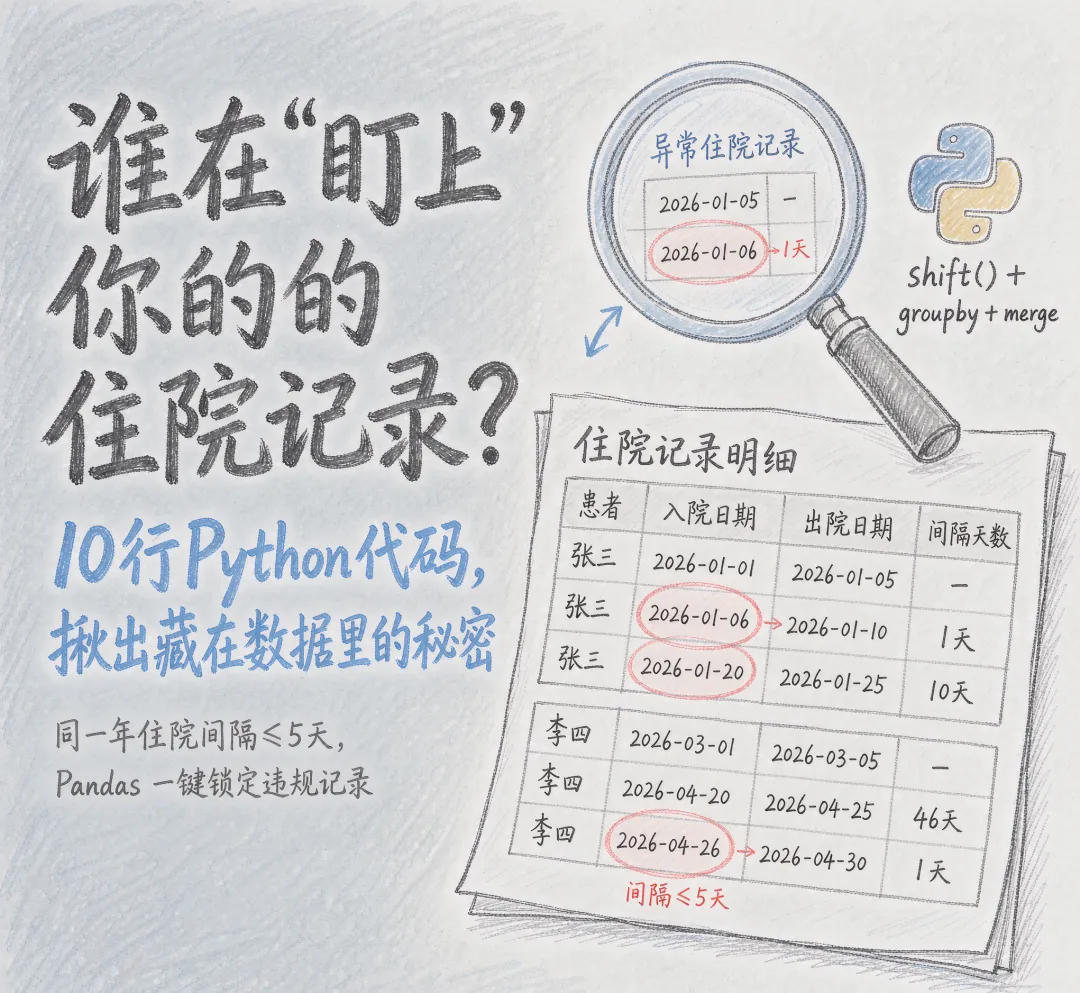
一、先看清楚需求,别踩坑
这个需求有几个关键点,稍不注意就会漏数据:
💡最容易踩的坑:很多人直接筛“间隔≤5天的记录”,结果只看到了第2次、第3次住院,却漏掉了患者第1次住院的信息——而第1次住院的费用和诊断,恰恰是判断“是否违规入院”的关键证据。
二、数据准备
假设我们的数据长这样(文件:hospital_data.csv):
张三:第1次1月1日入院,1月5日出院;第2次1月6日入院(间隔1天),第3次1月20日入院(距上次出院10天)。符合条件。 李四:第1次3月1日入院,第2次4月20日入院(间隔46天),第3次4月26日入院(距上次出院1天)。符合条件。 王五:只住了1次,不符合条件。
三、核心代码(逐行拆解)
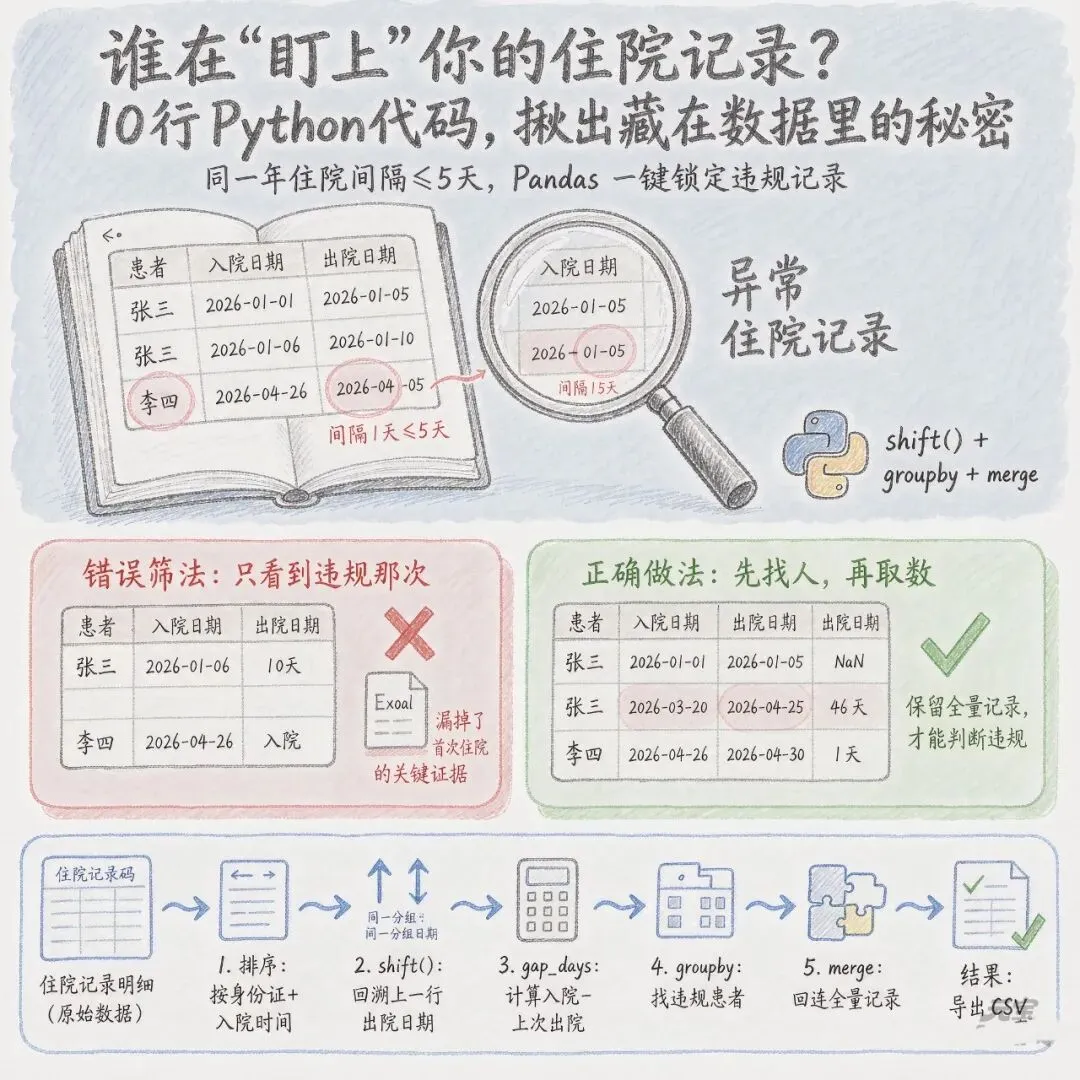
1. 数据读取与预处理
import pandas as pd# 1. 读取数据df = pd.read_csv('hospital_data.csv',parse_dates=['入院日期', '出院日期'])# 2. 重命名列(方便写代码)df.rename(columns={'身份证号码': 'id_card','入院日期': 'admission_date','出院日期': 'discharge_date'}, inplace=True)# 3. 提取入院年份df['year'] = df['admission_date'].dt.year# 4. 按身份证和入院时间排序(必须!)df.sort_values(['id_card', 'admission_date'], inplace=True)
⚠️这一步最容易忘。如果没有排序,shift() 取到的“上一行”可能是乱序的,结果全错。
2. 计算间隔天数
# 5. 核心:计算上一次的出院日期df['prev_discharge'] = df.groupby(['id_card', 'year'])['discharge_date'].shift(1)
shift(1) 的作用是取同一分组内上一行的值。
用张三的数据来演示:
# 6. 计算相隔天数df['gap_days'] = (df['admission_date'] - df['prev_discharge']).dt.days# 7. 标记“短间隔再入院”(本次入院距上次出院≤5天)df['is_short_gap'] = ((df['gap_days'] >= 0) &(df['gap_days'] <= 5) &(df['gap_days'].notna()))
为什么要求 >=0?防止数据录入错误导致入院日期早于上次出院日期,出现负数干扰判断。
3. 关键一步:保留全量记录
这时候,如果直接筛 df[df['is_short_gap'] == True],只能得到违规的那几行,患者的首次住院记录就丢了。
正确的做法:先找人,再取数。
# 8. 分组汇总:找出“有问题”的患者target_summary = (df.groupby(['id_card', 'year']).agg(total_visits=('admission_date', 'size'),has_short_gap=('is_short_gap', 'any')).reset_index())# 9. 筛选:住院≥2次 且 存在短间隔target_patients = target_summary[(target_summary['total_visits'] >= 2) &(target_summary['has_short_gap'] == True)]# 10. 回连原始表,取出这些患者的全部记录result = pd.merge(df,target_patients[['id_card', 'year']],on=['id_card', 'year'],how='inner')# 按身份证和入院日期排序,方便查看result = result.sort_values(['id_card', 'admission_date'])
最终结果(保留了张三和李四的全部住院轨迹):
王五因为只住了一次,被排除在外。
四、两种输出方式的对比
df[df['is_short_gap'] == True] | ||
五、一键导出的完整脚本
import pandas as pddf = pd.read_csv('hospital_data.csv', parse_dates=['入院日期', '出院日期'])df.rename(columns={'身份证号码': 'id_card', '入院日期': 'admission_date', '出院日期': 'discharge_date'}, inplace=True)df['year'] = df['admission_date'].dt.yeardf.sort_values(['id_card', 'admission_date'], inplace=True)df['prev_discharge'] = df.groupby(['id_card', 'year'])['discharge_date'].shift(1)df['gap_days'] = (df['admission_date'] - df['prev_discharge']).dt.daysdf['is_short_gap'] = (df['gap_days'] >= 0) & (df['gap_days'] <= 5) & (df['gap_days'].notna())target_summary = (df.groupby(['id_card', 'year']).agg(total_visits=('admission_date', 'size'), has_short_gap=('is_short_gap', 'any')).reset_index())target_patients = target_summary[(target_summary['total_visits'] >= 2) & (target_summary['has_short_gap'] == True)]result = pd.merge(df, target_patients[['id_card', 'year']], on=['id_card', 'year'], how='inner')result = result.sort_values(['id_card', 'admission_date'])result.to_csv('rehospitalization_check_result.csv', index=False, encoding='utf-8-sig')print(f”共筛选出 {target_patients.shape[0]} 名可疑患者,{result.shape[0]} 条住院记录已导出。”)
六、写在最后
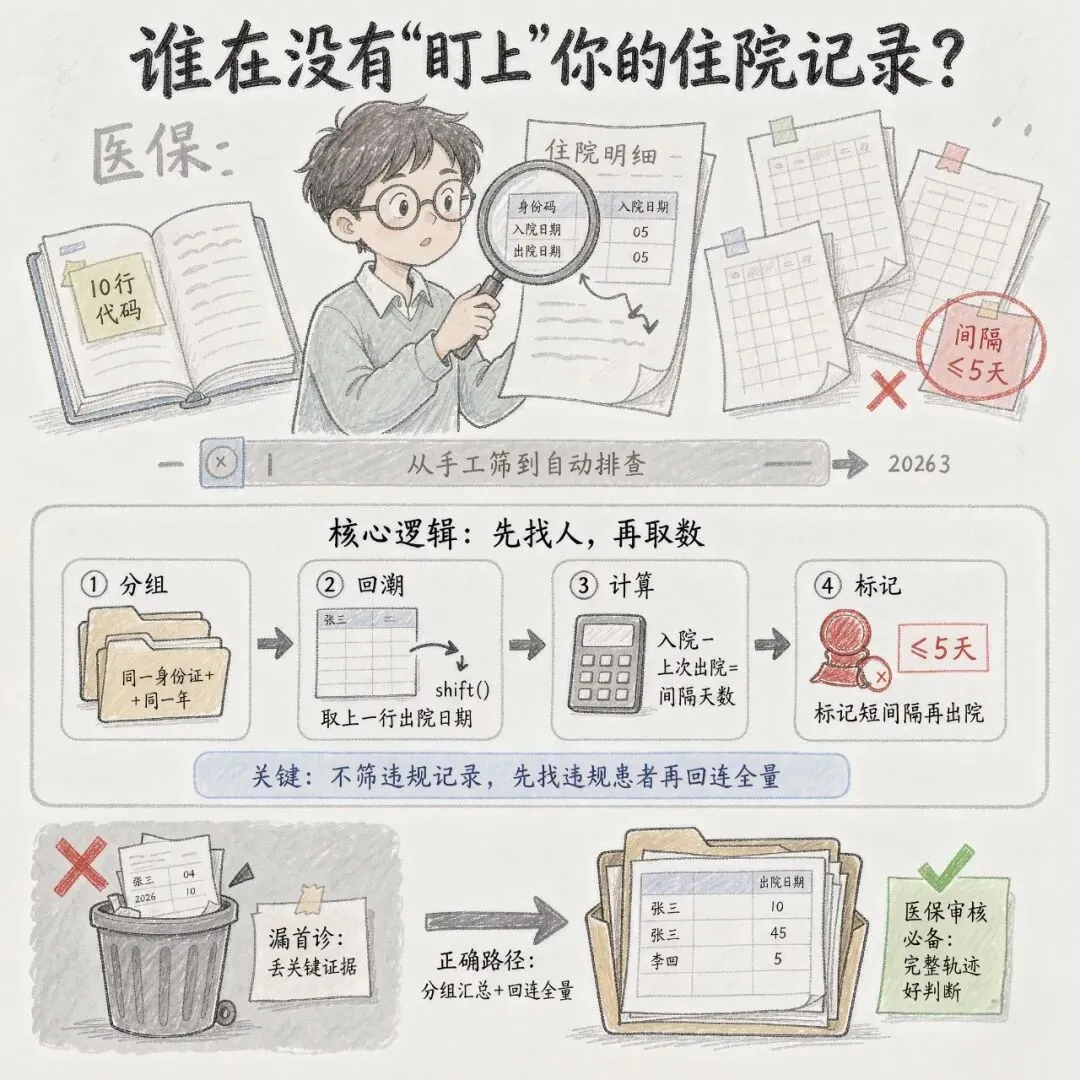
回顾整个方案,核心其实就是两个操作:
shift():取上一行的值,计算间隔天数。 groupby + merge:找出违规患者,回连全量记录。
学会了这两个操作,类似的问题——比如“同一客户连续购物间隔”、“同一设备多次报警间隔”——都可以用同样的思路解决。
技术本身不难,难的是理清业务逻辑,知道“我要什么数据,什么数据是关键的”。
如果你在工作中也遇到类似的“需要逐行比较”的数据处理问题,欢迎在评论区留言,说不定下篇文章就帮你解决。
#Pandas技巧 #医疗大数据 #效率办公 #职场技能
#数据挖掘 #Excel替代方案 #医保审核 #分解住院 #数据分析实战
别只盯着违规的那一行。用groupby找人,用merge取数。看清全貌,才能揪出猫腻。
你的每一次转发,都可能帮到一位正在Excel里挣扎的同事。
推荐阅读
数据分析报告必备:Pandas四种TOP10排名实战写法,轻松搞定前十排名报表 Pandas Apply 终极避坑:类内方法调用×Lambda传参×90%人踩的报错根治 Pandas报错踩坑实录:isin多条件筛选传参错误,90%新手都会写错!
