Python 调一个模型,最后是怎样落到 C++ 和 CUDA 上的?
- 2026-09-29 08:24:10
有一次我带一个转行的工程师看推理代码,他看着 output = model(input_tensor) 这行说:这不就是 Python 在跑吗,能有多快?我让他打开 nvidia-smi,GPU 占用率飙到 95%。他呆住了:Python 怎么能直接操纵 GPU?
其实 Python 从来没有真正"跑"过计算。它只是一个项目经理,负责发号施令,但每一行算子都下沉到了 C++ 和 CUDA 里。今天我把这条链路由表及里拆开。
最近整理了一套比较完整的学习资料(如下图所示),主要包括:
AI专栏:图解 Transformer、图解深度学习、AI infra 工程必知必会等
C++专栏:C++地基、C++入门、C++进阶、内存序与原子操作等
需要的同学可以添加小助手 vx(cppmiao24),免费领取👇👇
第一层:Python 只是胶水
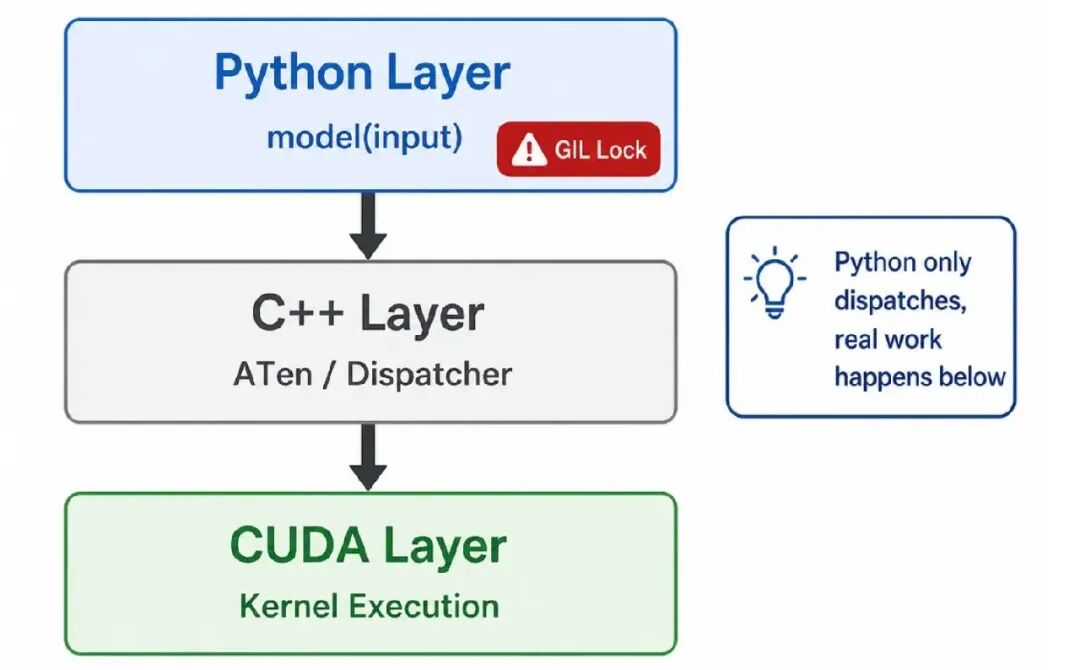
你写的 model(input) 看起来是 Python 在调用,实际上 model 是一个用 C++ 写的 torch.nn.Module 封装。控制权在调用的瞬间就跳到了 PyTorch 的 C++ 前端。
// PyTorch C++ 前端的调用路径Tensor forward(const Tensor& input){return at::native::linear(input, weight, bias);}Python 有 GIL(全局解释器锁),多线程时只能有一个线程执行字节码。如果计算全放在 Python 层,GPU 根本喂不饱。所以 PyTorch 从设计上就把 Python 层做得尽量薄,任务全部下沉到 C++ 层。
第二层:ATen 算子库分发
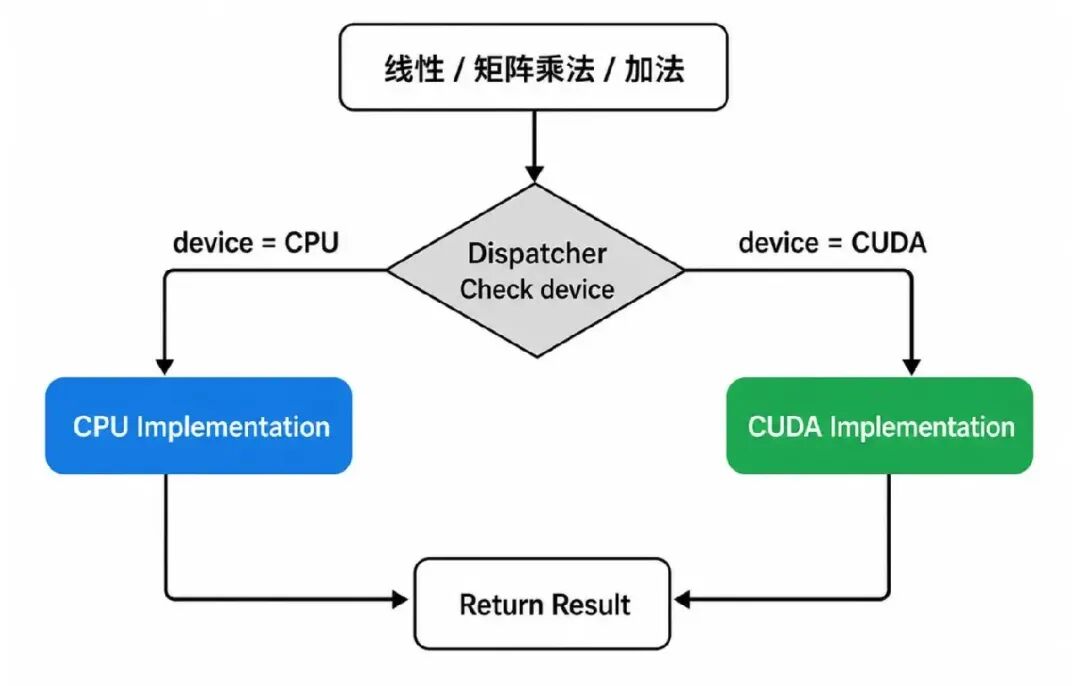
控制权到达 C++ 后,下一站是 ATen(A Tensor Library)。它把高层模型拆解成一个个具体算子,比如 Linear 层被拆成 matmul + add。
ATen 通过 Dispatcher 决定这个算子在哪里执行:CPU 还是 GPU?float32 还是 float16?
// Dispatcher 自动分发示例Tensor linear(const Tensor& input, const Tensor& weight, const Tensor& bias){return at::Dispatcher::singleton().call("aten::linear", input, weight, bias);}你只需写一句 .to("cuda"),Dispatcher 就会根据 tensor 的 device 属性,把后面所有算子自动路由到 CUDA 实现。这就是框架隐藏的精妙之处——它让你用 Python 的语法,享受 C++ 的性能。
第三层:CUDA Kernel 真正干活
当 Dispatcher 路由到 CUDA 设备时,ATen 会调用 cuDNN 或自实现的 CUDA Kernel。这是整条链路的最底层,也是唯一直接操作 GPU 的地方。
以矩阵乘法为例,最终执行的是一个用 CUDA C 写的 __global__ 函数:
__global__ voidmatmul_kernel(float* C, constfloat* A, constfloat* B,int M, int N, int K){int row = blockIdx.y * blockDim.y + threadIdx.y;int col = blockIdx.x * blockDim.x + threadIdx.x;if (row < M && col < N) {float sum = 0.0f;for (int k = 0; k < K; ++k) sum += A[row * K + k] * B[k * N + col]; C[row * N + col] = sum; }}这个 kernel 被编译成 GPU 二进制代码,通过 cudaLaunchKernel 发射到 GPU 上。数千个 CUDA core 并行执行,这就是 nvidia-smi 里 95% 占用率的来源。
为什么不能直接用 Python 跑
有人问:那我直接用 Python 写计算逻辑不行吗?技术上可以,但性能上不行。
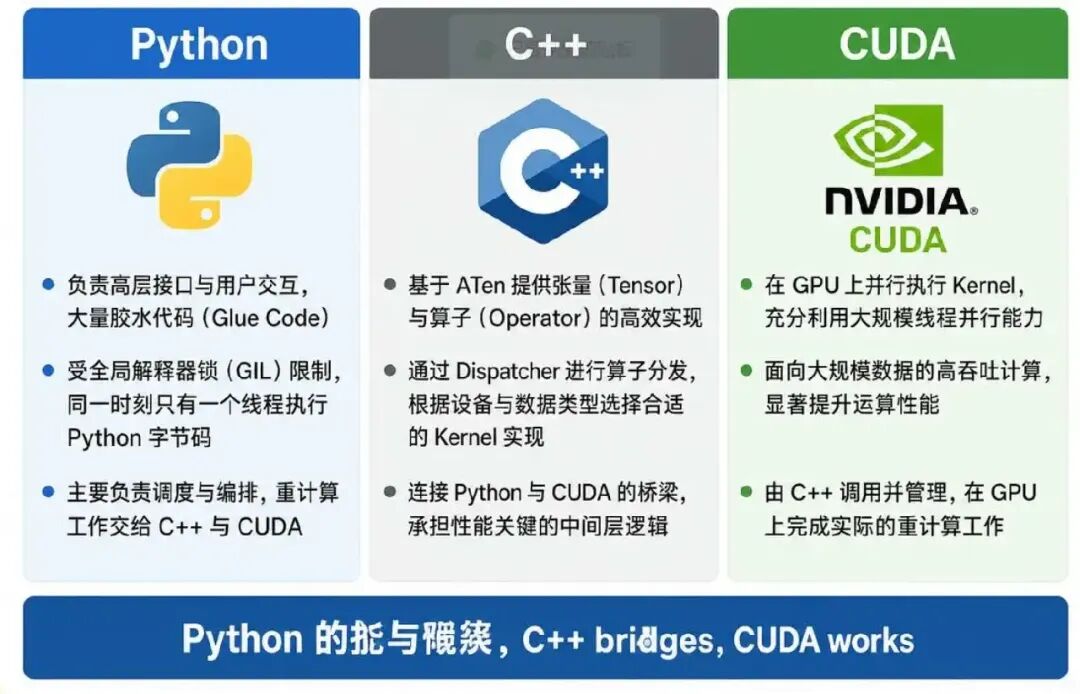
Python 的运行速度比 C++ 慢几十倍,且无法直接访问 GPU。所以深度学习框架的架构高度统一:Python 做胶水,C++ 做桥梁,CUDA 做重活。
面试官可能会这么追问
如果面试官听到这里,通常会补充两个问题:
为什么
torch.tensor从 CPU 转 GPU 要明确写.cuda()或.to('cuda')?因为 Python 和 C++ 的内存空间是分离的,tensor 在 CPU 上时数据存在主机内存,只有显式调用.to("cuda")才会触发cudaMemcpy把数据拷贝到显存。这一步是性能敏感点——频繁地在 CPU 和 GPU 之间搬数据,会成为整个推理 pipeline 的瓶颈。自定义
nn.Module的forward是 Python 还是 C++?是 Python。但forward里每一个算子都是 C++ 实现,Python 只负责组织它们的执行顺序。这就是为什么尽管forward是 Python 代码,运行效率却很高。如果你把自定义逻辑写成了纯 Python 循环(比如手写一个for遍历 tensor 逐元素操作),性能会立刻崩塌,因为每一轮循环都要穿过 Python-C++ 边界。
总结
下次有人问你 model(input) 是不是纯 Python 在跑,你可以这么回答:Python 只是发起人,它把请求交给 C++ 的 ATen 算子库,ATen 通过 Dispatcher 路由到 CUDA Kernel,最后由 GPU 并行执行。整个过程 Python 只做了一件事:打电话。
C++ 校招 / 社招跳槽逆袭!从0到1打造高含金量项目,导师1v1辅导,助你斩获大厂offer!
很多同学准备校招时最焦虑的问题就是:“简历没项目,怎么打动面试官?”
为了解决这个痛点,我们推出了C++项目实战训练营
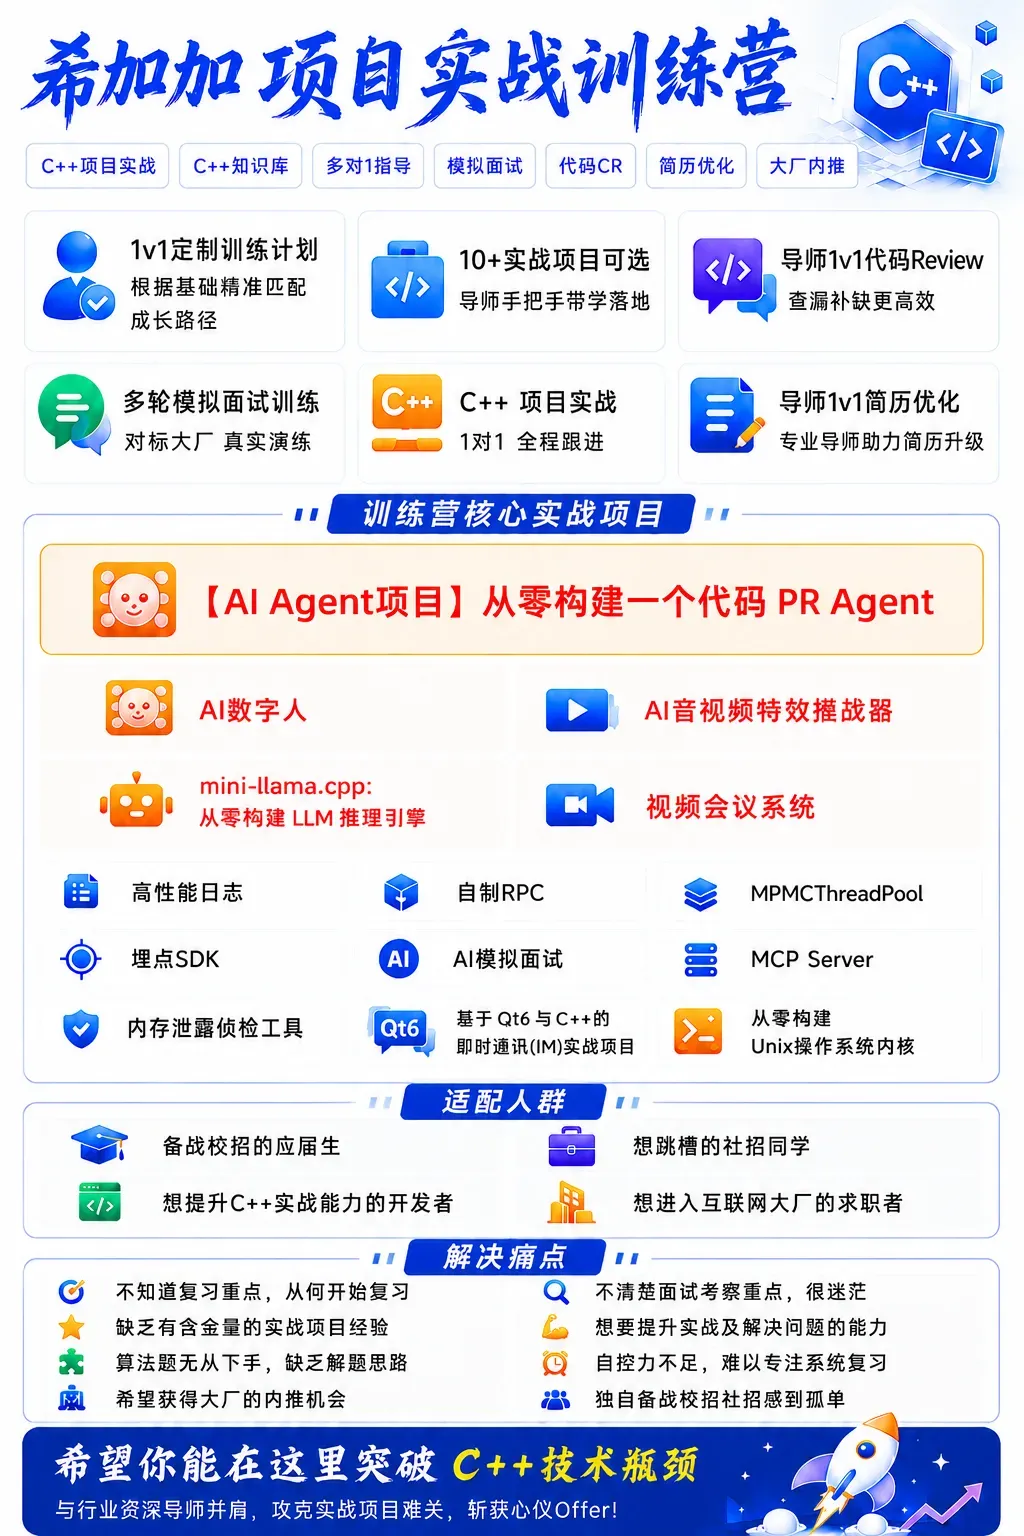
在这里,你可以:
系统学习 C++ 进阶知识 自选项目,从 0 到 1 实战造轮子 导师一对一指导,代码逐行 Review 拿到能写进简历的项目成果,秋招直接加分!
我们不只是教你写代码,更带你走一遍完整的项目流程: 从需求分析、架构设计、编译调试,到版本管理、测试发布,全流程掌握!
项目配套资料齐全,遇到问题还有导师帮你答疑,不怕卡壳!
项目准备好了,你只差一次出发。
相信我,这些项目绝对能够让你进步巨大!下面是其中某三个项目的说明文档

训练营适用人群:
备战春招和秋招的应届生,科班非科班均可, 工作 3 年以内,想跳槽的社招同学 如果你有以下困扰,欢迎联系我们,我们愿意为你提供帮助和支持 不知道该复习哪些内容,如何开始复习。 对面试考察重点不清楚,复习效率低下。 缺乏有含金量的实战项目经验。 想要提升自己的实战能力,提升做项目及解决问题的能力 对算法题无从下手,缺乏解题思路和常见解题模板。 自控力不足,难以专注于系统复习。 希望获得大厂的内推机会。 独自备战校招社招感到孤单,想要找到学习伙伴。
不适合人群:
缺乏耐心和毅力,急于求成的人 对编程逻辑思维基础薄弱,且不愿努力提升的人 只想快速获得成果而不注重基础学习的人
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Python 做完控制台项目不知道学啥?来啃 PyQt 经典神书(附pdf完整版)
- 众闻社|腾讯Hy4大模型落地倒计时 Linux7.3迭代
- 零基础 Python 速成:Agent 开发必备语法,第一次写代码也不怕
- 【技术推荐】Linux文件权限(二):默认权限与特殊权限
- 写Python不注重性能?这几个优化技巧让你的程序飞起来
- “PHP 是不是要凉了?”这个问题被问了十几年.但数据不会说谎——
- 终于有人把自学Python正确顺序说清楚了
- Python进阶教程:14_requests 库 —— 新手完全指南
- Python 办公:拒绝加班!一键透视 100 个 Excel
- Linux 压缩解压谁最强?tar/gzip/zip 命令全方位对比 + 实战教程,看完告别踩坑