Linux Block I/O :架构、核心概念
在 Linux 性能优化中,Block I/O(块设备 I/O)经常是最容易被误判、也是最容易出现“应用明明 CPU 不高,却突然变慢”的部分。
理解 Block I/O,不能只停留在 iostat、fio 等工具层面。真正进行性能分析时,需要建立一条完整的链路:
Application → VFS → Filesystem → Page Cache → Block Layer → I/O Scheduler → Device Driver → Storage Device
其中任何一层都可能成为瓶颈。
1. Linux Block I/O 整体架构
一个典型的文件读取路径可以简化为:
Application
│
read()/pread()
│
▼
VFS
│
▼
Filesystem
ext4/ xfs / ...
│
┌─────┴─────┐
││
▼▼
PageCacheDirect I/O
││
└─────┬─────┘
▼
BlockLayer
│
bio/ request
│
▼
I/OScheduler
│
▼
BlockDriver
│
▼
NVMe/ SSD / HDD
写入路径类似:
Application
│
write()
│
▼
PageCache
│
│dirty pages
▼
Writeback
│
▼
Filesystem
│
▼
Block Layer
│
▼
Storage Device
这里最重要的概念之一是:
write() 返回,并不一定意味着数据已经写入磁盘。
如果使用 Buffered I/O,write() 很可能只是把数据复制到 Page Cache,然后由内核异步 writeback。
2. Block I/O 和 File I/O 的区别
Linux 中经常把 File I/O 和 Block I/O 混在一起。
实际上:
File I/O
↓
VFS
↓
Filesystem
↓
Block I/O
↓
Block Device
例如:
write(fd, buf, 4096)
这是一个 File I/O 操作。
最终可能转换成:
bio
↓
block request
↓
NVMe command
↓
SSD
所以当一个应用执行:
write()
时,真正的数据可能经过很多层之后才到达物理设备。
3. Page Cache
Page Cache 是 Linux Block I/O 性能优化中最重要的概念之一。
对于普通 Buffered I/O:
read()
│
▼
Page Cache
│
├──cache hit → 直接返回
│
└──cache miss
│
▼
BlockI/O
例如:
read(fd, buf, 4096)
如果对应的数据已经在 Page Cache:
Disk
X
│
Page Cache → Application
不需要访问磁盘。
如果 Page Cache miss:
Application
│
▼
Page Cache miss
│
▼
Filesystem
│
▼
Block Layer
│
▼
SSD
因此:
很多所谓的“磁盘性能”问题,实际上可能是 Page Cache 命中率下降导致的。
4. Buffered I/O vs Direct I/O
Buffered I/O
典型路径:
Application
│
▼
Page Cache
│
▼
Block Device
优点:
●Page Cache 可以缓存热点数据
●read-ahead
●write-back
●对小 I/O 比较友好
●应用通常不需要自己管理缓存
缺点:
●可能产生额外的数据复制
●Cache pollution
●writeback 可能造成突发 I/O
●应用无法完全控制数据何时真正落盘
Direct I/O
例如:
O_DIRECT
大致路径:
Application
│
▼
Filesystem
│
▼
Block Layer
│
▼
Device
绕过 Page Cache。
适合:
●数据库
●自己实现缓存的应用
●大型顺序 I/O
●不希望 Page Cache 污染的 workload
但 O_DIRECT 并不是“更快”。
它只是:
把缓存管理责任从 Linux 转移给应用。
如果应用没有良好的 I/O batching、alignment 和 caching 策略,O_DIRECT 反而可能更慢。
5. Read-Ahead
对于顺序读取:
read block 100
read block 101
read block 102
read block 103
Linux 可以预测:
Application
│
▼
read block 100
│
▼
Kernel 预读:
101 102 103 104 ...
这样应用读取后续数据时,数据已经在 Page Cache。
可以查看:
blockdev --getra /dev/nvme0n1
修改:
blockdev --setra 4096 /dev/nvme0n1
但是:
Read-ahead 对随机 I/O 通常没有帮助,甚至可能浪费 I/O bandwidth。
因此需要根据 workload 调整,而不是简单地把 read-ahead 调大。

6. Dirty Page 和 Writeback
写入路径非常重要:
Application
│
▼
Page Cache
│
▼
Dirty Pages
│
▼
Writeback
│
▼
Block Layer
│
▼
SSD
当应用执行:
write(fd, data, size);
内核可能只是:
copy data
↓
Page Cache
↓
mark page dirty
之后由后台线程负责写回。
因此系统可能出现:
Application write()
↓
很快
过了一段时间
Writeback
↓
大量 I/O
↓
Disk latency suddenly increases
这就是典型的 writeback burst。
常见参数:
sysctl vm.dirty_ratio
sysctl vm.dirty_background_ratio
sysctl vm.dirty_bytes
sysctl vm.dirty_background_bytes
现代 Linux 上通常更推荐使用 *_bytes 而不是简单依赖 ratio,因为 ratio 会随着系统内存大小变化。

7. fsync() 为什么可能很慢?
考虑:
write(fd, data, size);
fsync(fd);
write() 可能只是:
Application
↓
Page Cache
而:
fsync()
要求内核推动相关数据以及必要的 metadata 持久化,并等待存储栈满足相应的 durability 条件。
于是:
write()
↓
fast
fsync()
↓
wait
↓
filesystem
↓
block layer
↓
SSD
所以数据库中经常看到:
CPU 很低
Disk utilization 不一定 100%
但是 fsync latency 很高
这并不矛盾。

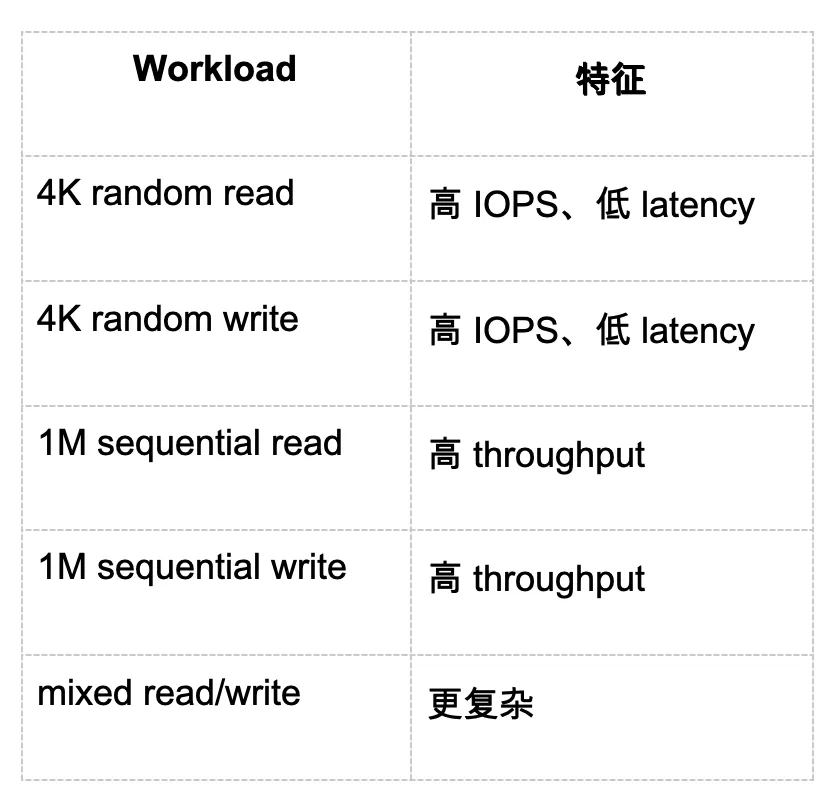
8. I/O Size
Block I/O 性能高度依赖 I/O size。
例如:
4 KB random read
和:
1 MB sequential read
虽然都是“读数据”,但性能特征完全不同。
典型 workload:
因此性能测试不能只问:
Disk 有多少 MB/s?
还需要问:
I/O size、access pattern、queue depth、read/write ratio 是什么?
9. IOPS、Bandwidth、Latency
三个核心指标:
IOPS
每秒完成多少 I/O:
IOPS = I/O operations per second
Bandwidth / Throughput
每秒传输多少数据:
Bandwidth = IOPS × I/O size
例如:
100,000 IOPS
×
4 KB
≈
400 MB/s
因此:
高 IOPS 不一定意味着高 bandwidth。
Latency
一次 I/O 花费的时间。
例如:
I/O latency = 1 ms
如果 workload 是同步 I/O:
Application
│
├──I/O
│wait1ms
│
├──I/O
│wait1ms
latency 会直接限制吞吐。

10. Queue Depth
现代 SSD/NVMe 可以同时处理大量 outstanding I/O。
例如:
Queue Depth = 1
Application
│
├──I/O
│wait
└──next I/O
而:
Queue Depth = 32
Application
├──I/O
├──I/O
设备可以并行处理。
因此通常:
QD ↑
↓
IOPS ↑
↓
Latency ↑
并不是越高越好。
当达到设备饱和点以后:
QD ↑
IOPS → plateau
Latency ↑↑
这就是典型的 saturation。
11. I/O Scheduler
Linux Block Layer 下面还有 I/O scheduler。
常见 scheduler:
none
mq-deadline
bfq
可以查看:
cat /sys/block/nvme0n1/queue/scheduler
例如:
[none] mq-deadline
意味着当前使用:
none
对于现代 NVMe SSD:
none
通常很常见,因为设备本身已经具有很强的并行处理和调度能力。
对于不同 workload,scheduler 的选择可能影响:
●latency
●throughput
●fairness
●tail latency

12. Block Layer:bio 和 request
Linux Block Layer 是理解性能问题的关键。
Filesystem 不会直接操作 SSD。
它通常构造:
bio
然后提交到 Block Layer。
可以简单理解:
Filesystem
│
▼
bio
│
▼
Block Layer
│
▼
request
│
▼
Driver
多个相邻或兼容的 I/O 可能被:
●merge
●batch
●queue
从而减少设备交互次数。
可以观察:
cat /proc/diskstats
以及:
iostat -x
13. I/O Merge
例如应用产生:
4K read @ block 100
4K read @ block 101
4K read @ block 102
4K read @ block 103
内核可能将其合并成:
16K read @ block 100
这样可以降低:
I/O operation count
并提高效率。
iostat 中常见:
rrqm/s
wrqm/s
代表请求合并相关统计。
不过现代 NVMe 的 workload 与传统 HDD 已经不同,因此不能看到 merge rate 高低就简单判断“好”或“坏”。

14. HDD vs SSD vs NVMe
不同设备的优化目标完全不同。
HDD
核心问题:
seek
rotation
因此:
random I/O
↓
非常昂贵
优化重点通常是:
●sequential access
●request merging
●reduce random I/O
●read-ahead
●I/O scheduling

SATA SSD
没有机械 seek,但仍受:
●SATA bandwidth
●device queue
●flash characteristics
影响。

NVMe SSD
NVMe 通过 PCIe 连接,并支持大量 queue 和高并行度。
架构大致:
CPU
│
PCIe
│
NVMe Controller
│
Flash
因此常见优化重点变成:
●I/O parallelism
●queue depth
●CPU overhead
●NUMA locality
●interrupt handling
●tail latency

15. NUMA 对 Block I/O 的影响
在大型服务器中:
CPU socket 0
│
├──Memory 0
└──PCIe/NVMe 0
CPU socket 1
│
├──Memory 1
└──PCIe/NVMe 1
如果:
Application CPU
↓
NUMA node 0
NVMe
↓
NUMA node 1
可能产生:
remote memory access
+
cross-socket traffic
导致 latency 增加。
可以检查:
numactl --hardware
以及:
lspci -tv
在极端低延迟 workload 中,需要关注:
CPU、memory、PCIe device 是否位于合理的 NUMA topology 上。

16. 常见 I/O 性能指标
最常用:
iostat -xz 1
重点关注:
r/s / w/s
每秒读写请求数。
rkB/s / wkB/s
读写 throughput。
await
I/O 请求平均等待时间。
aqu-sz
平均 queue size。
%util
设备忙碌程度。
不过需要特别注意:
%util = 100% 不一定代表现代 NVMe 真正“性能已经用尽”。
因为一个高并发 NVMe 设备可以在 %util 很高时仍然继续增加 IOPS。
所以现代 SSD 上不要只看 %util。

17. 云环境中的 Block I/O
在 AWS 等云环境中:
Application
↓
Linux
↓
Block Layer
↓
Virtual Block Device
↓
Network / Hypervisor
↓
EBS Storage
因此:
虚拟磁盘的 latency 不一定只由 Linux 和磁盘决定。
可能受:
●EBS volume limits
●instance EBS bandwidth
●IOPS limit
●throughput limit
●burst/baseline behavior
●network contention
影响。
所以排查云上 Block I/O 时需要同时看:
Linux
+
Instance
+
Storage Volume
+
Cloud Provider Limits
storage scaling
而不是:
继续调 Linux kernel 参数
反过来,如果:
Device IOPS 很低
Device latency 很低
Application latency 很高
那么问题可能根本不在 storage,而可能是:
Application concurrency
filesystem
locking
Page Cache
CPU scheduling
18. 总结:需要建立的完整心智模型
Linux Block I/O 最重要的是理解下面这条链:
Application
│
│read/write
▼
VFS
│
▼
Filesystem
│
├──────────────┐
▼▼
Page CacheDirect I/O
│
▼
Writeback / Read-ahead
│
▼
Block Layer
│
▼
bio
│
▼
request / queue
│
▼
I/O Scheduler
│
▼
Block Driver
│
▼
NVMe / SSD / HDD
│
▼
Physical / Virtual Storage
而性能分析最核心的几个维度是:
I/O pattern
↓
I/O size
↓
IOPS
↓
Bandwidth
↓
Latency
↓
Queue Depth
↓
Concurrency
↓
Device saturation
如果把这些概念真正串起来,看到 iostat -xz、fio、vmstat 或生产环境中的 I/O latency 问题时,就不再只是“看指标”,而是能够从 Application → Kernel → Block Layer → Device 一层层定位瓶颈。
 10个月宝宝每天需要喝多少奶粉?