AI不是"都用Python":Python调度、C++计算、CMake施工
本文速览
•vLLM官方文档自称Python library,同一份文档又写明它包含预编译的C++和CUDA二进制;仓库里则是1584行的CMakeLists.txt加csrc/*.cu——这不是矛盾,是分层。•Python负责应用/控制层,C++/CUDA负责计算层,CMake只是把C++/CUDA组织起来编译的构建系统生成器,相当于Python世界的pyproject.toml加setuptools。•本机实测三个基准:逐元素运算Python比C++慢约346倍;从Python调C++空函数每次约23纳秒,比调Python函数还贵,所以热循环必须批量下沉;性能来自cuBLAS这类优化库而非语言本身。•vLLM满屏CMake是因为它是推理引擎:decode阶段内存带宽受限,热路径全在系统软件层——PagedAttention、KV cache、CUDA kernel,这些都不是Python能做的。如果你在AI应用层写了大半年RAG,某天第一次打开vLLM的源码,大概率会怀疑自己下错了仓库。
vllm/ 目录下面是正常的Python,csrc/ 目录里躺着几百个 .cpp 和 .cu,根目录一个1584行的 CMakeLists.txt,旁边还有整个 cmake/ 目录。你搜索"这个项目用什么语言写的",官方文档第一句写的是:vLLM is a Python library。再往下翻半页,同一份文档又写:vLLM contains pre-compiled C++ and CUDA binaries。
官方口径和仓库长相,看起来是矛盾的。其实不矛盾,这是两层东西。
本文把这件事拆开讲:Python在AI里到底负责什么,C++/CUDA负责什么,CMake又是在哪一层干活。拆完我在本机复刻了一个微型版vLLM构建——一个用CMake编译、被Python import的C++扩展——跑了三个基准实验,把"分层"这个词变成了可以验证的数字。
先把三个概念钉死
Python和CMake根本不是同一个维度的东西,放在一起比较本身就说明混淆了层。
Python是一门语言,而且是解释执行的。CPython把源码编译成字节码,然后在一个循环里逐条执行,每条字节码都要经过分派、类型检查、引用计数。它慢,慢得有原因。
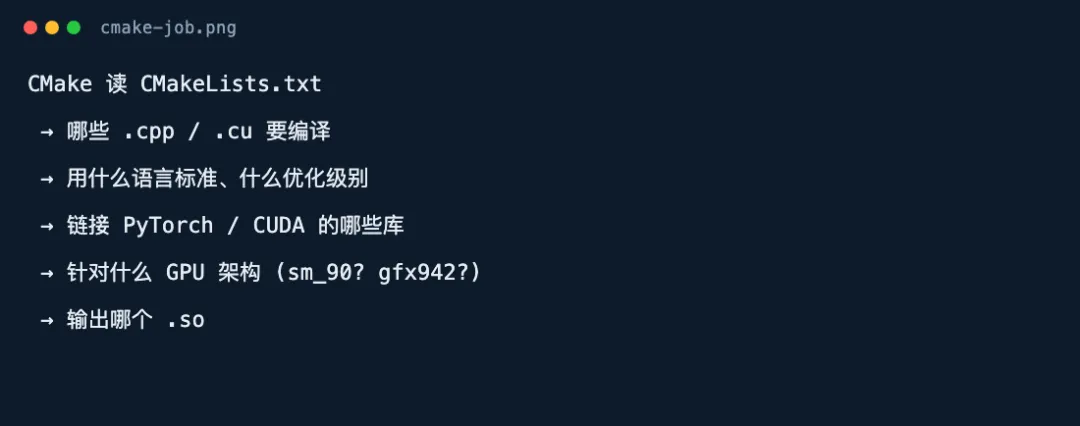
CMake不是语言。它是构建系统生成器:读 CMakeLists.txt 里的声明,生成Makefile或Ninja构建脚本,再由make或ninja去调用真正的编译器(gcc、clang、nvcc)干活。它回答的是工程问题:哪些源文件要编译、用什么语言标准、链接哪些库、针对什么硬件架构、最后输出哪个 .so。
vLLM是一个推理引擎。它官方自述是Python library,但它的性能关键路径——attention kernel、KV cache管理、sampler、量化算子——全部是C++和CUDA。Python在这里是控制层,不是计算层。
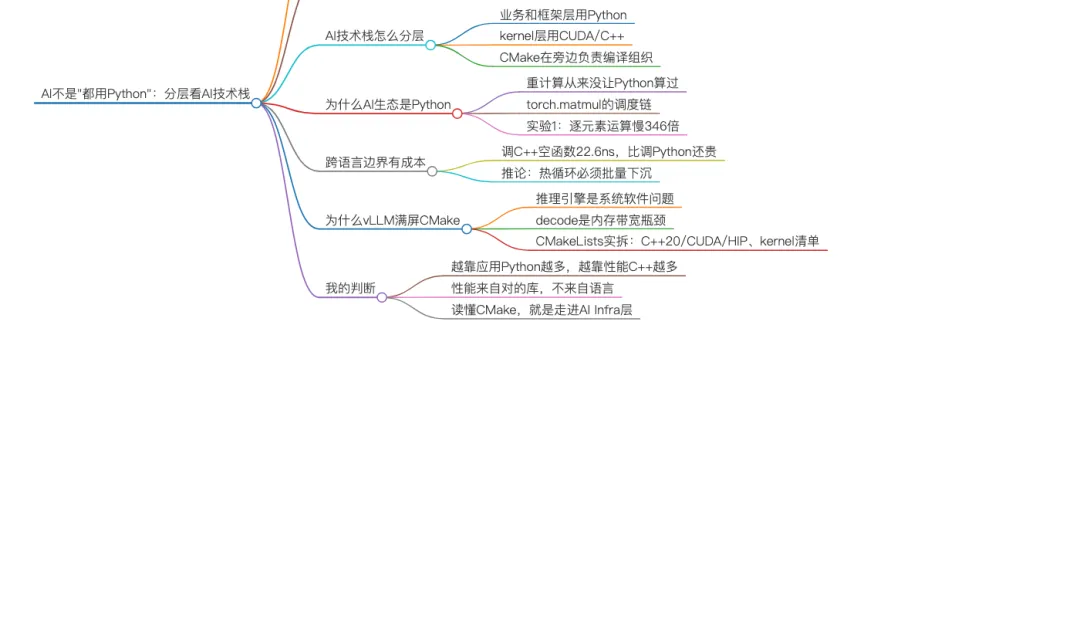
所以"AI都用Python,为什么vLLM用CMake"这个问题,准确的说法是:AI应用层大量用Python,vLLM的高性能底层是C++/CUDA,而CMake只是负责把这些C++/CUDA代码组织起来编译的施工系统。
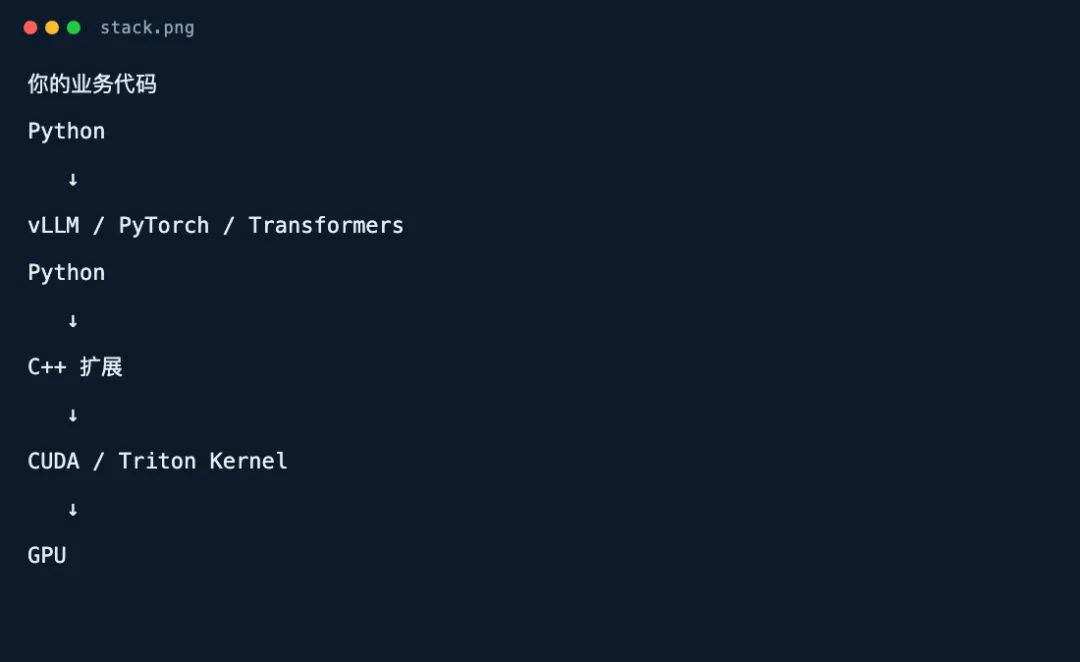
典型AI技术栈,是这么分的
CMake不在这条纵线上。它在旁边干这件事:
它不是运行模型时写业务逻辑的语言,它是C++/CUDA世界的"施工组织"。
为什么AI生态围着Python转:因为没人让Python算
Python能当上AI的默认语言,核心原因不是Python快,而是真正重的计算从来没让Python干过。
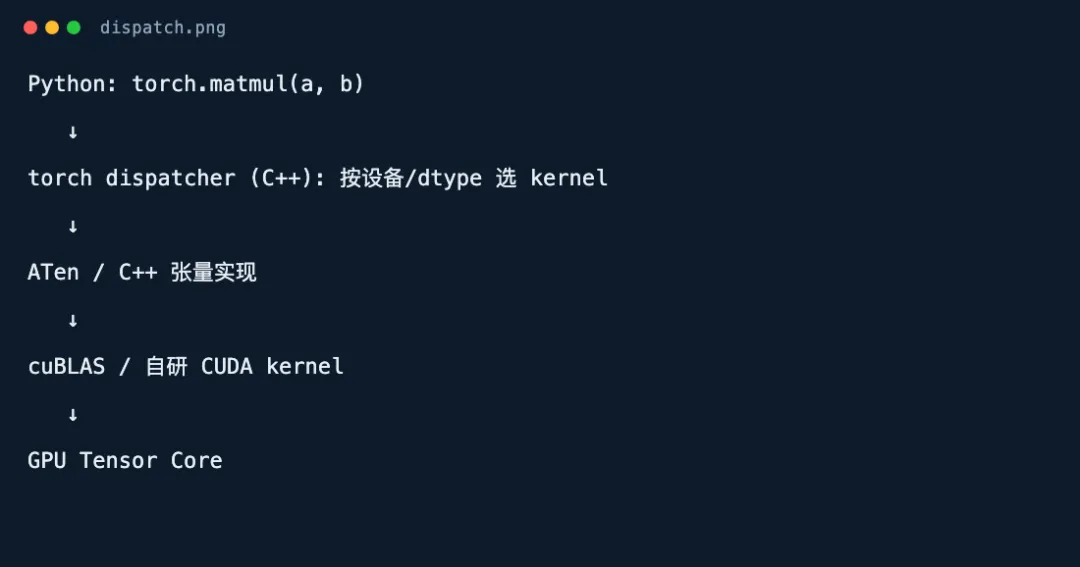
这个模式从NumPy时代就定下来了。NumPy本身是C写的,Python只传一个"数据描述符"(指针、形状、步长)给C层,循环在C层跑完,结果再传回来。PyTorch把这个模式发扬光大:你写 y = torch.matmul(a, b),看起来是一句Python,实际上走的是这条链:
Python承担的是模型结构定义、数据处理、调度、实验、API、Agent/RAG、推理流程编排;真正吃算力的矩阵乘法、attention、卷积,在C++/CUDA/cuBLAS/cuDNN里完成。
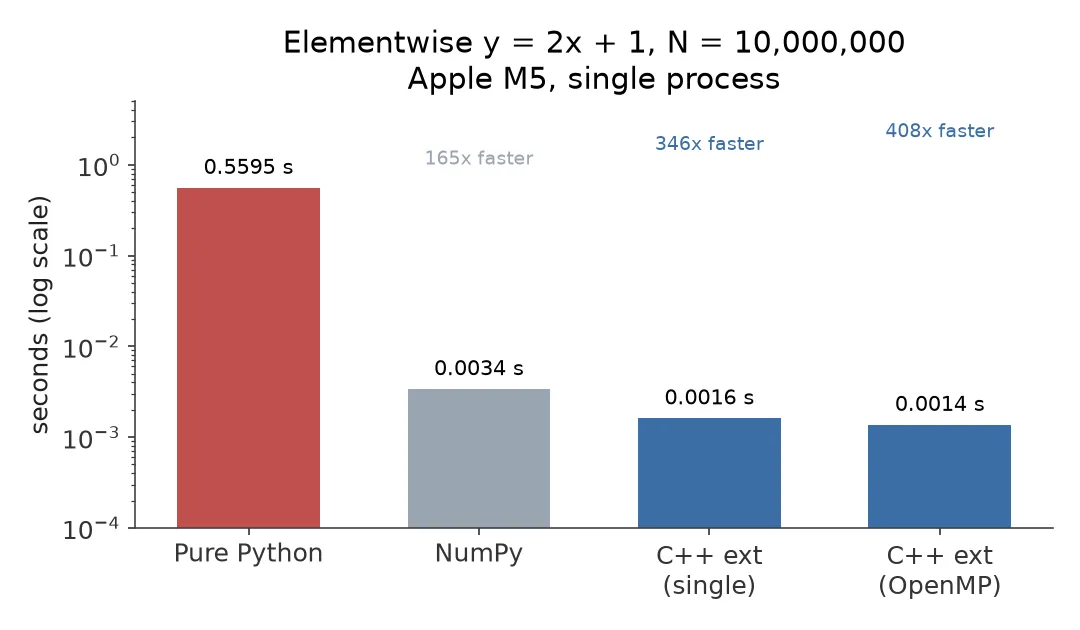
我在本机验证了这条链的两端。实验环境是Apple M5、10核、Python 3.14,用一个CMake编译的pybind11扩展做对照。第一个实验:10,000,000个元素的逐元素运算 y = 2x + 1:
纯Python列表推导0.559秒,numpy 0.0034秒(快165倍),C++扩展单线程0.0016秒(快346倍),C++扩展开OpenMP四线程0.0014秒(快408倍)。
这300多倍的差距就是解释器的代价:CPython逐条执行字节码,每条都要查分派表、做类型检查、维护引用计数。Python 3.11之后的特化解释器已经把这个差距压缩了不少,但底层机制没变,它还是逐条解释字节码。
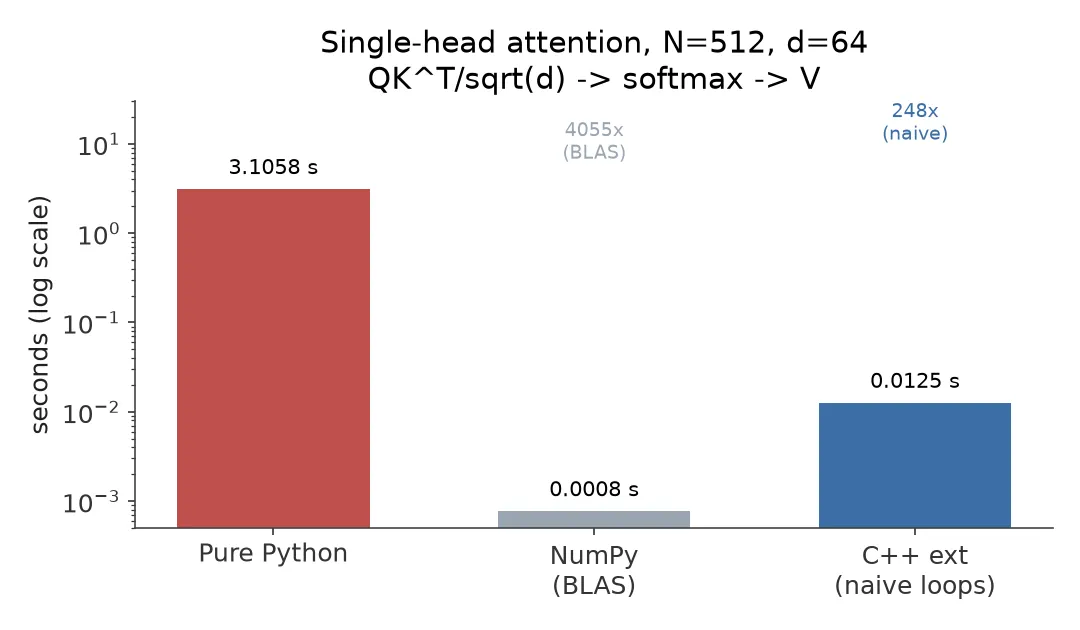
不过这里有个更值得注意的细节,来自我的第三个实验。单头attention,序列长度512、head维度64,就是 softmax(QK^T/√d)V 这条完整链路:
纯Python三重循环3.11秒。numpy 0.0008秒,快4055倍。我手写的朴素C++循环0.0125秒,快248倍。
注意最后两行:numpy比我的朴素C++还快15倍。因为numpy内部调的是系统的BLAS库(macOS上是Accelerate),那是人家优化了几十年的线性代数实现,cache分块、SIMD向量化、多线程调度全在里面。而我的C++循环就是三明治循环,什么都没优化。
这个结果比"C++快400倍"更值得记住:性能不来自"用了C++"这个事实,来自"用了对的C/C++库"。GPU上同理——cuBLAS、cuDNN、cutlass,以及vLLM自己手写的kernel,才是性能本体。Python的贡献是调度它们。
反直觉的一层:跨语言边界本身有成本
那是不是"把每个小操作都下沉到C++"就行了?我的第二个实验专门测了这个。
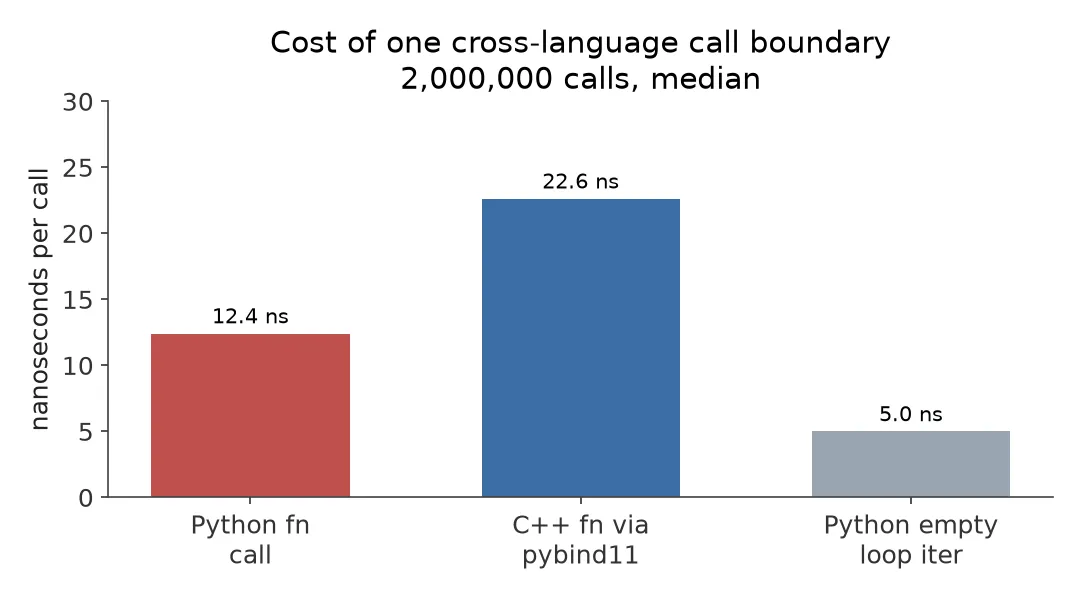
空函数调用200万次,每次开销取中位数:
调一个Python空函数:12.4纳秒。调一个C++空函数(经pybind11):22.6纳秒。Python的空循环迭代:5.0纳秒。
从Python调C++函数,比调Python函数还贵。 因为pybind11每次调用要做参数解析、异常翻译、GIL处理,这一层边界开销是固定的。
这个反直觉的结果解释了PyTorch和NumPy为什么把API设计成张量级而不是标量级:你不能对每个元素调一次C++,那会慢到怀疑人生。你必须把整个数组一次性交给C++,循环在C层内部跑完。这就是"批量下沉"——减少跨语言边界穿越的次数,把热循环整体留在native层。
torch.matmul(a, b) 之所以快,不是因为它调了C++,而是因为它把整块矩阵乘丢给了cuBLAS,中间只穿过一次边界。
为什么vLLM满屏CMake:它根本不是普通AI应用
到这里就能回答标题的问题了。
如果你写一个RAG应用——LangChain、FastAPI、向量库、调LLM API——热路径在业务逻辑上,Python从头到尾够用。但vLLM是一个推理引擎,它的KPI是吞吐量、显存占用、kernel延迟、GPU通信。这些东西已经不在"AI应用"层,在系统软件/HPC/GPU Runtime层。
LLM推理有一个绕不开的物理约束:decode阶段是内存带宽瓶颈,不是算力瓶颈。生成一个token,理论上要把模型所有参数都读一遍——70B模型FP16权重约140GB,H100 SXM的内存带宽3.35TB/s,光搬权重就要约42毫秒;而这一个token的计算量在FP16稠密算力下只要约0.14毫秒。这个单token视角下,算力利用率不到1%。
所以推理引擎的优化方向不是"算得更快",是"少搬数据、搬得更高效":融合kernel(一次搬入、多次计算)、KV cache分页(PagedAttention,vLLM的成名作)、continuous batching(把不同请求的token塞进同一批)、CUDA Graph(消除kernel启动开销)、量化(把140GB的权重变成70GB甚至更小)。
这些东西没有一样是Python能做的,全是C++/CUDA的活。Python在vLLM里负责的是:调度批次、维护KV cache的元数据、把参数传给kernel、编排整个推理流程。
翻开vLLM的CMakeLists.txt,看到的是这个
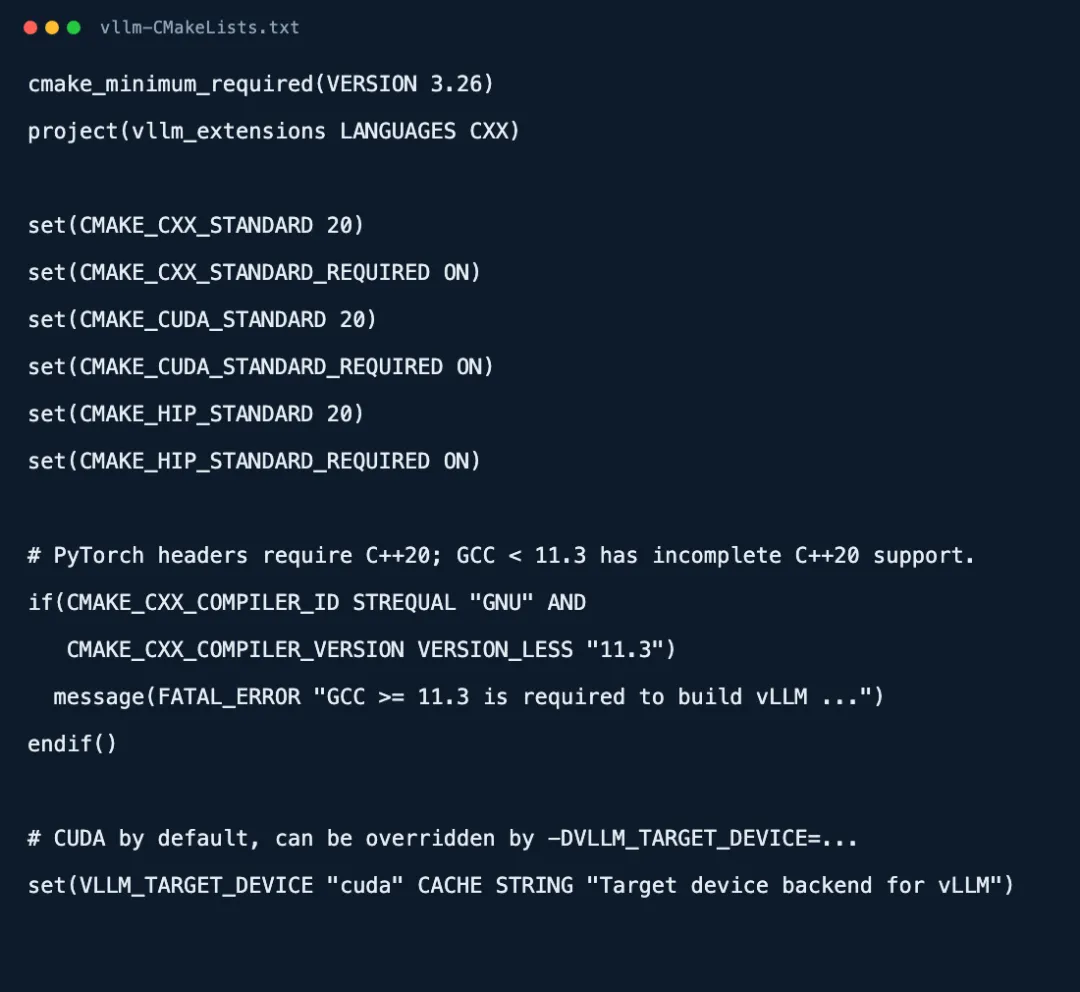
光说"满屏CMake"没意思,直接看原文。vLLM主仓库根目录的 CMakeLists.txt,第一行:
三件事:项目只声明了CXX语言;C++、CUDA、HIP三个标准全钉在20;编译器不够新直接报错——文件里有一条GCC小于11.3就FATAL_ERROR的检查,原因是PyTorch的C++20头文件需要完整支持,注释原话是GCC < 11.3 has incomplete C++20 support。
往下翻,这个文件里还能看到这些:
•VLLM_TARGET_DEVICE,默认cuda,可以切rocm、cpu——同一套源码,三套后端,CMake负责按目标选语言和工具链。•一长串AMD的 HIP_SUPPORTED_ARCHS:gfx906、gfx90a、gfx942、gfx1250……GPU架构是编译期参数,不是运行时参数,所以必须由构建系统处理。•kernel源文件清单,随便列几条:cache_kernels.cu、sampler.cu、layernorm_kernels.cu、attention/merge_attn_states.cu、quantization/w8a8/int8/scaled_quant.cu、gptq/q_gemm.cu。甚至有一个叫 fused_kimi_k3_mla_key_concat_kv_cache_kernel.cu 的文件——Kimi K3的MLA kernel直接躺在vLLM的csrc里。•外部项目列表:deepgemm、fmha_sm100、flashmla、flashkda、qutlass、tml_fa4、vllm_flash_attn。vLLM不自己造每个轮子,用CMake把别人的kernel项目拉进来一起编译。还有一处容易被忽略但很关键的设计:CUDA后端编译的扩展模块叫 _C_stable_libtorch,用 STABLE_TORCH_LIBRARY 注册算子,编译参数里有 USE_SABI 3 WITH_SOABI——稳定ABI,一个 .so 能跨Python小版本复用,不用每次换版本都重编。而ROCm后端还在用老的 _C 目标,文件里的注释写得很直白:Legacy _C extension (ROCm only — CUDA ops migrated to _C_stable_libtorch)。
Python侧对应物在 vllm/_custom_ops.py:current_platform.import_kernels() 把编译好的扩展加载进来,然后代码里全是 torch.ops._C.paged_attention(...)、torch.ops._C.merge_attn_states(...) 这种调用。Python只负责调,kernel在C++/CUDA里。
我在本机复刻了一个微型版vLLM构建
说这么多,不如亲手跑一遍。我在本机复刻了上面这套结构的最小版本:一个CMakeLists.txt、一个pybind11 C++源文件、一个Python基准脚本。流程和vLLM完全同构——CMake配置、CMake构建、产出.so、Python import。
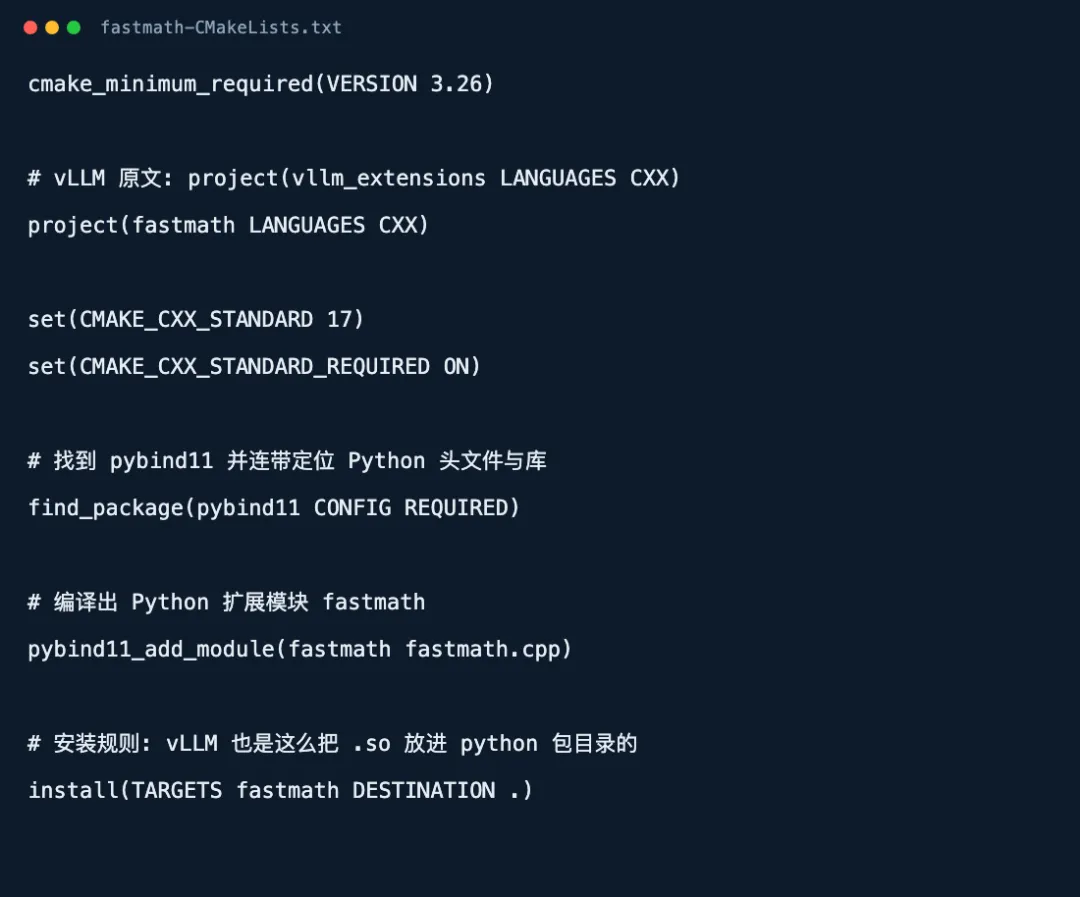
我的CMakeLists.txt,结构照抄vLLM的骨架:
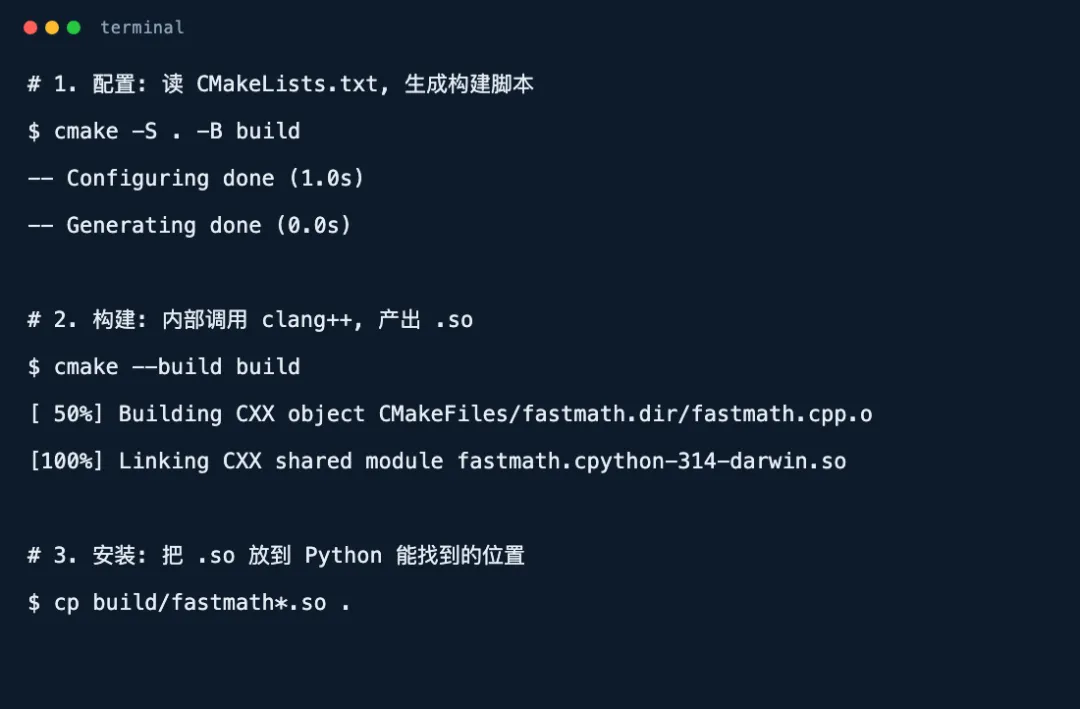
然后三条命令,走完vLLM构建的完整链路:
构建日志里能看到CMake实际拼出来的编译命令,flags是 -std=gnu++17 -arch arm64 -fPIC -fvisibility=hidden -O3 -ffast-math -fopenmp -flto。用 nm 看生成的 .so,导出的符号里有 _PyInit_fastmath——这就是Python import时查找的入口函数。
然后Python里一行 import fastmath,就能调用C++函数了。和vLLM里 torch.ops._C.paged_attention(...) 是同一件事:Python是调度方,C++是执行方,CMake是施工方。
三个基准实验的数字前面已经摆过了,这里汇总一下,全部本机实测、固定随机种子:
正确性也验了:C++手写attention和numpy的结果,最大绝对误差1.2e-15,同一个结果,三种实现。
先说边界:这是个CPU上的玩具扩展,没有GPU kernel,没有Tensor Core,没有warp调度。但三个机制是通用的——解释器开销真实存在、跨语言边界有固定成本、性能来自优化的库而不是语言本身。GPU上的kernel工程还有更多细节,不在本机覆盖范围内。
完整的代码、数据和复现步骤我打包成了一个小目录(CMakeLists.txt、fastmath.cpp、bench.py、README,含全部原始结果),需要的话公众号留言,我发你。
所以"AI都用Python"这句话,准确说是"分层"
把AI技术栈按层拆开,每层的语言是固定的:
对照着看几个代表项目就清楚了:Transformers是Python,PyTorch是Python+C++,vLLM是Python+C+++CUDA,DeepSpeed是Python+C+++CUDA,FlashAttention是Python+CUDA,llama.cpp是纯C/C++,CUDA本身是C++方言。
规律很直白:越接近"模型怎么用",Python越多;越接近"模型怎么跑得快",C++/CUDA越多。
CMake在C++世界的角色,对应到Python世界是 pyproject.toml + setuptools,对应到JS世界是 package.json + Vite配置。它存在感强,纯粹是因为C++/CUDA项目的编译复杂度高——架构矩阵、库依赖、ABI兼容、编译加速,这些在Python项目里都被解释器或pip隐藏掉了,在C++项目里必须显式交代。
理解vLLM这套源码,一个好用的心智模型是:Python是vLLM的大脑/控制层,C++/CUDA是肌肉,CMake是负责把肌肉装起来的施工系统。
我的判断
这篇文章开头那个问题——"AI不都用Python吗,为什么vLLM是CMake"——答案不是"vLLM不用Python",而是提问的人还没分层。做AI产品、RAG、Agent,大概率一辈子不需要碰C++;但一旦开始研究vLLM、SGLang、FlashAttention、推理优化,满眼CUDA、C++、CMake、NCCL是必然的——你已经从AI应用层走进AI Infra层了,这不是换语言,是换了一层。
有几个判断想留给读者:
一是"性能来自对的库,不来自语言"。我的实验里朴素C++输给numpy 15倍,这提醒我们别把"用了C++"当成性能承诺。真正值钱的是cuBLAS/cuDNN/cutlass这种被反复打磨的库,以及vLLM那种针对具体访存模式手写的kernel。
二是跨语言边界不是免费的。Python和C++之间每穿越一次,都有几十纳秒的固定成本。所以好的AI框架设计成张量级API、批量下沉,而不是逐元素跨界。这一点在优化推理代码时经常被忽略。
三是CMake本身不复杂,复杂的是它管理的东西。读懂 project(vllm_extensions LANGUAGES CXX) 这行,你就理解了vLLM构建的起点;剩下1583行,全是在回答"哪些文件、什么标准、什么架构、链接什么、输出什么"这些工程问题。哪天你需要从源码编译vLLM、写自己的CUDA kernel、或者排查"为什么我的vLLM装不上",你就知道CMake这套施工系统是绕不开的,也是值得花半天搞懂的。
最后简单说
AI领域不是"都用Python",是分层:应用层Python、计算层C++/CUDA、构建层CMake。我的实验给出了三个数字:解释器让Python循环慢C++约346倍;跨语言调用一次约23纳秒,所以热循环必须批量下沉;性能来自cuBLAS这类优化库而非语言本身。vLLM满屏CMake,是因为它是推理引擎,热路径在系统软件层,不在Python业务逻辑层。
✦✦✦✦✦这里记录AI产品从想法到落地的过程:产品结构、Agent/RAG/评估、AI医疗行业、AI工作流、内容自动化、AI审美,以及真实项目里的判断和取舍。
公众号、抖音、小红书同名:阿多小筑。关注这里,一起把AI能力变成可复用的产品和流程。
AI产品方法论Agent/RAG/评估AI医疗行业AI工作流AI审美真实落地记录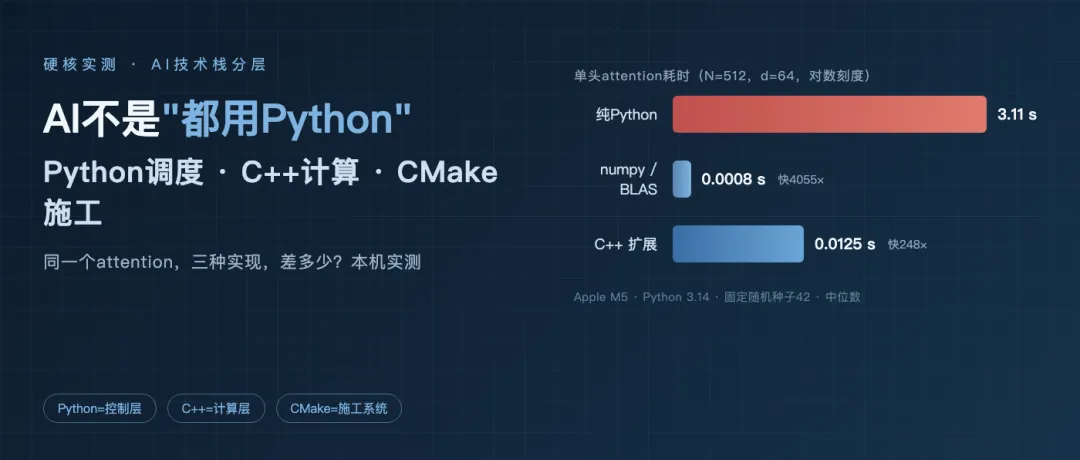
 10个月宝宝每天需要喝多少奶粉?