这2天有同学问我:我主要靠 MiniQMT 下载数据, miniqmt客户端一关、我的数据咋办?
这是个非常实在的问题。MiniQMT 的行情下载依赖客户端进程活着:之前可以通过xtquant 的 download_history_data 下载。
最容易想到的办法,用大 QMT(完整版客户端)的"数据管理"功能,把行情批量导出成 CSV 存起来。 或者用qmt代码实现
这里我换个思路:QMT 下载的数据,本来就躺在我电脑硬盘上。它存在哪、长什么样,搞清楚这两个问题,不就直接读了吗?
一、datadir 目录探秘
QMT 客户端把下载的行情放在安装目录(MiniQMT 是 userdata_mini/datadir,大 QMT 类似)下,结构大概是这样:
datadir/
├── SH/ ← 沪市
│ ├── 60/ ← 周期目录:60 秒 = 1 分钟 K 线
│ │ └── 000001.DAT
│ ├── 86400/ ← 86400 秒 = 日 K 线
│ │ └── 600519.DAT
│ └── 0/ ← tick 分笔数据,按 代码/日期 分目录
│ └── 000001/20250613.dat
└── SZ/ ← 深市,结构相同
规律很清晰:一级是市场(SH/SZ/BJ),二级是周期(秒数),三级是代码.DAT。tick 数据特殊一些,是 市场/0/代码/日期.dat 的形式,一天一个文件。
二、二进制格式拆解
拿 SH/60/000001.DAT(上证指数分钟线)开刀。先看文件大小:15432 字节。再看内容,用十六进制编辑器打开,很快能发现规律——每 64 字节出现一次形似时间戳的数字,且恰好相差 60。这不是巧合,这就是记录边界:每根 K 线一条记录,固定 64 字节,没有文件头,整个文件就是记录的顺序堆放。
三、完整 Python 源码
这里写一个解析分钟级别的解析代码,仅供参考
# -*- coding: utf-8 -*-"""解析 MiniQMT 本地 1 分钟 K 线 .dat 文件文件格式(逆向结论): - 无文件头,整个文件由若干条固定 64 字节的记录组成(小端) - 偏移 0-7 : 未解析(跳过) - 偏移 8-11 : u32 Unix 秒时间戳(北京时间) - 偏移 12-15 : u32 open (÷1000) - 偏移 16-19 : u32 high (÷1000) - 偏移 20-23 : u32 low (÷1000) - 偏移 24-27 : u32 close (÷1000) - 偏移 28-31 : 未解析(跳过) - 偏移 32-35 : u32 volume 成交量 - 偏移 36-39 : 未解析(跳过) - 偏移 40-47 : u64 amount 成交额(原值) - 偏移 48-51 : u32 open_interest 持仓量 - 偏移 52-59 : 未解析(跳过) - 偏移 60-63 : u32 pre_close 昨收(÷1000)用法: python qmt_min_parser.py <datadir>/SH/60/000001.DAT"""import csvimport osimport structimport sysfrom dataclasses import dataclassfrom datetime import datetime, timezone, timedeltaRECORD_SIZE = 64PRICE_SCALE = 1000.0# 64 字节 = 16 个小端 u32;u64 amount 由相邻两个 u32 拼出RECORD = struct.Struct("<16I")BEIJING = timezone(timedelta(hours=8))@dataclassclass MinKline: time: datetime # 北京时间 open: float high: float low: float close: float volume: int # 成交量 amount: float # 成交额(元) open_interest: int # 持仓量(股票为 0) pre_close: float # 昨收def parse_metadata_from_path(path: str) -> tuple: """从路径 .../SH/60/000001.DAT 提取 (market, period_sec, symbol)。""" parts = [p for p in path.replace("\\", "/").split("/") if p] fname = parts[-1] symbol = os.path.splitext(fname)[0] period = parts[-2] if len(parts) >= 2 else "" market = "" for p in reversed(parts[:-2]): if p.upper() in ("SH", "SZ", "BJ"): market = p.upper() break return market, period, symboldef parse_min_file(path: str) -> list: market, period, symbol = parse_metadata_from_path(path) bars = [] with open(path, "rb") as f: data = f.read() # 不足 64 字节的尾部残片直接丢弃 n = len(data) // RECORD_SIZE for i in range(n): u = RECORD.unpack_from(data, i * RECORD_SIZE) ts = u[2] # 偏移 8 o, h, l, c = u[3], u[4], u[5], u[6] # 偏移 12/16/20/24 volume = u[8] # 偏移 32 amount = u[10] | (u[11] << 32) # 偏移 40,u64 oi = u[12] # 偏移 48 pre_c = u[15] # 偏移 60 bars.append(MinKline( time=datetime.fromtimestamp(ts, BEIJING), open=o / PRICE_SCALE, high=h / PRICE_SCALE, low=l / PRICE_SCALE, close=c / PRICE_SCALE, volume=volume, amount=float(amount), open_interest=oi, pre_close=pre_c / PRICE_SCALE, )) return market, period, symbol, barsdef main(): path = sys.argv[1] if len(sys.argv) > 1 else \ r"D:\lwj\国金证券QMT交易端\datadir\SH\60\000001.DAT" market, period, symbol, bars = parse_min_file(path) print(f"文件: {path}") print(f"标的: {market}{symbol} 周期: {period}秒 记录数: {len(bars)}") if not bars: print("没有解析到任何记录") return days = sorted({b.time.strftime("%Y-%m-%d") for b in bars}) print(f"日期范围: {days[0]} ~ {days[-1]} 覆盖 {len(days)} 个交易日") print("\n前 5 条:") print(f"{'时间':<20}{'开':>10}{'高':>10}{'低':>10}{'收':>10}" f"{'量':>14}{'额':>18}{'昨收':>10}") for b in bars[:5]: print(f"{b.time.strftime('%Y-%m-%d %H:%M'):<20}{b.open:>10.3f}" f"{b.high:>10.3f}{b.low:>10.3f}{b.close:>10.3f}" f"{b.volume:>14,}{b.amount:>18,.0f}{b.pre_close:>10.3f}") print("\n后 5 条:") for b in bars[-5:]: print(f"{b.time.strftime('%Y-%m-%d %H:%M'):<20}{b.open:>10.3f}" f"{b.high:>10.3f}{b.low:>10.3f}{b.close:>10.3f}" f"{b.volume:>14,}{b.amount:>18,.0f}{b.pre_close:>10.3f}") # 导出 CSV out = os.path.splitext(os.path.basename(path))[0] + f"_{market}_{period}s.csv" with open(out, "w", newline="", encoding="utf-8-sig") as f: w = csv.writer(f) w.writerow(["time", "open", "high", "low", "close", "volume", "amount", "open_interest", "pre_close"]) for b in bars: w.writerow([b.time.strftime("%Y-%m-%d %H:%M:%S"), b.open, b.high, b.low, b.close, b.volume, b.amount, b.open_interest, b.pre_close]) print(f"\n已导出 CSV: {os.path.abspath(out)}")if __name__ == "__main__": main()
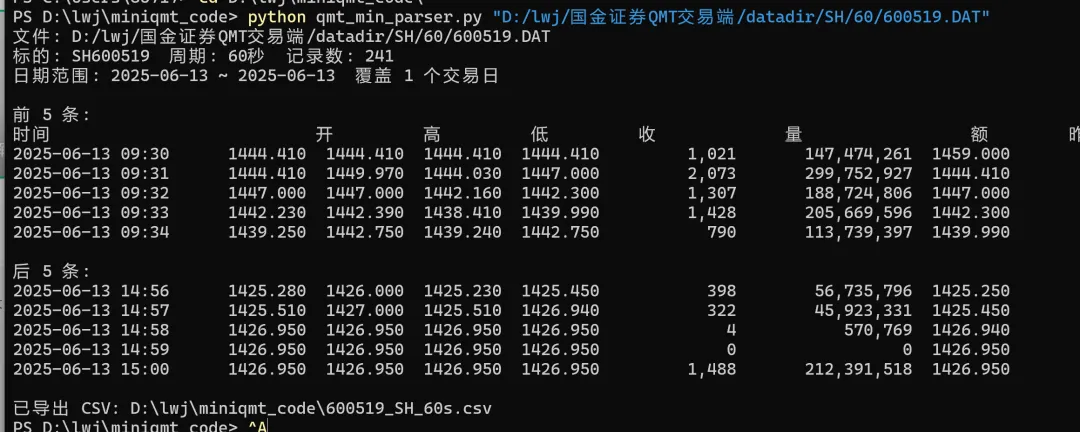
四、运行结果
如果你有迅投qmt开户需求,可以找我沟通交流,费率优惠。
 10个月宝宝每天需要喝多少奶粉?