凌晨两点,后台任务的报警把我震醒:2013,Lost connection to MySQL server during query。重跑一次,好了,接着睡。第二天凌晨,又断。那阵子我在做政务系统的数据同步,Python + SQLAlchemy + PyMySQL,扫的是百万级的 MySQL 大表。断连反反复复折腾了好几轮,最后发现一件事:锅不在数据库,在我们自己写的代码里。
下面这些,是三个项目踩完坑之后我记下来的东西。你可以直接拿去自查。
图注:数据管道断在凌晨——MySQL断连的典型瞬间
▍01 一条铁律,先记下来
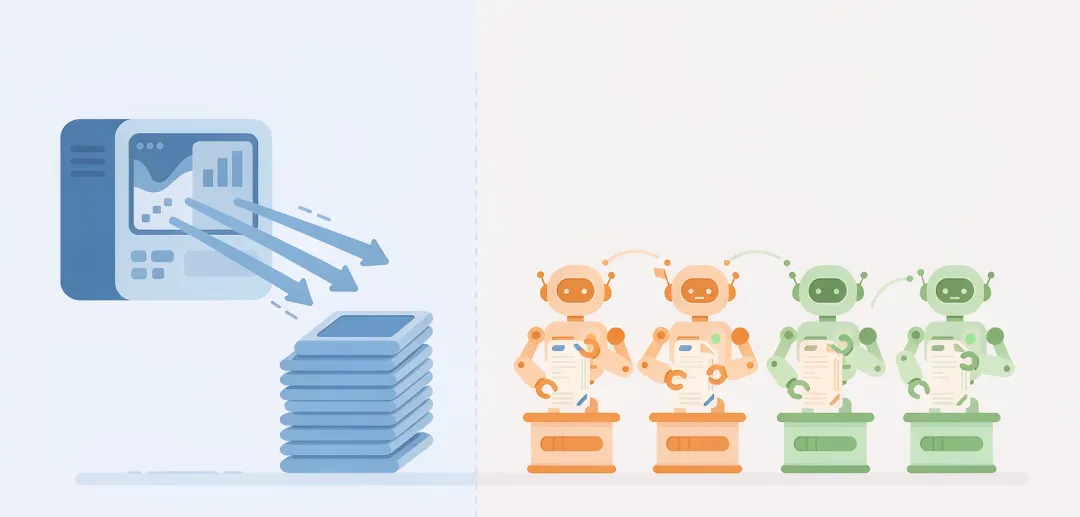
扫描和处理,必须分开。先把结果集快速读完、释放连接,再去内存里处理。处理的时候,手里不握任何 MySQL 连接。
听起来简单?但我们翻车的每一处,都是违反了它:边读边处理、处理时把连接攥在手里、generator 惰性迭代做耗时空转。百万级数据量下,踩一条崩一条。
▍02 断连之前,先分清三种超时
报错不可怕,可怕的是分不清谁在超时。
wait_timeout,默认 8 小时,管的是空闲连接。闲置太久被服务端回收,下次取出来用就报 2006,MySQL server has gone away。
net_write_timeout,默认只有 60 秒,管的是服务端发数据、你收得太慢。fetchone 读到一半断掉的 2013,多半是它。
net_read_timeout,默认 30 秒,方向反过来,是服务端等客户端发数据。
这里有个高频误判:很多人一看 2013,扭头就去调大 wait_timeout。没用。2013 during query 卡的是 net_write_timeout,两个参数根本不挨着。参数没毛病,有毛病的是代码架构。
图注:三种 timeout,三种命运——别再傻傻分不清
▍03 三种写法,三种死法
最先中招的,是 SQLAlchemy 的 generator 配 yield_per。文档写得像流式,但在 PyMySQL 上它不是真正的服务端游标,行还是先缓存进客户端。内存照涨,连接照攥,两头都没占到便宜。
第二个坑更隐蔽。有人换成了 SSCursor,服务端游标,内存确实稳了——结果在读取循环里 submit 慢任务,用 wait 卡并发。并发一堵,fetchone 就停,停满 60 秒,服务端直接挂断。SSCursor 只管内存,不管你处理时还握着连接这件事。
还有一个坑埋在连接池:不设 pool_pre_ping,取到一条早被回收的死连接,用的时候才炸;不设 pool_recycle,空闲连接越堆越多,最后 1040,Too many connections。
▍04 后来我们怎么改的
分两段。
第一段,老老实实用 SSCursor,在 with 块里一口气 fetchone 读完,装进 list,出块就释放连接。循环里只有读,没有别的。
第二段,连接还了,再开线程池在内存里跑。这一段里任务卡多久都无所谓,反正不碰数据库。
百万行、字段精简的话,内存大概两三百 MB,扛得住。连接池配上 pool_pre_ping=True,pool_recycle 压到服务端 wait_timeout 以下,查询做成幂等——中途挂了整轮重跑也安全。改完之后,那类报警再没响过。
图注:先读完再处理——两阶段架构根治方案
▍05 排查的时候,从报错倒推
fetch 途中报 2013,去查处理阶段是不是握着连接;
闲置之后报 2006,去查 pool_pre_ping 和 pool_recycle;
连接数 1040,去查池大小和 finally 里有没有释放。
至于 SSCursor——记住它只解决内存。内存和超时一起解决的,是两阶段。
▍06 送你一段提示词,直接粘给 AI
现在很多人写这类代码是让 AI 代劳的。但你不说清楚要求,它大概率给你生成一套"generator + yield_per 边读边处理"的标准答案——正是第一种死法。
下面这段,是我踩完坑之后整理的前置要求。让 AI 写扫描代码之前,直接整段粘进对话:
【MySQL 大数据量扫描硬性要求】
1. 禁止用 SQLAlchemy generator + yield_per/mappings 做惰性流式迭代并边迭代边处理;大表扫描必须用 PyMySQL SSCursor 真服务端游标,且必须两阶段:阶段 1 在 with 块内一次性 fetchone 循环读完入内存 list,连接释放后才 return;阶段 2 在内存里并发处理,不持有任何 MySQL 连接。
2. SSCursor 创建方式:s.connection() 完成 dialect 初始化后,用 raw_conn.cursor(pymysql.cursors.SSCursor) 显式创建;不要在 connect_args 里传 cursorclass。
3. 读取循环内禁止 submit 业务任务、禁止 wait/阻塞、禁止任何远程调用,保持纯读。
4. 连接池必须设 pool_pre_ping=True,pool_recycle 低于服务端 wait_timeout。
5. 说明内存占用估算(列要精简),并配套幂等设计:已处理行可被过滤,失败可重试。
6. 远程跨网络访问 MySQL 时,注意 net_write_timeout(默认 60 秒)陷阱,不要靠调大服务端 timeout 掩盖架构问题。
(长按可复制整段)
把这段存下来。下次让 AI 写扫描代码之前先粘上,比断连之后连夜救火省心多了。
下次再被凌晨的断连报警震醒,先别骂数据库,回头看看自己的读取循环。