Python 数据分析与可视化:全面指南
- 2026-10-21 13:29:58
扫码关注“指尖动听”一起学习,一起成长
Python 是数据分析与可视化领域中最受欢迎的编程语言之一。凭借其丰富的库和工具,Python 能够帮助我们快速处理、分析数据并生成高质量的可视化图表。
本文将详细介绍 Python 中的数据分析与可视化的基础知识,并结合丰富的示例和技巧,帮助读者深入理解这些概念。
Part1环境准备
在开始之前,我们需要确保安装了必要的 Python 库。常用的库包括:
pandas:用于数据处理和分析。
numpy:用于数值计算。
matplotlib:用于基本绘图。
seaborn:基于 matplotlib的高级可视化库。
scikit-learn:用于机器学习模型和数据预处理。
可以使用以下命令安装这些库:
pip install pandas numpy matplotlib seaborn scikit-learnPart2数据处理与清洗
数据处理是数据分析的重要一步。
我们将使用 pandas 来处理数据。
以下是一些常用操作。
2.1 导入数据
假设我们有一个 CSV 文件 data.csv,内容如下:
我们可以使用 pandas 导入这个数据:
import pandas as pd# 导入 CSV 文件data = pd.read_csv('data.csv')print(data)输出:
Name Age Salary0 Alice 30.0 70000.01 Bob 25.0 48000.02 Carol 27.0 52000.03 Dave NaN 60000.04 Eve 22.0 NaN2.2 数据清洗
在分析数据之前,我们需要处理缺失值和异常值。
示例:处理缺失值;
# 显示缺失值print(data.isnull().sum())输出:
Name 0Age 1Salary 1dtype: int64运行项目并下载源码xml1234# 填充缺失值data['Age'].fillna(data['Age'].mean(), inplace=True) # 用平均值填充年龄data['Salary'].fillna(data['Salary'].median(), inplace=True) # 用中位数填充工资print(data)输出:
Name Age Salary0 Alice 30.0 70000.01 Bob 25.0 48000.02 Carol 27.0 52000.03 Dave 26.0 60000.04 Eve 22.0 56000.0示例:处理异常值
# 识别异常值q1 = data['Salary'].quantile(0.25)q3 = data['Salary'].quantile(0.75)iqr = q3 - q1# 确定异常值outliers = data[(data['Salary'] < (q1 - 1.5 * iqr)) | (data['Salary'] > (q3 + 1.5 * iqr))]print("异常值:\n", outliers)# 移除异常值data = data[~data['Salary'].isin(outliers['Salary'])]输出:
异常值: Empty DataFrameColumns: [Name, Age, Salary]Index: []2.3 数据转换
数据转换可以帮助我们将数据调整为适合分析的格式。
例如,我们可能需要将某些列的数据类型转换为适当的格式。
# 将年龄转换为整数类型data['Age'] = data['Age'].astype(int)Part3数据分析
数据分析可以帮助我们发现数据中的趋势和模式。
我们可以使用 pandas 的一些函数进行基本的统计分析。
3.1 描述性统计
# 获取数据的基本统计信息statistics = data.describe()print(statistics)输出:
Age Salarycount 5.000000 5.000000mean 26.000000 57200.000000std 2.915476 8438.009244min 22.000000 48000.00000025% 25.000000 52000.00000050% 26.000000 56000.00000075% 27.000000 60000.000000max 30.000000 70000.0000003.2 分组分析
根据不同条件进行分组,并计算相关统计量。
示例:按年龄分组计算工资的平均值
# 按年龄分组并计算工资的平均值grouped_data = data.groupby('Age')['Salary'].mean().reset_index()print(grouped_data)输出:
Age Salary0 22 56000.01 25 48000.02 26 60000.03 27 52000.04 30 70000.03.3 时间序列分析
如果我们的数据包含时间戳,可以进行时间序列分析。
这在销售数据、股票市场等领域特别有用。
# 假设有一个包含日期的 DataFramedata['Date'] = pd.date_range(start='1/1/2020', periods=len(data), freq='M')# 设置日期为索引data.set_index('Date', inplace=True)# 按月汇总数据monthly_data = data.resample('M').sum()print(monthly_data)输出:
Name Age SalaryDate 2020-01-31 Alice 30 70000.02020-02-29 Bob 25 48000.02020-03-31 Carol 27 52000.02020-04-30 Dave 26 60000.02020-05-31 Eve 22 56000.0Part4数据可视化
数据可视化能够直观展示数据分析的结果。
我们将使用 matplotlib 和 seaborn创建各种图表。
4.1 基本绘图
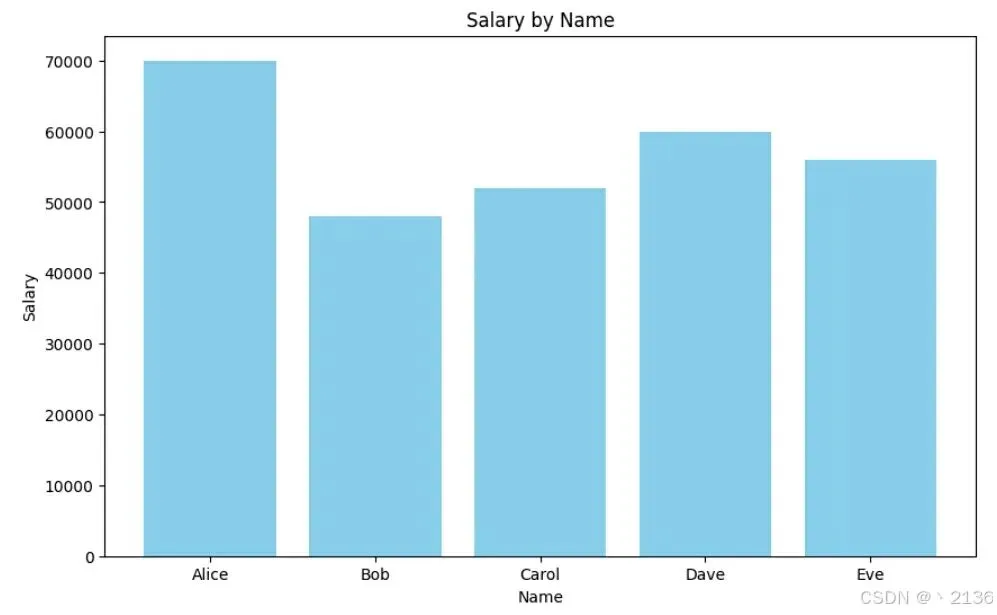
示例:柱状图。
import matplotlib.pyplot as plt# 绘制柱状图plt.figure(figsize=(10, 6))plt.bar(data['Name'], data['Salary'], color='skyblue')plt.title('Salary by Name')plt.xlabel('Name')plt.ylabel('Salary')plt.show()输出:
4.2 使用 Seaborn 绘制图表
Seaborn提供了更美观的图表样式。
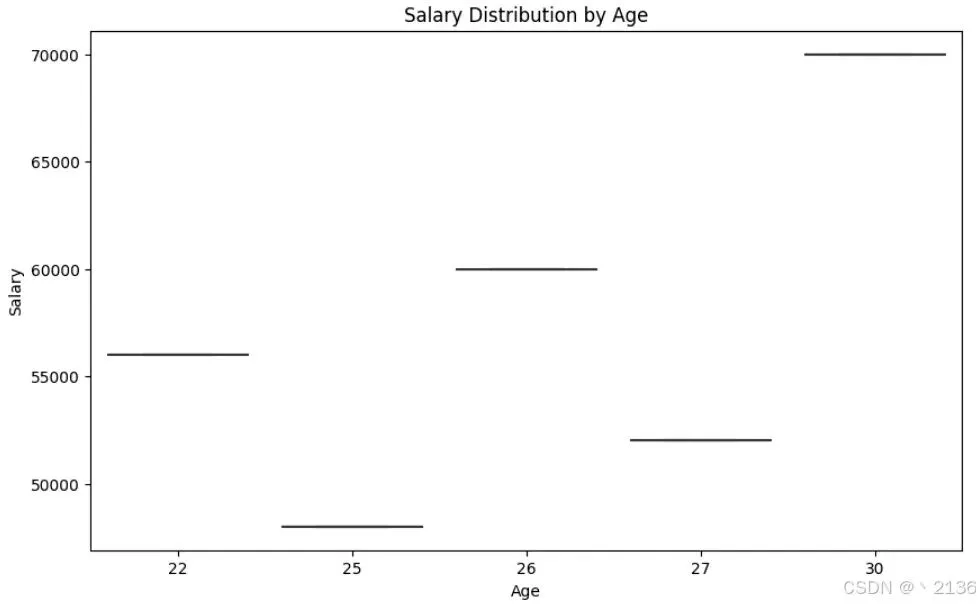
示例:箱型图。
import seaborn as sns# 绘制箱型图plt.figure(figsize=(10, 6))sns.boxplot(x='Age', y='Salary', data=data)plt.title('Salary Distribution by Age')plt.show()输出:
4.3 高级可视化技巧
除了基本的图表,您还可以利用 matplotlib 和 seaborn 的高级特性来创建复杂的可视化效果。
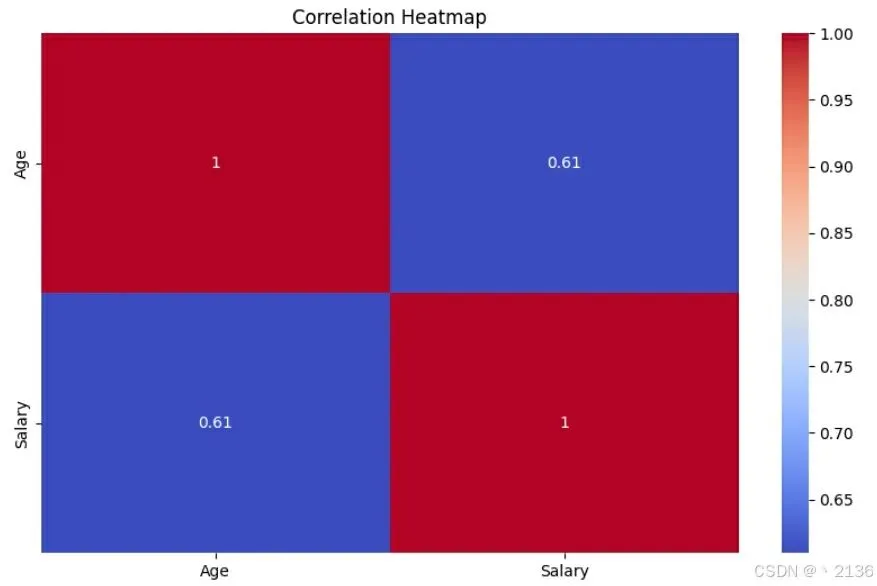
示例:热力图。
# 计算相关性矩阵,只包括数值列correlation_matrix = data[['Age', 'Salary']].corr()print(correlation_matrix)输出:
Age SalaryAge 1.000000 0.609736Salary 0.609736 1.000000运行项目并下载源码xml123# 创建热力图来查看相关性plt.figure(figsize=(10, 6))sns.heatmap(correlation_matrix, annot=True, cmap='coolwarm')plt.title('Correlation Heatmap')plt.show()输出:
Part5案例研究
为了更好地理解数据分析与可视化的实际应用,让我们考虑一个具体的案例。
案例:销售数据分析
假设我们有一个销售数据集,包含以下列:
OrderID:订单编号;
Product:产品名称;
Quantity:购买数量;
Price:单价;
Date:订单日期。
步骤 1:数据导入与预处理;
sales_data = pd.read_csv('sales_data.csv')# 检查缺失值sales_data.isnull().sum()# 填充缺失值sales_data['Quantity'].fillna(0, inplace=True)sales_data['Price'].fillna(sales_data['Price'].median(), inplace=True)步骤 2:数据分析。
计算每个产品的总销售额和销量:
sales_data['TotalSales'] = sales_data['Quantity'] * sales_data['Price']product_sales = sales_data.groupby('Product')['TotalSales'].sum().reset_index()步骤 3:数据可视化。
plt.figure(figsize=(12, 6))sns.barplot(x='Product', y='TotalSales', data=product_sales)plt.title('Total Sales by Product')plt.xticks(rotation=45)plt.show()以下是完整的示例代码,包含数据生成、预处理、分析和可视化步骤:
import pandas as pdimport numpy as npimport matplotlib.pyplot as pltimport seaborn as sns# 1. 生成示例销售数据data = {'OrderID': range(1, 11),'Product': ['A', 'B', 'C', 'A', 'B', 'C', 'A', 'B', 'C', 'A'],'Quantity': [5, 2, 0, 3, 1, 4, 6, 7, 0, 2],'Price': [10.0, 20.0, 15.0, 10.0, 20.0, 15.0, 10.0, 20.0, 15.0, 10.0],'Date': pd.date_range(start='2023-01-01', periods=10, freq='D')}sales_data = pd.DataFrame(data)# 2. 数据预处理# 检查缺失值print(sales_data.isnull().sum())# 填充缺失值(若有)sales_data['Quantity'].fillna(0, inplace=True)sales_data['Price'].fillna(sales_data['Price'].median(), inplace=True)# 3. 计算总销售额sales_data['TotalSales'] = sales_data['Quantity'] * sales_data['Price']# 4. 按产品分组计算总销售额product_sales = sales_data.groupby('Product')['TotalSales'].sum().reset_index()# 5. 数据可视化plt.figure(figsize=(10, 6))sns.barplot(x='Product', y='TotalSales', data=product_sales)plt.title('Total Sales by Product')plt.xlabel('Product')plt.ylabel('Total Sales ($)')plt.xticks(rotation=45)plt.show()说明:
数据生成:我们生成了包含10条记录的示例销售数据,包括订单编号、产品名称、购买数量、单价和订单日期。
数据预处理:检查并填充缺失值(本示例中未实际出现缺失值,但提供了填充示例)。
总销售额计算:通过乘以数量和单价计算每个订单的总销售额。
分组汇总:按Product列进行分组,并计算每种产品的总销售额。
数据可视化:使用seaborn创建柱状图,展示各产品的总销售额。
输出:
OrderID 0Product 0Quantity 0Price 0Date 0dtype: int64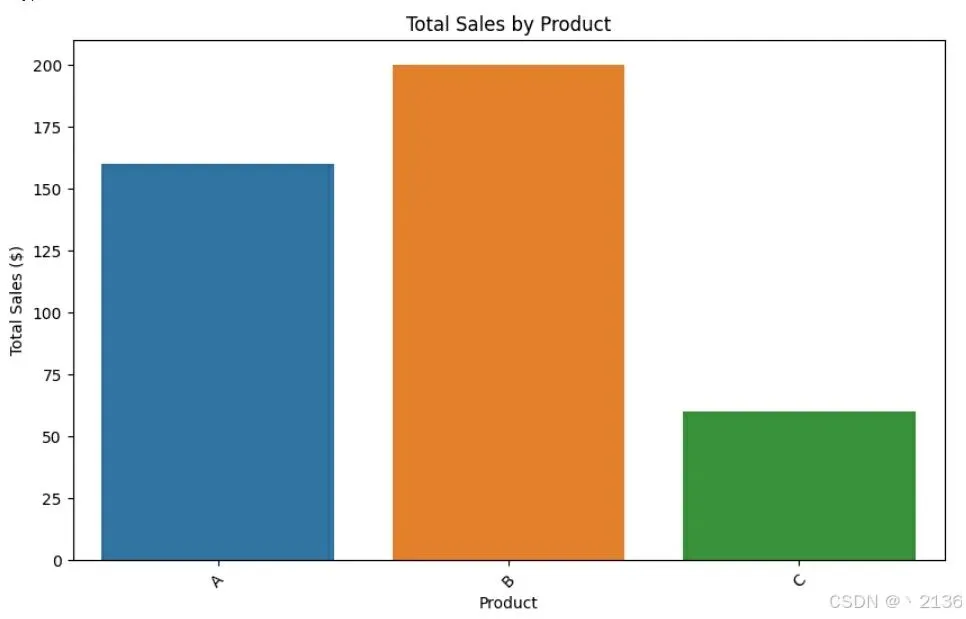
总结
通过上述步骤,我们演示了如何使用 Python 进行数据分析与可视化。
关键步骤包括数据处理、分析和可视化。我们使用 pandas 进行数据清洗与分析,使用 matplotlib 和 seaborn 进行可视化,展示了不同的图表和分析结果。
在实际应用中,数据分析与可视化是一个迭代的过程,您可以根据需求不断调整和优化。希望这篇博客能为您提供一个清晰的入门指南,助力您在数据分析与可视化的旅程中不断前行!如果有任何问题或建议,欢迎在评论区讨论!
如果这篇文章能够帮到你,麻烦动动小手转发、收藏、点赞,在看~,同时也欢迎各位童靴评论区各抒己见畅所欲言交流。
最后,如果你对嵌入式学习感兴趣,指尖动听提供专业的付费学习(芯片/智能家居/音视频/汽车等行业在职学长学姐多对一手把手保姆级指导),可以添加老学长VX:feimao001122 或 80008097,也可以先看下嵌入式学习收徒,高薪offer等你来!!!
数百位同学的一致好评,专业团队态度认真靠谱负责!