引用声明原文作者:Jobin Augustine原文链接:https://www.percona.com/blog/why-linux-hugepages-are-super-important-for-database-servers-a-case-with-postgresql/
一、问题背景
在数据库运维实践中,由 OOM Killer(Out Of Memory Killer)导致的 PostgreSQL 进程终止是最常见的崩溃原因。OOM Killer 会终止 PostgreSQL 进程,这是向 Percona 报告的大多数 PostgreSQL 数据库崩溃的首要原因。
导致主机内存耗尽的常见原因包括:
- 主机内存配置不当:系统级内存参数未针对数据库工作负载优化
- work_mem 全局设置过高:在实例级别设置高值会产生倍增效应,用户常低估这种全局配置的影响
二、测试环境
2.1 硬件配置
- **Transparent HugePages (THP)**:已禁用
2.2 pgBouncer 配置
为模拟应用端连接池(或外部连接池)的持久连接行为,使用 pgBouncer 维持 80 个持久连接。
配置文件内容:
[databases]sbtest2 = host=localhost port=5432 dbname=sbtest2[pgbouncer]listen_port = 6432listen_addr = *auth_type = md5auth_file = /etc/pgbouncer/userlist.txtlogfile = /tmp/pgbouncer.logpidfile = /tmp/pgbouncer.pidadmin_users = postgresdefault_pool_size = 100min_pool_size = 80server_lifetime = 432000
关键参数说明:
server_lifetime = 432000:设置为高值(5天),防止从连接池到 PostgreSQL 的连接被销毁
2.3 PostgreSQL 配置
为模拟常见客户环境,进行以下参数调整:
logging_collector = 'on'max_connections = '1000'work_mem = '32MB'checkpoint_timeout = '30min'checkpoint_completion_target = '0.92'shared_buffers = '138GB'shared_preload_libraries = 'pg_stat_statements'
2.4 测试负载生成
使用 sysbench 创建测试负载。
准备阶段(生成写负载):
sysbench /usr/share/sysbench/oltp_point_select.lua \ --db-driver=pgsql \ --pgsql-host=localhost \ --pgsql-port=6432 \ --pgsql-db=sbtest2 \ --pgsql-user=postgres \ --pgsql-password=vagrant \ --threads=80 \ --report-interval=1 \ --tables=100 \ --table-size=37000000 \ prepare
执行阶段(生成只读负载):
sysbench /usr/share/sysbench/oltp_point_select.lua \ --db-driver=pgsql \ --pgsql-host=localhost \ --pgsql-port=6432 \ --pgsql-db=sbtest2 \ --pgsql-user=postgres \ --pgsql-password=vagrant \ --threads=80 \ --report-interval=1 \ --time=86400 \ --tables=80 \ --table-size=37000000 \ run
三、未启用 HugePages 的测试观察
3.1 内存消耗趋势
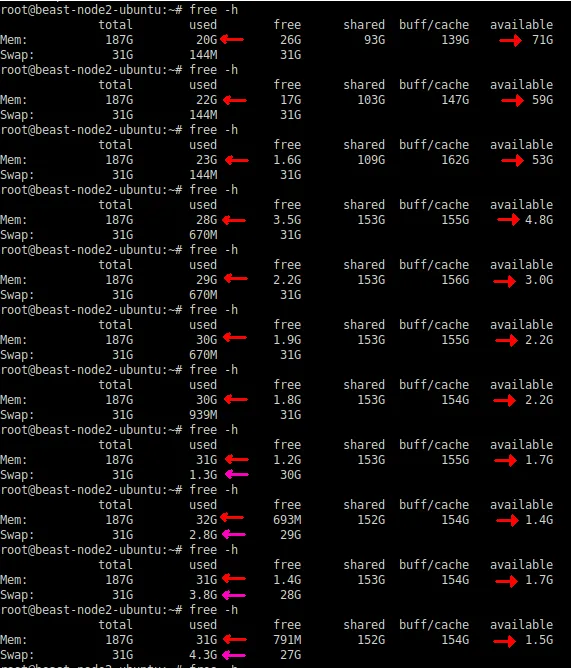
使用 Linux free 命令监控内存消耗。测试表明,使用常规内存页池时:
观察到的趋势:
原文指出:"Available memory is depleted at a faster rate"(可用内存以更快的速度耗尽),"Towards the end, it started swap activity"(最后开始了 Swap 活动)。
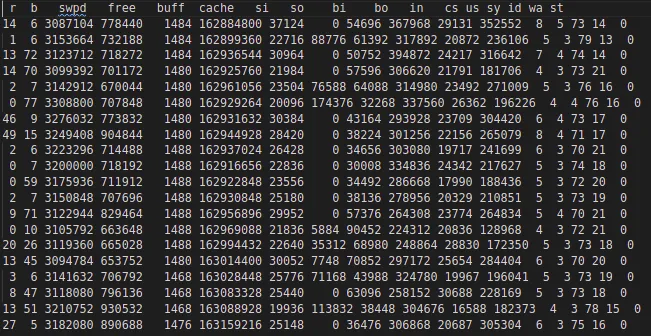
3.2 Swap 活动监控
原文观察到 Swap 活动的出现,说明系统开始将内存页面交换到磁盘,这是内存压力的明显信号。
通过 vmstat 命令可以监控 Swap 活动(关注 si 和 so 列,分别表示 swap in 和 swap out)。
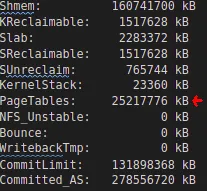
3.3 页表大小分析
从 /proc/meminfo 查看的信息显示:
测试初期:
$ grep PageTables /proc/meminfoPageTables: 45876 kB
数小时后:
$ grep PageTables /proc/meminfoPageTables: 26214400 kB # 约 25GB
总页表大小(PageTables)从初始的 45MB 增长到超过 25GB
这不仅是内存浪费,更是对程序执行和操作系统整体运行的巨大开销。这个大小是 80+ 个 PostgreSQL 进程的下级页表条目(Lower PageTable entries)总和。
3.4 单个进程的页表开销
检查单个 PostgreSQL 进程的页表大小:
$ grep PageTables /proc/12345/smapsPageTables: 327680 kB # 约 320MB
单个进程的页表约为 320MB,因此总页表大小(25GB)≈ 320MB × 80(连接数)= 25.6GB
由于这个合成基准测试通过所有连接发送几乎相同的工作负载,所有单独的进程都有非常接近的值。
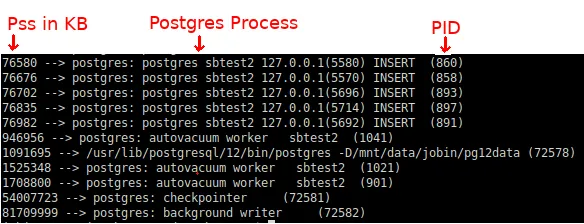
3.5 进程内存责任分析(Pss)
由于 PostgreSQL 使用 Linux 共享内存,关注 RSS(Resident Set Size)意义不大。应使用 Pss(Proportional Set Size,比例集大小)进行分析。
使用以下 shell 命令检查 Pss:
for PID in $(pgrep "postgres|postmaster"); do awk '/Pss/ {PSS+=$2} END{ getline cmd < "/proc/'$PID'/cmdline"; sub("\0", " ", cmd); printf "%.0f --> %s (%s)\n", PSS, cmd, '$PID' }' /proc/$PID/smapsdone | sort -n
未启用 HugePages 时的 Pss 输出示例:
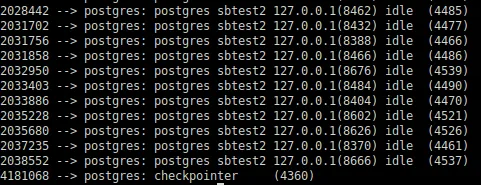
98304 --> postgres: sbtest2 postgres idle (8234)98560 --> postgres: sbtest2 postgres idle (8235)...102400 --> postgres: autovacuum worker (7892)3145728 --> postgres: checkpointer (7845) # 约 3GB2621440 --> postgres: background writer (7846) # 约 2.5GB
在典型的有大量 DML 负载的数据库系统中,PostgreSQL 的后台进程(如 Checkpointer、Background Writer 或 Autovacuum workers)会触及共享内存中更多的页面,相应的 Pss 会更高。
关键发现:
这解释了为什么 Checkpointer、Background Worker 甚至 Postmaster 经常成为 OOM Killer 的常见受害者/目标。如上所示,它们承担了共享内存的最大责任。
经过数小时执行后,各个会话触及了更多共享内存页面。结果是每个进程的 Pss 值重新分配:
152576 --> postgres: sbtest2 postgres idle (8234)155648 --> postgres: sbtest2 postgres idle (8235)...1835008 --> postgres: checkpointer (7845) # 约 1.8GB(仍然最高)1310720 --> postgres: background writer (7846) # 约 1.3GB
Checkpointer 的责任减少,因为其他会话分担了责任,但 Checkpointer 仍然保持最高份额。
注意:这种负载模式特定于合成基准测试,因为每个会话做的工作几乎相同。这不能很好地近似典型的应用负载,在实际应用中通常会看到 Checkpointer 和 Background Writer 承担主要责任。
注:附上原文中的图片,方便读者有直观的感受

四、解决方案:启用 HugePages
4.1 计算所需的 HugePages 大小
通过检查 postmaster 进程的 VmPeak 来确定需要为 HugePages 分配多少内存。
假设 postmaster 的 PID 为 4357:
$ grep ^VmPeak /proc/4357/statusVmPeak: 148392404 kB
这给出了所需内存量(单位 KB),需要将其转换为 2MB 的页面数量:
postgres=# SELECT 148392404/1024/2; ?column? ---------- 72457(1 row)
4.2 配置 HugePages
在 /etc/sysctl.conf 中指定 vm.nr_hugepages 的值:
vm.nr_hugepages = 72457
4.3 应用配置
关闭 PostgreSQL 实例,然后执行:
$ sudo sysctl -pvm.nr_hugepages = 72457
4.4 验证 HugePages 创建
检查请求的 HugePages 数量是否已创建:
$ grep ^Huge /proc/meminfoHugePages_Total: 72457HugePages_Free: 72457HugePages_Rsvd: 0HugePages_Surp: 0Hugepagesize: 2048 kBHugetlb: 148391936 kB
4.5 启动 PostgreSQL 并验证分配
启动 PostgreSQL 后,可以看到 HugePages_Rsvd 已被分配:
$ grep ^Huge /proc/meminfoHugePages_Total: 72457HugePages_Free: 70919HugePages_Rsvd: 70833HugePages_Surp: 0Hugepagesize: 2048 kBHugetlb: 148391936 kB
解读:
HugePages_Free 减少了约 1538 个页面(72457 - 70919)HugePages_Rsvd 为 70833,表示 PostgreSQL 已预留这些页面
4.6 强制 PostgreSQL 使用 HugePages
如果一切正常,建议确保 PostgreSQL 始终使用 HugePages。这样可以让 PostgreSQL 在启动时失败,而不是在后期出现问题/崩溃。
postgres=# ALTER SYSTEM SET huge_pages = on;ALTERSYSTEM
此更改需要重启 PostgreSQL 实例。
五、启用 HugePages 后的测试结果
5.1 HugePages 的预分配特性
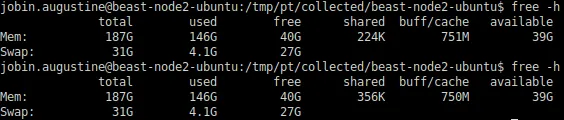
HugePages 在 PostgreSQL 启动之前就已创建。PostgreSQL 只是分配并使用它们。因此,在 free 输出中,PostgreSQL 启动前后不会有明显变化。
PostgreSQL 启动前:
$ free -h total used free shared buff/cache availableMem: 188G 40G 145G 138G 2.5G 145GSwap: 15G 0B 15G
PostgreSQL 启动后:
$ free -h total used free shared buff/cache availableMem: 188G 40G 144G 138G 3.5G 145GSwap: 15G 0B 15G
说明:几乎没有明显变化,因为 HugePages 已预先分配。
5.2 长时间运行的内存表现
进行了与之前相同的测试,运行数小时。
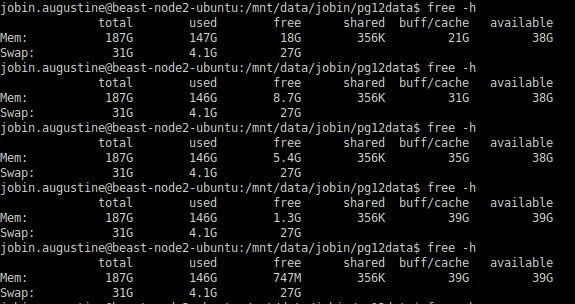
唯一明显的变化是"free"内存转移到文件系统缓存(buff/cache),这是预期的且是我们想要达到的效果。总"available"内存保持相当恒定。
原文描述:
- 未启用 HugePages 时:可用内存完全耗尽,出现 Swap 活动
- 启用 HugePages 后:38-39GB 保持为 Available/Linux 文件系统缓存
5.3 页表大小对比
未启用 HugePages:
$ grep PageTables /proc/meminfoPageTables: 26214400 kB # 约 25GB
启用 HugePages:
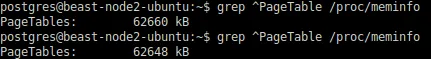
$ grep PageTables /proc/meminfoPageTables: 62464 kB # 约 61MB
对比结果:
5.4 每个会话的 Pss 大幅降低
启用 HugePages 后的 Pss 输出:
2048 --> postgres: sbtest2 postgres idle (8234) # 约 2MB2048 --> postgres: sbtest2 postgres idle (8235) # 约 2MB...2560 --> postgres: autovacuum worker (7892) # 约 2.5MB4096 --> postgres: checkpointer (7845) # 约 4MB3584 --> postgres: background writer (7846) # 约 3.5MB
注:附上原文中的图片,方便读者有直观的感受
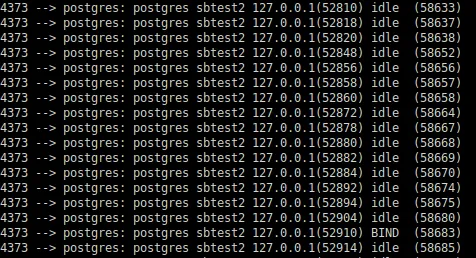
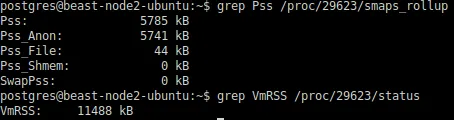
对比(未启用 vs 启用 HugePages):
最大优势:Checkpointer 或 Background Writer 不再对数 GB 的 RAM 负责,它们仅对几 MB 的消耗负责。显然,它们不再是 OOM Killer 的候选受害者。
六、核心数据对比总结
6.1 关键指标对比表
| | | |
|---|
| 可用内存状态(长时间运行后) | | | 显著改善 |
| Swap 活动 | | | 完全避免 |
| 总页表大小 | | | 减少 99.76% |
| 单个连接 Pss | | | 减少 98% |
| Checkpointer Pss | | | 减少 99.87% |
| Background Writer Pss | | | 减少 99.86% |
6.2 核心改进
启用 Linux HugePages 可以在两个方面显著改善数据库服务器:
1. 内存消耗大幅减少
- 未启用 HugePages:服务器几乎耗尽内存(可用内存完全耗尽,开始出现 Swap 活动)
- 启用 HugePages:38-39GB 保持为 Available/Linux 文件系统缓存,无 Swap
这是显著的改善,系统从濒临 OOM 变为稳定运行。
2. 降低 OOM Killer 风险
启用 HugePages 后,PostgreSQL 后台进程不再对大量共享内存负责(从 GB 级降至 MB 级)。因此,它们不会轻易成为 OOM Killer 的候选受害者/目标。
6.3 适用范围说明
这些改进可以在系统处于 OOM 临界状态时潜在地挽救系统,但不声称这将永远保护数据库免受所有 OOM 条件的影响。
6.4 设计历史
HugePage(hugetlbfs)最初于 2002 年登陆 Linux 内核,用于解决需要寻址大量内存的数据库系统的需求。可以看到,设计目标至今仍然有效。
七、HugePages 的其他间接优势
7.1 性能稳定性
HugePages 永远不会被交换出去(swap out)。当 PostgreSQL 共享缓冲池位于 HugePages 中时,它可以产生更一致和可预测的性能。
7.2 地址转换效率
Linux 使用多级页查找方法:
- 常规页面(4KB):需要通过多级页表(PGD → PUD → PMD → PTE)进行地址转换
- HugePages(2MB):直接在中间层(PMD 级别)使用直接指针找到,无需中间 PTE 页
地址转换变得相当简单。由于这是数据库服务器中处理大量内存的高频操作,收益会成倍增加。
7.3 技术背景
详细的技术概念和理论可以参考:
- LWN 文章:Five-Level Page Tables
- Andres Freund 的博客文章:Measuring the Memory Overhead of a Postgres Connection
八、关于 Transparent HugePages (THP)
8.1 重要区分
注意:本文讨论的 HugePages 是关于固定大小(2MB)的 HugePages(hugetlbfs),而不是 Transparent HugePages (THP)。
8.2 THP 的现状
多年来,Transparent HugePages (THP) 有很多改进,允许应用程序在不修改任何代码的情况下使用 HugePages。THP 通常被认为是通用工作负载的常规 HugePages(hugetlbfs)的替代品。
8.3 为什么数据库不推荐 THP
然而,在数据库系统上不鼓励使用 THP,因为它可能导致:
这些不是 PostgreSQL 特有的问题,而是影响每个数据库系统。
8.4 业界建议
主流数据库厂商的官方建议:
1. Oracle
建议禁用 THP。参考链接:https://docs.oracle.com/en/database/oracle/oracle-database/19/ladbi/disabling-transparent-hugepages.html
2. MongoDB
建议禁用 THP。参考链接:https://docs.mongodb.com/manual/tutorial/transparent-huge-pages/
3. PostgreSQL
官方文档指出:"在某些 Linux 版本上,THP 已知会导致某些用户的 PostgreSQL 性能下降。"参考链接:https://www.postgresql.org/docs/current/runtime-config-resource.html
九、实施建议与风险提示
9.1 测试验证的必要性
本文所有配置和测试结果基于特定环境。实际效果会因以下因素而异:
9.2 实施前的准备工作
在生产环境应用前,务必执行以下步骤:
1. 在测试环境中完整验证
2. 监控关键指标
执行前后对比监控:
- 页表大小(
grep PageTables /proc/meminfo) - HugePages 使用情况(
grep ^Huge /proc/meminfo) - Swap 活动(
vmstat 中的 si/so 列)
3. 逐步调整参数
- 先按照本文方法计算初始值(VmPeak / 1024 / 2)
- 根据实际运行情况微调
vm.nr_hugepages - 监控
HugePages_Free 确保不浪费内存(剩余页面过多表示分配过量)
4. 评估潜在风险
- HugePages 设置过大:可能导致其他进程可用内存不足,引发 OOM
- HugePages 设置过小:PostgreSQL 可能无法启动(如果设置了
huge_pages = on) - 系统重启影响:确认
vm.nr_hugepages 配置在 /etc/sysctl.conf 中,系统重启后仍然生效
5. 确认兼容性
- 验证 PostgreSQL 版本的 HugePages 支持情况
9.3 回退计划
准备回退方案:
# 记录当前设置 grep huge_pages $PGDATA/postgresql.conf sysctl vm.nr_hugepages
-- 方法1:允许 PostgreSQL 在无 HugePages 时正常运行ALTERSYSTEMSET huge_pages = try;-- 方法2:完全禁用ALTERSYSTEMSET huge_pages = off;
然后重启 PostgreSQL。
# 临时禁用(重启后失效) sudo sysctl -w vm.nr_hugepages=0# 永久禁用(修改 /etc/sysctl.conf) sudo vi /etc/sysctl.conf# 注释或删除 vm.nr_hugepages 行 sudo sysctl -p
9.4 严重警告
切勿在未经充分测试的情况下直接在生产环境中应用本文配置。不恰当的 HugePages 配置可能导致:
务必在与生产环境高度相似的测试环境中验证所有更改。
