在现实应用中,常用的缺失值类型可分为完全随机缺失、随机缺失和非随机缺失。这个时候我们需要将缺失的数据给填补进来,尽量接近原始数据。常用的缺失值处理方法有:插补法、删除法、模型预测法、KNN等。
具体情况选择具体的方法,这里我们介绍插补法中的线性插值和多项式插值,先来了解下它的原理,再用Python来具体进行实操,理论联系实际,轻松掌握好插值的用法。
线性插值的本质是拉格朗日插值的特例,其基函数设为p:
因此,线性插值多项式可直接表示为:
这里也贴出拉格朗日插值法的公式如下:
在平面上有共n个点,现作一条函数f(x)使其图像经过这n个点。
设集合是关于点(x,y)的角标的集合,作n个多项式,。对于任意,都有
这个是拉格朗日基函数的定义,遍历所有“不等于k”的节点下标i(即 i=0,1,…,n但 i≠k),最终就可以得到拉格朗日插值多项式:
练习:我们来写一个当n=3时的表达式(0,1,2,3):
先将每个基函数给写出来:
那么插值多项式为:
接下来我们来实际操作,看如何用Python代码将缺失值给找回来:
from matplotlib import pyplot as pltimport pandas as pdimport numpy as np# 设置中文字体与负号显示plt.rcParams['font.sans-serif'] = ['SimHei']plt.rcParams['axes.unicode_minus'] = Falsedata = {'Time':[0,1,2,3,4,5,6,7,8,9], 'Value':[2.5,np.nan,np.nan,4.5,5.0,np.nan,6.5,7.0,np.nan,9.0]}df = pd.DataFrame(data)print(df)plt.plot(df['Time'], df['Value'], marker='o')plt.xlabel('时间')plt.ylabel('值')plt.title('原始数据')plt.show()
Time Value0 0 2.51 1 NaN2 2 NaN3 3 4.54 4 5.05 5 NaN6 6 6.57 7 7.08 8 NaN9 9 9.0
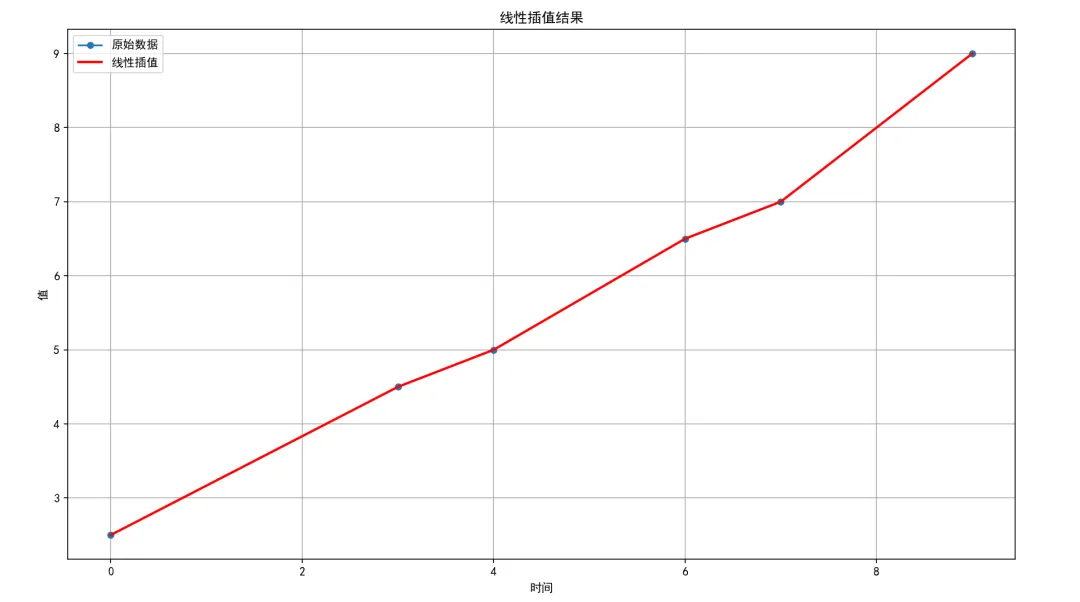
我们也可以通过绘图,更直观的来观察,都是一些离散的点和线段组成:df['Linear_Interpolation'] = df['Value'].interpolate(method='linear') # 线性插值plt.figure(figsize=(10,5))plt.plot(df['Time'], df['Value'], marker='o', label='原始数据',markersize=5) # 原始数据plt.plot(df['Time'], df['Linear_Interpolation'], 'r-', label='线性插值',linewidth=2) # 线性插值plt.xlabel('时间')plt.ylabel('值')plt.title('线性插值结果')plt.legend()plt.grid()plt.show()
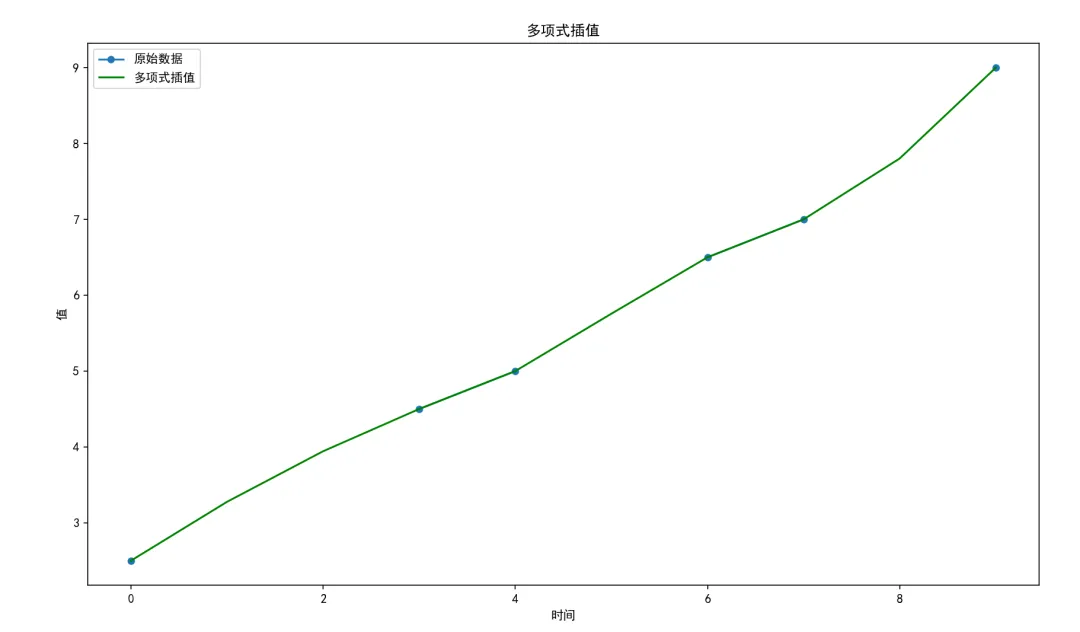
可以看到线性插值之后的绘图,填补了缺失的数值。使用了pandas库中的interpolate方法对缺失值进行线性插补。这种方法通过计算相邻已知值之间的线性关系来估算缺失值。多项式插值通过拟合高阶多项式来估计缺失值,可以通过拉格朗日插值法或者牛顿插值法等方法构建,valid_data = df.dropna(subset=['Value']) # 删除缺失值poly_interpolator = interp1d(valid_data['Time'], valid_data['Value'], kind='quadratic', fill_value='extrapolate')df['Poly_Interpolation'] = poly_interpolator(df['Time']) # 二次插值plt.plot(df['Time'], df['Poly_Interpolation'], 'g-', label='多项式插值',markersize=5)plt.legend()plt.xlabel('时间')plt.ylabel('值')plt.title('多项式插值')plt.show()
我们使用了scipy中的一维插值函数interp1d,这个函数需要输入的数据不能包含NaN值,因为:插值计算需要基于已知的有效数据点NaN值会导致多项式拟合失败,二次插值需要连续的有效数据点来计算曲线,所以在此之前我们先要做删除缺失值的处理:valid_data = df.dropna(subset=['Value']) # 删除缺失值
Time Value Linear_Interpolation0 0 2.5 2.53 3 4.5 4.54 4 5.0 5.06 6 6.5 6.57 7 7.0 7.09 9 9.0 9.0
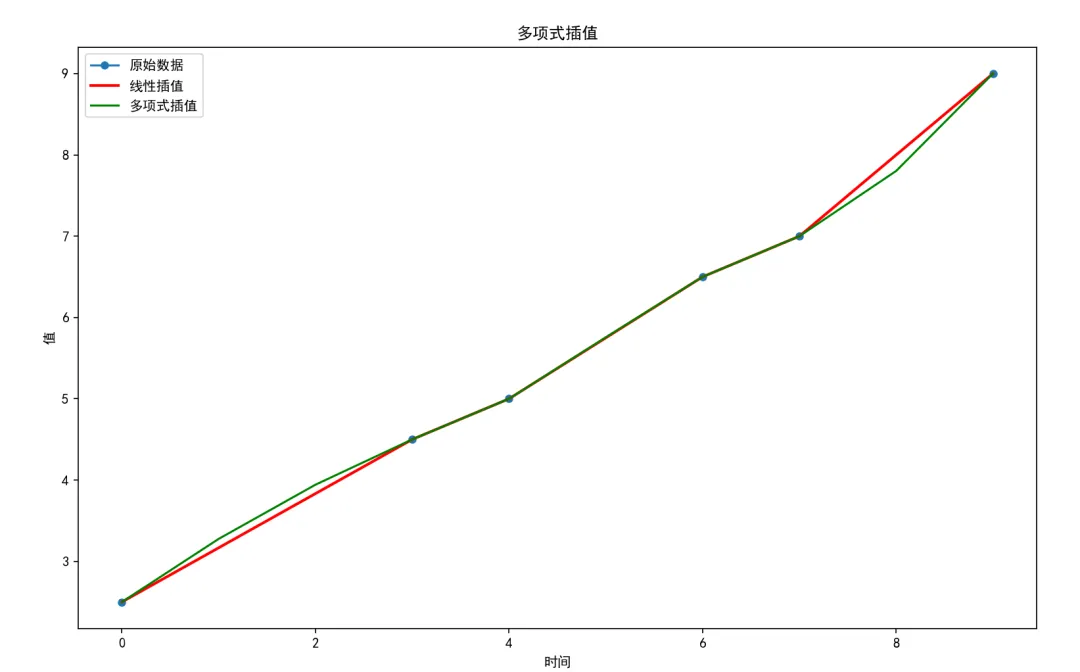
这个也属于数据预处理的重要步骤,于是我们就对已知的数据点创建了一个二次函数。其中参数kind='quadratic':表示使用二次多项式进行插值参数fill_value='extrapolate':允许在数据范围外进行外推预测当然我们也可以打印出线性插值和多项式插值的数据,以及将它们都生成在一张图上,可以对比两者插值产生的效果: Time Value Linear_Interpolation Poly_Interpolation0 0 2.5 2.500000 2.5000001 1 NaN 3.166667 3.2761392 2 NaN 3.833333 3.9428053 3 4.5 4.500000 4.5000004 4 5.0 5.000000 5.0000005 5 NaN 5.750000 5.7564686 6 6.5 6.500000 6.5000007 7 7.0 7.000000 7.0000008 8 NaN 8.000000 7.8029729 9 9.0 9.000000 9.000000
核心还是用到了导数,也就是说我们构建多项式,通过需要考虑函数的变化率(即导数),以便更好地拟合数据,可以借助微积分评估多项式的光滑性和斜率,从而判断插值函数的准确性和稳定性。更多精彩,推荐阅读《人工智能微积分基础》,微积分和代码一起掌握,是一本不可多得的入门到进阶的佳作人工智能的快速发展,关键是对数学的掌握,尤其是从事AI这个领域的,以及想要通过代码进一步深刻理解数学的朋友们,这套人工智能数学系列推荐一起购买。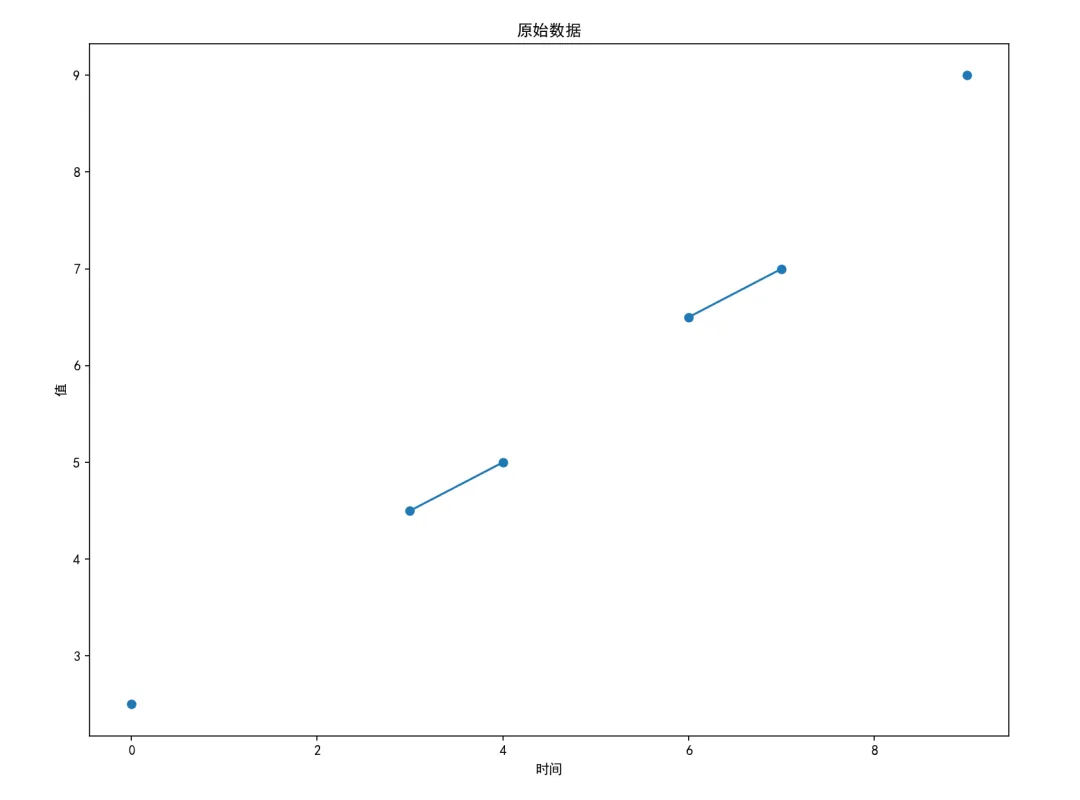
 10个月宝宝每天需要喝多少奶粉?