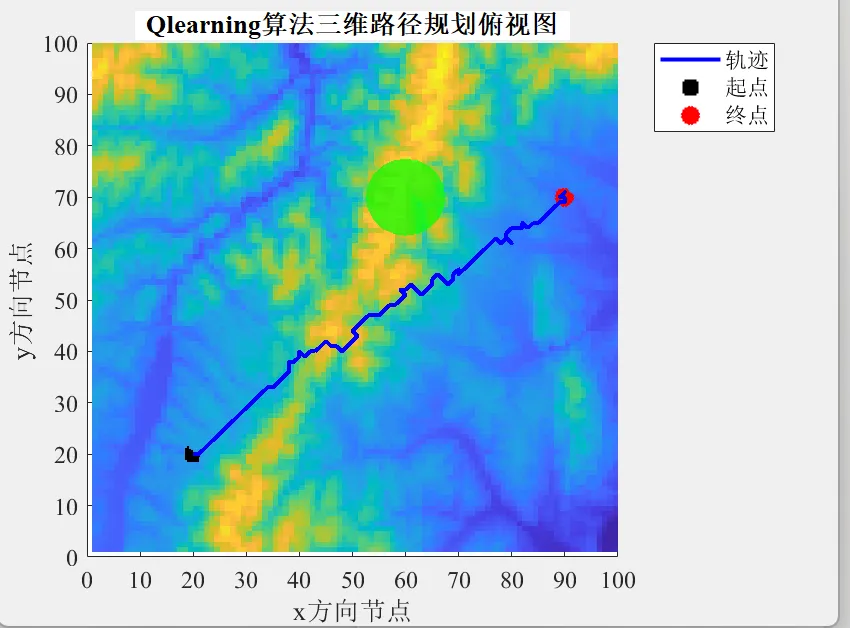
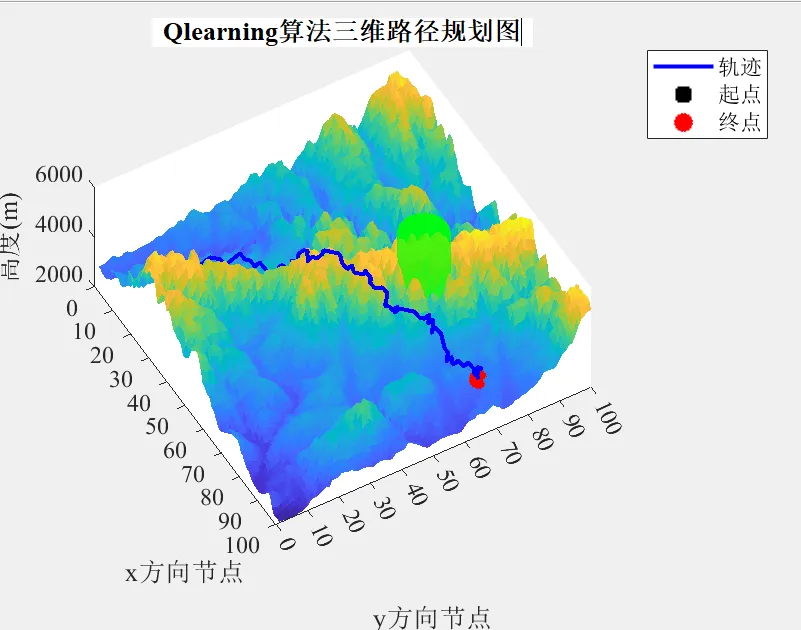
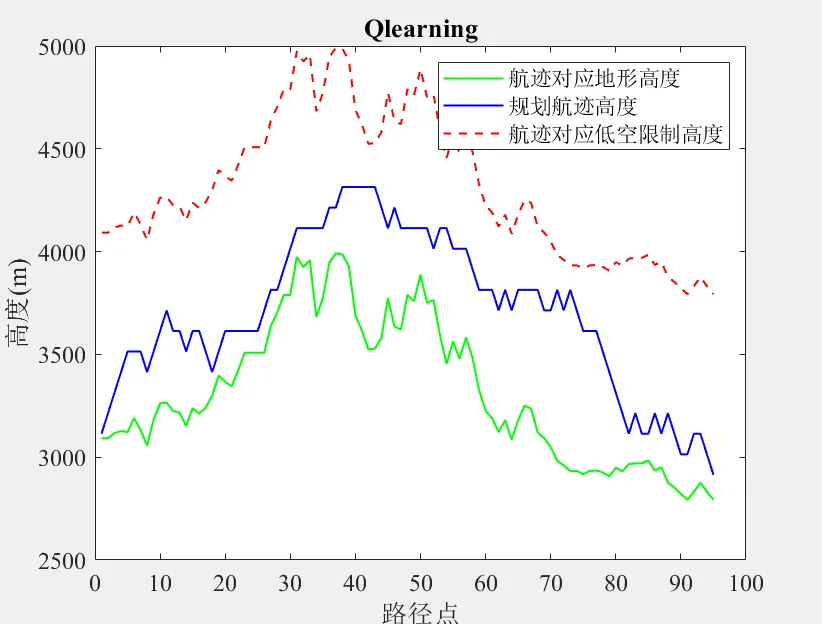
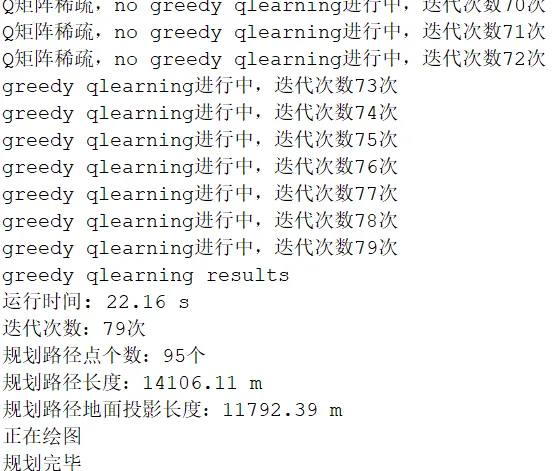
%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%% Qlearning路径规划算法主函数%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%clcclear all;close all;begintime = tic;fprintf('程序运行中,请稍后\n');load ('MapData.mat');% 返回的arena数据结构有六个参数,分别是MAX_X,MAX_Y,MAX_Z,arena_m,src,desarena = importArena(MAP, MAX_X, MAX_Y, MAX_Z);alpha = 0.9;gamma = 0.7;goalstateind = sub2ind(size(arena.arena_m), arena.des(1), arena.des(2), arena.des(3));[Q, docroutelength, qwaypoints, times, maplength, qnumber] = learnQMatrix(arena, alpha, gamma, solar3dim, Display_Data);figure(4)a = docroutelength(:, 1);b = docroutelength(:, 2);plot(a, b, '-');save('qMatrix.mat', 'Q');%load('qMatrix');figure(5)a = qnumber(:, 1);b = qnumber(:, 2);plot(a, b, '-');runtime=toc(begintime);fprintf('greedy qlearning results\n');fprintf('运行时间: %.2f s\n', runtime);fprintf('迭代次数:%d次\n',times);fprintf('规划路径点个数:%d个\n', size(qwaypoints, 1));fprintf('规划路径长度:%.2f m\n', 100*docroutelength(times-1, 2));fprintf('规划路径地面投影长度:%.2f m\n', maplength*100);% 作图fprintf('正在绘图\n');angle = {[0,90],[60,70]};ttl = {'Qlearning算法三维路径规划俯视图','Qlearning算法三维路径规划图'};for i = 1:2 figure(i) axis([1 MAX_X 1 MAX_Y 1 MAX_Z]); % 设置坐标轴范围为1到MAX_X,1到MAX_Y,1到MAX_Z plot3(qwaypoints(:,1),qwaypoints(:,2),qwaypoints(:,3),'b','linewidth',2); hold on plot3(20,20,7,'+k','LineWidth',8); hold on plot3(90,70,5,'*r','LineWidth',8); hold on legend(['\fontname{宋体}轨迹'],['\fontname{宋体}起点'],['\fontname{宋体}终点']); legend('AutoUpdate','off'); surf(Display_Data(1:100,1:100)','linestyle','none'); % 创建一个曲面图,并将 Z 中元素的列索引和行索引用作 x 坐标和 y 坐标 set(gca,'xticklabel',{'0','10','20','30','40','50','60','70','80','90','100'}); set(gca,'yticklabel',{'0','10','20','30','40','50','60','70','80','90','100'}); set(gca,'zticklabel',{'2000','4000','6000','4000','5000','6000','7000','8000','9000','10000'}); xlabel(['\fontname{Times new roman}x\fontname{宋体}方向节点']); ylabel(['\fontname{Times new roman}y\fontname{宋体}方向节点']); zlabel(['\fontname{宋体}高度\fontname{Times new roman}(m)']); set(gca,'fontsize',12,'fontname','Times new roman'); %%%%%%%%%%%%%%%%绘制异常天气区,绿色为异常天气区 figure(i) [a,z]=ndgrid((0:.05:1)*2*pi,0:.05:20); x=7.5*cos(a)+60; y=7.5*sin(a)+70; surf(x,y,z,x*0,'linestyle','none','Facealpha',0.7,'FaceColor','g') hold on % 对异常区域封顶 [a,r]=ndgrid((0:.05:1)*2*pi,[0 1]); x=7.5*cos(a).*r+60; y=7.5*sin(a).*r+70; surf(x,y,x*0,x*0,'linestyle','none','Facealpha',0.7,'FaceColor','g') surf(x,y,x*0+20,x*0,'linestyle','none','Facealpha',0.7,'FaceColor','g') hold off grid on set(gca, 'XTick', 0:10:100); set(gca, 'YTick', 0:10:100); set(gca, 'GridLineStyle', 'none'); set(gca, 'GridAlpha', 0); view(angle{i}); title(ttl{i},'FontSize',13,'FontWeight', 'bold');end% 证明轨迹符合低空要求及地形要求% 注意map中的50是地形最低点起之上的50Terrain_Data = Final_Data(301:400,101:200);num = size(qwaypoints, 1);figset = [];MIN_Final_Data = min(min(Final_Data(301:400,101:200)));for i = 1:num figset(i, 1) = i; figset(i, 2) = Terrain_Data(qwaypoints(i, 1), qwaypoints(i, 2)); figset(i, 3) = qwaypoints(i, 3) * 100 + MIN_Final_Data; figset(i, 4) = Terrain_Data(qwaypoints(i, 1), qwaypoints(i, 2)) + 1000;endfigure(3)h1 = plot(figset(:, 1), figset(:, 2), '-g', 'linewidth',1);hold onh2 = plot(figset(:, 1), figset(:, 3), '-b', 'linewidth',1);hold onh3 = plot(figset(:, 1), figset(:, 4), '--r','linewidth',1);set(gca,'xtick',0:10:110)legend(['\fontname{宋体}航迹对应地形高度'],['\fontname{宋体}规划航迹高度'],['\fontname{宋体}航迹对应低空限制高度']);legend('AutoUpdate','off');title('Qlearning','FontSize',13,'FontWeight', 'bold');xlabel(['\fontname{宋体}路径点']);ylabel(['\fontname{宋体}高度\fontname{Times new roman}(m)']);set(gca,'fontsize',12,'fontname','Times new roman');hold offfprintf('规划完毕\n');function nextsub = qind2sub(nextState, currState)% 给出27个nextState中选出的一个,以及当前状态的sub,返回对应变化的m,j,k以及对应sub[m, j, k] = ind2sub([3 3 3], nextState);m = m - 2;j = j - 2;k = k - 2;nextsub = currState + 100*100*k + 100* j + m;endfunction [Q, routelength] = noyip(arena, alpha, gamma, solar3dim, Q, Display_Data)[arSizeR, arSizeC, arSizeZ] = size(arena.arena_m);alreadyacc = zeros(arSizeR*arSizeC*arSizeZ, 1);currstatesub = [arena.src(1), arena.src(2), arena.src(3)];qwaypoints = [arena.src(1), arena.src(2), arena.src(3)];while true currstateind = sub2ind([arSizeR arSizeC arSizeZ], currstatesub(1), currstatesub(2), currstatesub(3)); [a, b, c] = ind2sub([arSizeR arSizeC arSizeZ], currstateind); neighbor = []; for i = -1:1:1 for j = -1:1:1 for k = -1:1:1 neighbor(size(neighbor, 1)+1, :) = [a+i, b+j, c+k]; end end end % 检查有无元素溢出规定矩阵 outRangetest = []; for i = 1:size(neighbor, 1) outRangetest(i) = (neighbor(i,1)<1) || (neighbor(i,1)>100) || (neighbor(i,2)<1) || (neighbor(i,2)>100) || (neighbor(i,3)<1) || (neighbor(i,3)>10+Display_Data(neighbor(i,1), neighbor(i,2))); end locate = find(outRangetest>0); neighbor(locate,:)=[]; % 判断地形是否不可达 terr = []; for i = 1:size(neighbor, 1) terr(i) = arena.arena_m(neighbor(i, 1), neighbor(i, 2), neighbor(i, 3)); end locate = find(terr == -1); neighbor(locate,:)=[]; % 不走重复点 alreadyacc(currstateind, 1)=1; %判断是否走了重复点 neighborIndex = sub2ind([arSizeR arSizeC arSizeZ],neighbor(:,1),neighbor(:,2),neighbor(:,3)); locate = find(alreadyacc(neighborIndex(:, 1), 1) == 1); neighbor(locate,:)=[]; % 进入死胡同的处理 if isempty(neighbor)==1%走入死胡同退出 alreadyacc=zeros(arSizeR*arSizeC*arSizeZ, 1); routelength = 0; break; end % R值的计算 for x=1:size(neighbor, 1) distancelast = sqrt((a-arena.des(1))^2 + (b-arena.des(2))^2 + (c-arena.des(3))^2); distancenext = sqrt((neighbor(x,1)-arena.des(1))^2 + (neighbor(x,2)-arena.des(2))^2 + (neighbor(x,3)-arena.des(3))^2); detah = abs(neighbor(x, 3) - c); %distancebetween = sqrt((neighbor(x,1)-a)^2 + (neighbor(x,2)-b)^2 + (neighbor(x,3)-c)^2); R(x)=solar3dim(neighbor(x,1), neighbor(x,2), neighbor(x,3)) + 15*(distancelast - distancenext) - 5*detah; % R是获得的能量减去这一步的成本 if neighbor(x, 1)==arena.des(1) && neighbor(x,2)==arena.des(2) && neighbor(x,3)==arena.des(3) R(x)=150; end end % 随机选择下一个状态 randnum = randi(size(neighbor, 1)); nextstatesub = neighbor(randnum, :); qwaypoints(size(qwaypoints, 1)+1, :) = [nextstatesub(1),nextstatesub(2),nextstatesub(3)]; nextstateind = sub2ind([arSizeR arSizeC arSizeZ],nextstatesub(1),nextstatesub(2),nextstatesub(3)); r = R(randnum); % 找出下一个状态的相应action x = nextstatesub(1) - a; y = nextstatesub(2) - b; z = nextstatesub(3) - c; actionind = sub2ind([3 3 3], x+2, y+2, z+2); % 更新Q表 maxQ=max(Q(nextstateind, :)); Q(currstateind, actionind)=Q(currstateind, actionind)+alpha*(r+gamma*maxQ-Q(currstateind, actionind)); currstatesub = nextstatesub; R=[]; if currstatesub(1)==arena.des(1) && currstatesub(2)==arena.des(2) && currstatesub(3)==arena.des(3) alreadyacc=zeros(arSizeR*arSizeC*arSizeZ, 1); routelength = 0; for i = 1:size(qwaypoints, 1)-1 routelength = routelength + sqrt((qwaypoints(i+1,1)-qwaypoints(i,1))^2 + (qwaypoints(i+1,2)-qwaypoints(i,2))^2 + (qwaypoints(i+1,3)-qwaypoints(i,3))^2); end break; endendendfunction [Q, docroutelength, returnpoints, times, maplength, qnumber] = learnQMatrix(arena, alpha, gamma, solar3dim, Display_Data)[arSizeR, arSizeC, arSizeZ] = size(arena.arena_m);Q = zeros(arSizeR*arSizeC*arSizeZ, 27);times = 0;docroutelength = [];qnumber = [];while true times = times + 1; if length(find(Q~=0)) < 500000 fprintf('Q矩阵稀疏,no greedy qlearning进行中,迭代次数%d次\n', times); [Q, routelength] = noyip(arena, alpha, gamma, solar3dim, Q, Display_Data); qnumber(size(qnumber,1)+1, :) = [times, length(find(Q~=0))]; else fprintf('greedy qlearning进行中,迭代次数%d次\n', times) yip = 0.9; [qwaypoints, routelength] = haveyip(yip, arena, alpha, gamma, solar3dim, Q, Display_Data); if routelength~=0 && size(qwaypoints, 1) <100 && abs(routelength - docroutelength(size(docroutelength, 1), 2)) < 5 yip = 1; [qwaypoints, routelength] = haveyip(yip, arena, alpha, gamma, solar3dim, Q, Display_Data); returnpoints = qwaypoints; maplength = 0; for i = 1:size(qwaypoints, 1)-1 maplength = maplength + sqrt((qwaypoints(i+1,1)-qwaypoints(i,1))^2 + (qwaypoints(i+1,2)-qwaypoints(i,2))^2); end break; end end docroutelength(size(docroutelength, 1)+1, :) = [times, routelength];endendfunction arena = importArena(map, MAX_X, MAX_Y, MAX_Z)% arena数据结构有六个参数,分别是MAX_X,MAX_Y,MAX_Z,arena_m,src,des% 意义分别是活动区域范围x,y,z,地图标记矩阵,起点所在位置,终点所在位置arena.MAX_X = MAX_X;arena.MAX_Y = MAX_Y;arena.MAX_Z = MAX_Z;arena.arena_m = map; arena.src = [20, 20, 7];arena.des = [90, 70, 5];endfunction [qwaypoints, routelength] = haveyip(yip, arena, alpha, gamma, solar3dim, Q, Display_Data)[arSizeR, arSizeC, arSizeZ] = size(arena.arena_m);alreadyacc = zeros(arSizeR*arSizeC*arSizeZ, 1);currstatesub = [arena.src(1), arena.src(2), arena.src(3)];qwaypoints = [arena.src(1), arena.src(2), arena.src(3)];while true currstateind = sub2ind([arSizeR arSizeC arSizeZ], currstatesub(1), currstatesub(2), currstatesub(3)); [a, b, c] = ind2sub([arSizeR arSizeC arSizeZ], currstateind); neighbor = []; for i = -1:1:1 for j = -1:1:1 for k = -1:1:1 neighbor(size(neighbor, 1)+1, :) = [a+i, b+j, c+k]; end end end % 检查有无元素溢出规定矩阵 outRangetest = []; for i = 1:size(neighbor, 1) outRangetest(i) = (neighbor(i,1)<1) || (neighbor(i,1)>100) || (neighbor(i,2)<1) || (neighbor(i,2)>100) || (neighbor(i,3)<1) || (neighbor(i,3)>10+Display_Data(neighbor(i,1), neighbor(i,2))); end locate = find(outRangetest>0); neighbor(locate,:)=[]; % 判断地形是否不可达 terr = []; for i = 1:size(neighbor, 1) terr(i) = arena.arena_m(neighbor(i, 1), neighbor(i, 2), neighbor(i, 3)); end locate = find(terr == -1); neighbor(locate,:)=[]; % 不走重复点 alreadyacc(currstateind, 1)=1; %distance标志位判断是否走了重复点 neighborIndex = sub2ind([arSizeR arSizeC arSizeZ],neighbor(:,1),neighbor(:,2),neighbor(:,3)); locate = find(alreadyacc(neighborIndex(:, 1), 1) == 1); neighbor(locate,:)=[]; % 进入死胡同的处理 if isempty(neighbor)==1%走入死胡同退出 alreadyacc=zeros(arSizeR*arSizeC*arSizeZ, 1); routelength = 0; break; end % R值的计算 for x=1:size(neighbor, 1) distancelast = sqrt((a-arena.des(1))^2 + (b-arena.des(2))^2 + (c-arena.des(3))^2); distancenext = sqrt((neighbor(x,1)-arena.des(1))^2 + (neighbor(x,2)-arena.des(2))^2 + (neighbor(x,3)-arena.des(3))^2); detah = abs(neighbor(x, 3) - c); %distancebetween = sqrt((neighbor(x,1)-a)^2 + (neighbor(x,2)-b)^2 + (neighbor(x,3)-c)^2); R(x)=solar3dim(neighbor(x,1), neighbor(x,2), neighbor(x,3)) + 15*(distancelast- distancenext) - 5*detah; % R是获得的能量减去这一步的成本 if neighbor(x, 1)==arena.des(1) && neighbor(x,2)==arena.des(2) && neighbor(x,3)==arena.des(3) R(x)=150; end end % 按照greedy选择下一状态 if rand < yip nextstateset = find(Q(currstateind, :) == max(Q(currstateind, :))); % 这里是否应该使用向量的第一个值 nextstate = nextstateset(randi(size(nextstateset,2))); nextstateind = qind2sub(nextstate, currstateind); [nxtR, nxtC, nxtZ] = ind2sub(size(arena.arena_m), nextstateind); x = nxtR - a; y = nxtC - b; z = nxtZ - c; while(arena.arena_m(nxtR, nxtC, nxtZ) == -1 || nextstateind < 1 || nextstateind > 500000 || nxtZ>10+Display_Data(nxtR, nxtC) || x+2>3 ||x+2<1 ||y+2>3 ||y+2<1 ||z+2>3 ||z+2<1) num = randi(size(nextstateset,2)); nextstate = nextstateset(num); nextstateind = qind2sub(nextstate, currstateind); [nxtR, nxtC, nxtZ] = ind2sub(size(arena.arena_m), nextstateind); x = nxtR - a; y = nxtC - b; z = nxtZ - c; nextstateset(num) = []; if size(nextstateset, 2)==0 && (arena.arena_m(nxtR, nxtC, nxtZ)==-1 || nextstateind < 1 || nextstateind > 500000 || nxtZ>10+Display_Data(nxtR, nxtC) || x+2>3 ||x+2<1 ||y+2>3 ||y+2<1 ||z+2>3 ||z+2<1) break; end end if size(nextstateset, 2)==0 && (arena.arena_m(nxtR, nxtC, nxtZ)==-1 || nextstateind < 1 || nextstateind > 500000 || nxtZ>10+Display_Data(nxtR, nxtC) || x+2>3 ||x+2<1 ||y+2>3 ||y+2<1 ||z+2>3 ||z+2<1) routelength = 0; break; end actionind = sub2ind([3 3 3], x+2, y+2, z+2); Q(currstateind, actionind) = -inf; qwaypoints(size(qwaypoints, 1)+1,:) = [nxtR, nxtC, nxtZ]; currstatesub = [nxtR, nxtC, nxtZ]; R = []; else % 随机选择下一个状态 randnum = randi(size(neighbor, 1)); nextstatesub = neighbor(randnum, :); qwaypoints(size(qwaypoints, 1)+1, :) = [nextstatesub(1),nextstatesub(2),nextstatesub(3)]; nextstateind = sub2ind([arSizeR arSizeC arSizeZ],nextstatesub(1),nextstatesub(2),nextstatesub(3)); r = R(randnum); % 找出下一个状态的相应action x = nextstatesub(1) - a; y = nextstatesub(2) - b; z = nextstatesub(3) - c; actionind = sub2ind([3 3 3], x+2, y+2, z+2); % 更新Q表 maxQ=max(Q(nextstateind, :)); Q(currstateind, actionind)=Q(currstateind, actionind)+alpha*(r+gamma*maxQ-Q(currstateind, actionind)); currstatesub = nextstatesub; R=[]; end if currstatesub(1)==arena.des(1) && currstatesub(2)==arena.des(2) && currstatesub(3)==arena.des(3) alreadyacc=zeros(arSizeR*arSizeC*arSizeZ, 1); routelength = 0; for i = 1:size(qwaypoints, 1)-1 routelength = routelength + sqrt((qwaypoints(i+1,1)-qwaypoints(i,1))^2 + (qwaypoints(i+1,2)-qwaypoints(i,2))^2 + (qwaypoints(i+1,3)-qwaypoints(i,3))^2); end break; endendend
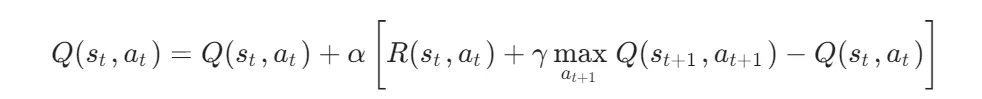
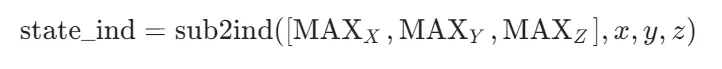
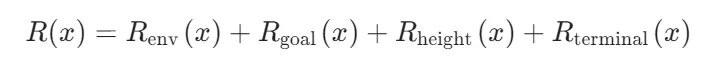
 10个月宝宝每天需要喝多少奶粉?