简介
GHCN(Global Historical Climatology Network,全球历史气候网络)是由美国国家海洋和大气管理局(NOAA)维护的全球历史气候数据集合, 提供全球超过 10 万个气象站点的气象数据,时间范围从18世纪起至当前,部分站点记录超过175年,覆盖全球,但北美、欧洲、澳大利亚的数据密度更高。 本文介绍如何批量下载GHCN月降水数据并绘图!
代码
下载数据
"""批量下载 GHCN-M v4 月降水 csv(一个站点一个文件)"""import osimport sysimport timeimport requestsfrom concurrent.futures import ThreadPoolExecutor, as_completedfrom urllib.parse import urljoinfrom bs4 import BeautifulSoup# ----------- 用户可调参数 -------------BASE_URL = "https://www.ncei.noaa.gov/data/ghcnm/v4/precipitation/access/"SAVE_DIR = r"D:\GHCN-monthly"# 本地保存目录THREADS = 8 # 并发线程数RETRY = 3 # 单文件失败重试次数TIMEOUT = 30 # 单次请求超时(秒)# -------------------------------------os.makedirs(SAVE_DIR, exist_ok=True)def get_csv_links():"""抓取目录页,返回所有 csv 下载链接(相对路径)"""print("正在获取文件列表 …") try: resp = requests.get(BASE_URL, timeout=TIMEOUT) resp.raise_for_status() except requests.RequestException as e:print("无法访问目录页:", e) sys.exit(1) soup = BeautifulSoup(resp.text, "html.parser") links = [a.get("href") for a in soup.select('a[href$=".csv"]')]print(f"共发现 {len(links)} 个 csv 文件")return linksdef download_one(fname):"""下载单个文件,支持断点续传""" local_path = os.path.join(SAVE_DIR, fname) url = urljoin(BASE_URL, fname)# 如果本地已存在且大小 >0 则跳过if os.path.isfile(local_path) and os.path.getsize(local_path) > 0:return f"SKIP {fname}"for attempt in range(1, RETRY + 1): try:# 流式下载,防止大文件占用内存 with requests.get(url, stream=True, timeout=TIMEOUT) as r: r.raise_for_status() with open(local_path, "wb") as f:for chunk in r.iter_content(chunk_size=1024 * 64):if chunk: f.write(chunk)return f"OK {fname}" except Exception as e:if attempt == RETRY:return f"FAIL {fname} after {RETRY} retries: {e}" time.sleep(2)def main(): links = get_csv_links() total = len(links)done = 0 fail = 0 with ThreadPoolExecutor(max_workers=THREADS) as pool: future_map = {pool.submit(download_one, f): f for f in links}for fut in as_completed(future_map):done += 1 msg = fut.result()if msg.startswith("FAIL"): fail += 1# 简单进度条print(f"[{done:>5}/{total}] {msg}")print("\n全部完成!")if fail:print(f"警告:{fail} 个文件下载失败,可重新运行脚本进行补下。")if __name__ == "__main__": main()
绘制全球降水分布
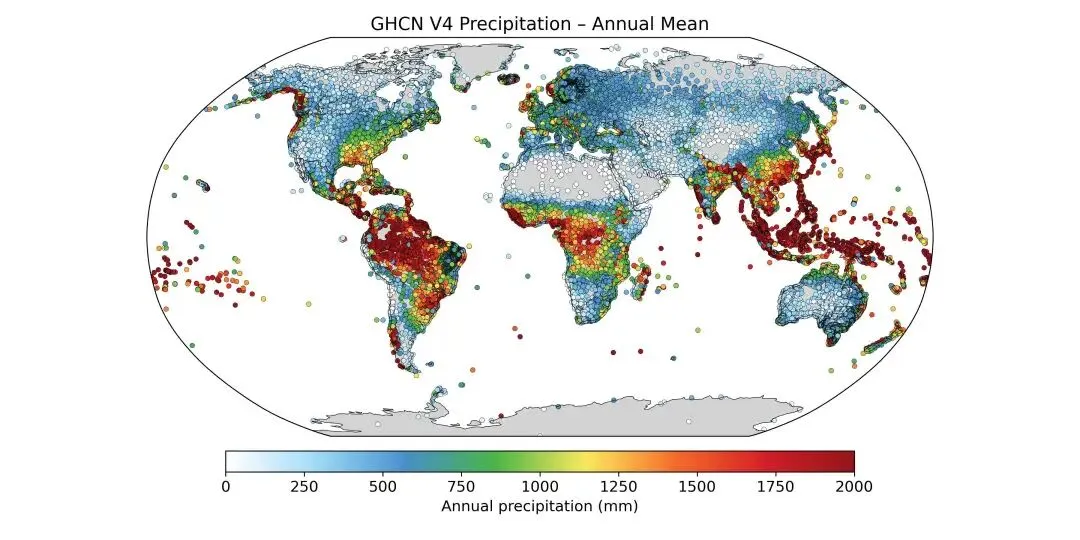
"""批量读取 GHCN 逐月降水 CSV, 计算年平均降水, 画全球填色地图"""import os, glob, sysimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport cartopy.crs as ccrsimport cartopy.feature as cfeaturefrom pathlib import Pathimport cmaps# ---------------- 用户参数 -----------------ROOT_DIR = r"D:\GHCN-monthly"# OUT_CSV = "stations_ann_precip.csv"OUT_FIG = "GHCN_ann_precip_global.png"DPI = 300# ------------------------------------------def parse_one_csv(fpath):""" 读取 GHCN 固定宽度 csv,返回 {'lat':float, 'lon':float, 'ann_precip':float} 列位置完全按官方 readme: 1-11 ID 13-52 Name 54-62 Lat 64-73 Lon 75-82 Elev 84-89 yearmonth 91-96 precip(0.1mm) """# 固定宽度列起止位置 colspecs = [(0,11), (12,52), (53,62), (63,73), (74,82), (83,89), (90,96)] names = ['ID','Name','Lat','Lon','Elev','YearMon','Precip'] try: df = pd.read_fwf(fpath, colspecs=colspecs, names=names, dtype={'Lat':float,'Lon':float,'Elev':float,'YearMon':int,'Precip':float}) except Exception as e:print("读取失败:", fpath, e)return Noneif df.shape[0] < 12:return None lat, lon = df.loc[0, 'Lat'], df.loc[0, 'Lon']if pd.isna(lat) or pd.isna(lon):return None# 转成年降水 df['Year'] = df['YearMon'] // 100 df['Precip_mm'] = df['Precip'] * 0.1 # 0.1mm → mm# 跳过缺测值(-1) df.loc[df['Precip'] < 0, 'Precip_mm'] = np.nan annual = df.groupby('Year')['Precip_mm'].sum().mean()return {'lat': lat, 'lon': lon, 'ann_precip': annual}def collect_all_stations(root):"""递归扫描所有csv""" pattern = os.path.join(root, "**/*.csv") files = glob.glob(pattern, recursive=True)print(f"共发现 {len(files)} 个CSV文件") records = []for f in files: res = parse_one_csv(f)if res: records.append(res)print(f"有效站点数: {len(records)}")return pd.DataFrame(records)def draw_global_map(df): plt.rcParams["font.size"] = 12 fig = plt.figure(figsize=(12, 6)) ax = plt.axes(projection=ccrs.Robinson()) ax.set_global() ax.coastlines(lw=0.4) ax.add_feature(cfeature.LAND, facecolor="lightgray") ax.add_feature(cfeature.OCEAN, facecolor="white") cmap = cmaps.WhiteBlueGreenYellowRed sc = ax.scatter(df["lon"], df["lat"], c=df["ann_precip"], s=15, cmap=cmap, transform=ccrs.PlateCarree(), edgecolors="k", linewidths=0.2,vmin=0, vmax=2000) cb = plt.colorbar(sc, ax=ax, orientation="horizontal", pad=0.03, shrink=0.6, aspect=30) cb.set_label("Annual precipitation (mm)") ax.set_title("GHCN V4 Precipitation – Annual Mean") plt.tight_layout() plt.savefig(OUT_FIG, dpi=DPI)def main():if not os.path.isdir(ROOT_DIR):print("目录不存在:", ROOT_DIR) sys.exit(1) df = collect_all_stations(ROOT_DIR)if df.empty:print("未读到任何有效站点!") sys.exit(1)df.to_csv(OUT_CSV, index=False, float_format="%.2f") draw_global_map(df)if __name__ == "__main__": main()
结果
数据下载链接
https://www.ncei.noaa.gov/products/land-based-station/global-historical-climatology-network-monthly
