组合小而专的智能体开发工具库,也许是替换复杂抽象智能体框架的另一种选择:LiteLLM 负责模型调用,Instructor 负责结构化输出,Tenacity 负责重试。
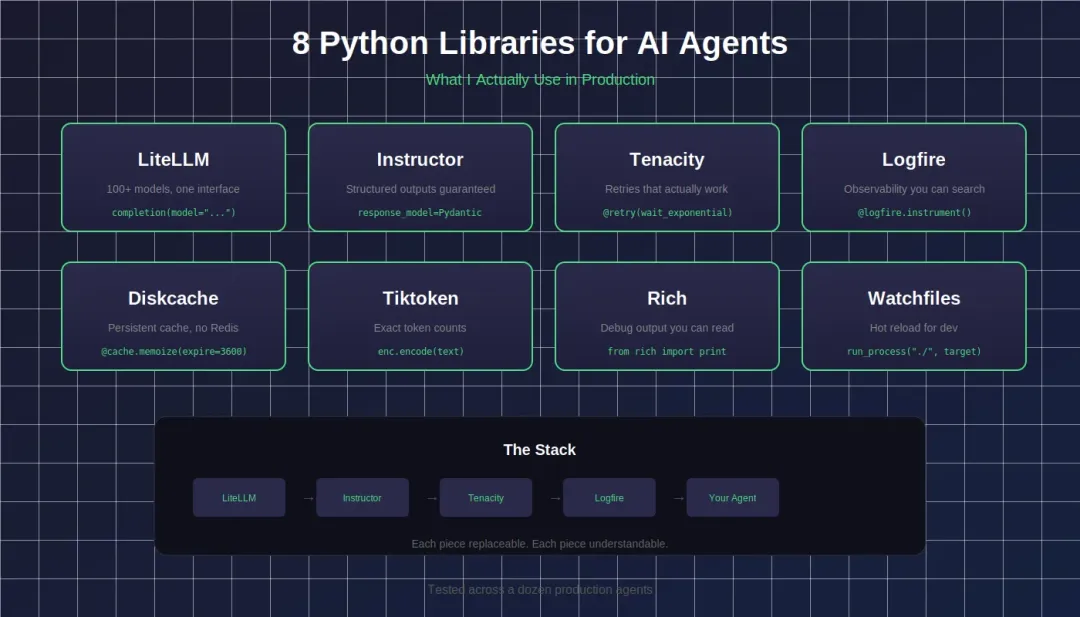 AI Agent 开发8个实用的 Python 包
- LiteLLM —— 因为供应商锁定是给冤大头准备的
你的智能体现在用的是 GPT-4。接着你想测试 Claude。恭喜,你要重写一整层 API 了。
from litellm import completionresponse = completion(model="gpt-4", messages=[{"role": "user", "content": "Hello"}])response = completion(model="claude-3-opus-20240229", messages=[{"role": "user", "content": "Hello"}])response = completion(model="ollama/llama2", messages=[{"role": "user", "content": "Hello"}])
一个接口。100+ 模型。只改一个字符串就能切换供应商。
我在上个季度做过一次成本对比:同样的工作负载,GPT-4 vs Claude Sonnet vs Llama 3 70B,差额是每月 847 美元。要是没有 LiteLLM,光是测试这些就得花一周时间重构代码。
✔️ 适用场景:多模型测试、供应商兜底切换、成本优化
💁♂️ 小技巧:配置自动兜底。当 OpenAI 挂掉的时候,你的智能体会自动切换到 Anthropic,而你甚至不用被吵醒。
- Instructor —— 因为 LLM 会在 JSON 上撒谎
你要 JSON。结果它给你带 markdown 反引号的 JSON。或者多出字段。或者看起来像 JSON 但其实不是。
import instructorfrom pydantic import BaseModelfrom openai import OpenAIclient = instructor.from_openai(OpenAI())classUserInfo(BaseModel): name: str age: intuser = client.chat.completions.create( model="gpt-4", messages=[{"role": "user", "content": "Extract: John is 25 years old"}], response_model=UserInfo)
保证输出合法。如果抽取失败,Instructor 会告诉模型哪里错了,并自动重试。
在使用 Instructor 之前,我有一个 150 行的 parse_llm_json() 函数,处理了 12 种边界情况,但在生产环境里还是平均一周挂一次。现在?四个月零解析错误。
✔️ 适用场景:任何结构化抽取、工具调用解析、数据流水线
💡 洞察:和 Pydantic AI 搭配得天衣无缝。理念相同,层级不同。
- Tenacity —— 因为 API 会在凌晨 3 点背叛你
API 会失败。网络会超时。会撞限流。你的智能体会崩,然后你被愤怒的 Slack 消息叫醒。
from tenacity import retry, stop_after_attempt, wait_exponential@retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, min=4, max=10))defcall_flaky_api():return external_service.get_data()
指数退避、抖动、自定义重试条件。包一层函数,瞬态错误直接忘掉。
我以前写过四层嵌套的 try-except,还是漏掉边界情况。有个周日早上,一个第三方 API 连续 20 分钟返回 503,我收到了 47 条 Slack 报警,因为我那套“健壮”的错误处理只是记录日志然后继续。
✔️ 适用场景:每一个外部 API 调用。每一个。
⚠️ 警告:不要对 4xx 错误重试。你只会更快被限流。
- Logfire —— 因为“Processing Complete”不叫调试
你的智能体干了点怪事。日志里只写着“Processing complete”。你完全不知道从输入到输出中间发生了什么。
import logfirelogfire.configure()@logfire.instrument("process_user_request")defhandle_request(user_input: str): logfire.info("Received input", input=user_input) result = agent.run(user_input) logfire.info("Agent complete", result=result, tokens_used=result.tokens)return result
结构化、可搜索的可观测性。你可以清楚看到智能体做了什么、LLM 返回了什么、以及哪里出了问题。
上个月我花了 3 个小时排查一个智能体为什么总是推荐错误的产品。最后发现是检索步骤返回了过期数据。有了真正的可观测性,5 分钟就能定位。Logfire 解决了这个问题。
✔️ 适用场景:生产环境调试、Token 追踪、延迟监控
💁♂️ 小技巧:可与 Pydantic 集成。结构化数据会自动带完整类型信息写入日志。
- Diskcache —— 因为不是所有东西都需要 Redis
你的智能体不断用相同输入调用同一个 API。你在白白烧钱,还增加了延迟。
from diskcache import Cachecache = Cache('./agent_cache')@cache.memoize(expire=3600)defexpensive_embedding(text: str):return openai.embeddings.create(input=text, model="text-embedding-3-small")
持久化、基于文件的缓存。重启不丢。支持并发访问。不用维护 Redis 服务器。
我把 Diskcache 加进了一个每天调用 1 万多次的 embedding 流水线,很多请求都是重复的。第一周 API 成本直接降了 34%。早该这么干。
✔️ 适用场景:Embedding 缓存、API 响应缓存、高成本计算的记忆化
💡 洞察:多个智能体进程可以安全共享同一个缓存,不会损坏。我是用惨痛经验验证的。
- Tiktoken —— 因为猜 Token 数量是生产事故的起点
你的智能体不停往上下文里塞内容,直到撞上上限,然后报一个莫名其妙的 API 错误。或者更糟,悄悄截断了关键信息。
import tiktokenenc = tiktoken.encoding_for_model("gpt-4")deffits_in_context(messages: list, max_tokens: int = 8000) -> bool: total = sum(len(enc.encode(m["content"])) for m in messages)return total < max_tokens
完全按 OpenAI 的方式计算 token。发请求前就知道会不会超。
我以前用“字符数 / 4”来估算 token。一直没问题,直到有个客户上传了大量代码和特殊字符的文档。估算是 6K,实际是 11K。智能体在对话中途崩了。客户一点也不开心。
✔️ 适用场景:上下文窗口管理、成本估算、智能截断
⚠️ 警告:基于字符的估算在真实数据上有 30% 的错误率。别像我一样踩坑。
你的智能体打印了一个 500 行的 JSON。你滚动。你眯眼。你放弃了,然后加更多 print。
from rich.console import Consolefrom rich.table import Tablefrom rich import print_jsonconsole = Console()print_json(data=agent_response)table = Table(title="Agent Actions")table.add_column("Step")table.add_column("Tool")table.add_column("Result")for step in agent.history: table.add_row(str(step.num), step.tool, step.result[:50])console.print(table)
表格、语法高亮、进度条、树视图。你真正看得懂的调试输出。
✔️ 适用场景:开发调试、Demo 输出、CLI 界面
😏 实话实说:from rich import print 可以直接替换内置 print。一个 import,立刻升级。上个月我给客户演示智能体时,Rich 的输出收到的夸奖比智能体本身还多。
- Watchfiles —— 因为你的迭代循环正在拖垮生产力
你改一个 prompt,重启智能体,等初始化,测试,发现拼写错了,再重启一次……
from watchfiles import run_processdefmain():from my_agent import Agent agent = Agent() agent.run_interactive()if __name__ == "__main__": run_process("./", target=main)
检测文件变化,自动重载。保存即重启。
我在用它之前记录过一天的工作流:我重启智能体 40 多次。每次 8 秒。每天光等就 5 分钟多。连续好几周。
✔️ 适用场景:本地开发、Prompt 迭代、快速原型
💁♂️ 小技巧:很聪明地判断哪些变化需要重载。改 prompt 文件,立刻重载;写日志文件,不会触发。
其他经验每个库只把一件事做好。这不是偶然。
刚开始构建智能体时,我会选择那些承诺“全包”的框架。它们复杂且脆弱。一旦出问题,我调试的是框架,而不是我的智能体。(我写过为什么大多数 AI 智能体在生产中失败,这正是原因之一。)
现在我组合小而专的库:LiteLLM 负责模型调用,Instructor 负责结构化输出,Tenacity 负责重试。每个组件都可以被替换。每个组件都能被理解。
最好的智能体架构,不是最复杂的那一个,而是你能在五分钟内定位任何 bug 的那一个。
