在投资世界里,有两个永恒的问题:
收益有多高? 风险有多大?
如果你能在“相对低风险”的情况下,找到“更高收益”的股票,那它大概率就是我们常说的——牛股区间。
今天这篇文章,我带你用一段完整的 Python 代码,实现一个迷你版量化分析系统,包括:
一、数据读取:量化分析的第一步
stocks = pd.read_csv("stock_data.csv")
print("成功读取数据,数据条数:", len(stocks))
首先从 CSV 文件中读取股票数据。 数据字段包括:
然后做一个简单特征工程:
stocks["dot_size"] = stocks["volume"] * 4
成交额决定气泡大小,代表市场关注度。
二、核心指标:夏普比率(Sharpe Ratio)
量化投资里最经典的风险调整收益指标:
[ Sharpe = \frac{R - R_f}{\sigma} ]
代码实现:
risk_free_rate = 0.03
stocks["sharpe"] = (stocks["return"] - risk_free_rate) / stocks["volatility"]
含义:
这一步非常关键,它决定了后续“优质股票”的筛选逻辑。
三、风险-收益气泡图:直观看市场结构
plt.scatter(...)
这张图展示的是经典的:
📍 横轴:波动率(风险) 📍 纵轴:收益率 📍 气泡大小:成交额 📍 颜色:行业
你会看到:
四、自动圈选“牛股区间”
我们定义:
bull_zone = stocks[
    (stocks["return"] > 0.3) &
    (stocks["volatility"] < 0.3)
]
逻辑:
然后使用凸包算法(ConvexHull)进行自动圈选:
hull = ConvexHull(p)
poly = plt.Polygon(...)
这一步非常高级 —— 它不再是画矩形,而是自动围出真实的股票分布边界。
结果就是:
🔥 一张自动识别牛股区间的图
这在量化可视化中非常常见。
五、行业收益对比:行业轮动分析
industry_return = stocks.groupby("industry")["return"].mean()
通过分组统计平均收益,我们可以判断:
这一步是宏观层面的判断。
六、Sharpe Top10:真正的“优质股”
top10 = stocks.sort_values("sharpe", ascending=False).head(10)
排序逻辑:
✔ 不是收益最高
✔ 而是“单位风险收益最高”
这是专业量化分析与散户思维最大的区别。
七、风险收益相关性分析
corr = stocks["volatility"].corr(stocks["return"])
并配合回归图:
sns.regplot(...)
你可以观察:
如果相关性很低,说明市场并非简单“高风险=高收益”。
八、牛股区间统计分析
print("Number of Bull Stocks:", len(bull_zone))
print("Average Return:", ...)
print("Average Sharpe:", ...)
这一步属于策略评估:
这就是量化策略验证的基本雏形。
九、完整分析流程总结
这套代码背后其实是一整套量化思路:
数据读取
   ↓
特征工程
   ↓
风险收益建模
   ↓
Sharpe计算
   ↓
可视化分析
   ↓
策略区间筛选
   ↓
统计验证
注:代码仅学习使用,禁止用于非法/不良用途
十、全部代码无偿分享
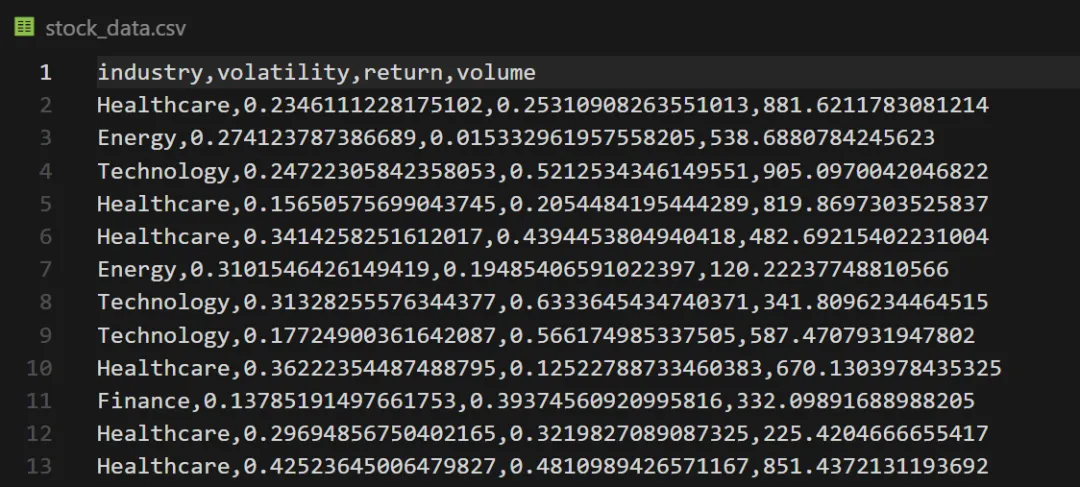
a、股票部分数据,自己可以多模拟点下面的数据,用来学习,以下只提供点样例stock_data.csv
b、创建一个.py的文件,将下面内容复制,运行
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from scipy.spatial import ConvexHull
import warnings
warnings.simplefilter('ignore')

sns.set_style("whitegrid")


# =====================================
# 1. 读取CSV文件
# =====================================
stocks = pd.read_csv("stock_data.csv")
print("成功读取数据,数据条数:", len(stocks))

stocks["dot_size"] = stocks["volume"] * 4

# =====================================
# 2. 计算夏普比率
# =====================================
risk_free_rate = 0.03
stocks["sharpe"] = (stocks["return"] - risk_free_rate) / stocks["volatility"]

# =====================================
# 3. 风险收益气泡图
# =====================================
plt.figure(figsize=(14, 8))
categories = stocks["industry"].unique()
colors = plt.cm.Set2(np.linspace(0, 1, len(categories)))

for i, ind in enumerate(categories):
    plt.scatter(
        stocks.loc[stocks.industry == ind, "volatility"],
        stocks.loc[stocks.industry == ind, "return"],
        s=stocks.loc[stocks.industry == ind, "dot_size"],
        c=[colors[i]],
        label=ind,
        edgecolors="black",
        alpha=0.7
    )

# 牛股区间
bull_zone = stocks[
    (stocks["return"] > 0.3) &
    (stocks["volatility"] < 0.3)
]

defencircle(x, y, ax=None, **kw):
ifnot ax:
        ax = plt.gca()
    p = np.c_[x, y]
if len(p) > 2:
        hull = ConvexHull(p)
        poly = plt.Polygon(p[hull.vertices, :], **kw)
        ax.add_patch(poly)

encircle(
    bull_zone["volatility"],
    bull_zone["return"],
    ec="darkred",
    fc="gold",
    alpha=0.25
)

plt.xlabel("Annual Volatility (Risk)")
plt.ylabel("Annual Return")
plt.title("Risk-Return Bubble Plot with Bull Zone")
plt.legend()
plt.show()

# =====================================
# 4. 行业收益对比
# =====================================
industry_return = stocks.groupby("industry")["return"].mean().sort_values()

plt.figure(figsize=(8, 5))
industry_return.plot(kind="bar")
plt.title("Average Return by Industry")
plt.ylabel("Average Return")
plt.show()

# =====================================
# 5. 夏普比率Top10
# =====================================
top10 = stocks.sort_values("sharpe", ascending=False).head(10)

print("\nTop 10 Stocks by Sharpe Ratio:")
print(top10[["industry", "return", "volatility", "sharpe"]])

# =====================================
# 6. 风险收益相关性
# =====================================
corr = stocks["volatility"].corr(stocks["return"])
print(f"\nRisk-Return Correlation: {corr:.3f}")

plt.figure(figsize=(6, 5))
sns.regplot(
    data=stocks,
    x="volatility",
    y="return",
    scatter_kws={"alpha": 0.4}
)
plt.title("Risk vs Return Correlation")
plt.show()

# =====================================
# 7. 牛股区间统计
# =====================================
print("\nBull Zone Statistics:")
print("Number of Bull Stocks:", len(bull_zone))
print("Average Return in Bull Zone:", bull_zone["return"].mean())
print("Average Sharpe in Bull Zone:", bull_zone["sharpe"].mean())
🔮 获取和交流
需要源码和数据的同学,关注+三连,评论“6666“,加下面微信,发你!也可以拉你进群交流学习,加群备注:IT小本本学习
为了能随时获取最新动态,大家可以动动小手将公众号添加到“星标⭐”哦,点赞 + 关注,用时不迷路!!!!
关注公众号:IT小本本 👇
 10个月宝宝每天需要喝多少奶粉?