一、学前花絮
之前的文章关于大数据、人工智能等技术进行了一些梳理,特别是对于其中的重点环节进行了专门论述。今天对数据采集的功能实现用python示例说明。
在大数据技术架构中,数据采集是整个数据处理流程的起点和基础。本文详细阐述了一种基于文件监控的自动化数据采集系统的设计与实现方案。该系统通过监控源文件夹的变化,自动将新增或修改的文件采集到目标数据仓库,为后续的数据处理、分析和挖掘提供稳定可靠的数据来源。系统采用配置驱动的方式,支持灵活的采集策略,具有良好的扩展性和可维护性。
二、以python实现大数据的自动数据采集
2.1 大数据自动采集概述
1.大数据采集的意义
在大数据生态系统中,数据采集是构建数据湖、数据仓库的基础环节。随着企业数字化转型的深入,业务系统每天产生海量的结构化、半结构化和非结构化数据。这些数据散落在各个业务部门、应用系统和终端设备中,如何高效、准确、及时地将这些数据汇聚到统一的数据平台,成为大数据项目实施的关键。
自动化的数据采集系统能够:
l实时或准实时地收集业务数据
l减少人工干预,降低运维成本
l保证数据的一致性和完整性
l为数据分析和决策提供及时支持
2. 系统应用场景包括:
l日志采集:集中收集服务器、应用程序的运行日志
l业务数据汇聚:各部门业务系统的数据文件自动归集
l物联网数据收集:传感器、设备生成的数据文件同步
l报表文件归档:定期生成的报表文件自动备份
l多媒体内容同步:图片、视频等非结构化数据采集
2.2 系统设计原则
1. 核心设计理念
本系统遵循以下设计原则:
l松耦合设计:采集逻辑与业务逻辑分离,通过配置文件驱动
l可观测性:完整的日志记录和监控机制
l容错性:网络波动、文件锁定等异常情况的健壮处理
l可扩展性:支持插件化扩展,适应不同数据源
l易用性:简洁的配置界面,降低使用门槛
2.架构模式选择
采用事件驱动架构,基于文件系统事件触发采集动作。相比传统的轮询模式,事件驱动具有以下优势:
l实时性更高,响应更及时
l系统资源消耗更低
l避免不必要的文件扫描
l支持更精细的事件过滤
2.3 核心功能设计
1. 文件变化监控
系统需要监控以下几种文件变化事件:
l文件新增监控
当新文件出现在监控目录时,系统应自动检测并触发采集流程。需要考虑以下情况:
① 文件完全写入后的新增
② 网络传输中途的文件
③ 大文件的分段写入
处理策略:采用延迟采集机制,避免采集到不完整的文件。通过检查文件锁定状态和最后修改时间,确保文件已稳定。
l文件修改监控
对于已存在的文件发生内容更新时,系统需要判断是否需要重新采集。关键技术考量包括:
① 修改时间戳比较
② 文件大小变化检测
③ 可选的文件哈希校验
④ 避免频繁修改导致的重复采集
处理策略:通过对比源文件和目标文件的修改时间、文件大小等属性,智能判断是否需要重新同步。
子目录递归监控
实际业务场景中,数据往往以目录树的形式组织。系统需要支持:
l深度递归监控
l可配置的监控深度
l特定目录的排除规则
l新增子目录的自动发现
处理策略:通过递归监听机制,确保所有子目录的变化都能被捕获。
2. 目录结构保持
在采集过程中,保持源目录结构对于数据管理和后续处理至关重要:
l相对路径保持:在目标目录中复现源目录的相对结构
l路径映射规则:支持基于正则表达式的路径转换
l目录权限保留:可选地保持目录权限属性
l软链接处理:正确处理符号链接和硬链接
3. 采集策略配置
系统提供多种采集策略,用户可根据业务需求灵活选择:
复制模式
l完全复制:每次采集都复制完整文件
l增量复制:只复制发生变化的部分
l差异复制:基于校验和的智能复制
移动模式
l立即移动:采集后立即删除源文件
l延迟移动:采集成功后确认再删除
l归档移动:移动到专门的归档目录
处理冲突
l覆盖策略:用新文件覆盖旧文件
l跳过策略:目标存在时不处理
l重命名策略:自动生成新文件名
l版本控制:保留历史版本
2.4 配置系统设计
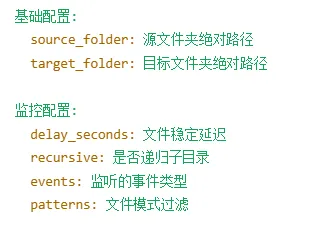
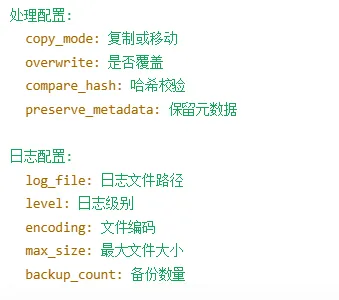
1. 配置文件结构
系统采用YAML格式的配置文件,结构清晰且易于维护:
2. 关键参数详解
文件稳定延迟(delay_seconds)
这是系统中最重要的性能与可靠性权衡参数:
l技术原理:避免采集正在写入的文件
l影响因素:文件大小、写入速度、网络状况
l推荐值:
① 日志文件:10-30秒
② 交易数据:2-5秒
③ 批量文件:30-60秒
④ 大文件:60-300秒
⑤ 自适应策略:可根据文件大小动态调整延迟时间
递归监控(recursive)
控制是否监控子目录变化:
ltrue:监控所有子目录
lfalse:仅监控根目录
l深度限制:可配置最大递归深度
l排除规则:支持正则表达式排除特定目录
文件模式过滤(patterns)
通过通配符模式过滤文件:
l示例:["*.csv", "*.json", "data_*.txt"]
l支持多个模式组合
l可按需启用或禁用
l支持正则表达式高级匹配
复制模式(copy_mode)
决定文件的处理方式:
lcopy:复制文件,源文件保留
lmove:移动文件,源文件删除
应用场景:
lcopy:数据备份、多份复制
lmove:文件归档、空间回收
2.5 日志与监控系统
1. 日志记录策略
完善的日志系统是运维和故障排查的基础:
日志级别设计
DEBUG:详细的调试信息,文件操作细节
INFO:常规操作记录,文件采集成功
WARNING:警告信息,可恢复的错误
ERROR:错误信息,需要干预的问题
CRITICAL:严重错误,系统无法继续运行
日志内容规范
每条日志记录应包含:
l时间戳:精确到毫秒
l日志级别:标识严重程度
l模块名称:定位问题来源
l线程/进程ID:并发问题分析
l操作类型:创建、修改、删除等
l文件路径:相关文件信息
l操作结果:成功、失败、跳过
l耗时统计:性能监控数据
l错误详情:异常堆栈信息
2. 日志文件管理
滚动策略
l按大小滚动:文件达到指定大小时创建新文件
l按时间滚动:每天、每小时创建新日志文件
l保留策略:保留最近N个日志文件
l压缩归档:自动压缩历史日志文件
编码与格式
l统一编码:使用UTF-8编码,避免乱码
l结构化格式:便于日志分析工具处理
l可读性:人工阅读时易于理解
l机器可解析:支持自动化日志分析
3. 监控指标
系统应收集以下关键指标:
性能指标
l文件采集成功率
l平均采集延迟
l吞吐量(文件/秒,MB/秒)
l系统资源使用率
业务指标
l各类文件采集数量
l文件大小分布统计
l失败文件类型分析
l延迟分布直方图
质量指标
l数据一致性校验结果
l文件完整性验证
l采集时效性统计
l错误率趋势分析
2.6 系统健壮性设计
1. 异常处理机制
文件操作异常
l文件锁定:等待重试或跳过
l权限不足:记录日志并跳过
l磁盘空间不足:预警并暂停
l文件损坏:校验失败处理
系统资源异常
l内存不足:优雅降级或重启
lCPU过载:限流或暂停
lIO瓶颈:调整并发度
l网络异常:重试或缓存
2. 重试策略
智能的重试机制提高系统可靠性:
l指数退避:重试间隔逐渐增加
l最大重试次数:避免无限重试
l分级重试:不同错误类型不同策略
l死信队列:永久失败文件特殊处理
3. 数据一致性保证
确保采集数据的完整性和一致性:
l原子性操作:要么完全成功,要么完全失败
l事务性复制:先复制到临时位置,验证后移动
l完整性校验:文件大小、校验和验证
l幂等性设计:重复操作结果一致
2.7 部署与运维
1. 部署架构
单机部署
适用于小规模场景:
l简单配置,易于管理
l资源需求低
l适合测试和开发环境
分布式部署
适用于大规模生产环境:
l多实例负载均衡
l高可用架构
l横向扩展能力
2. 运维最佳实践
配置文件管理
l版本控制
l环境隔离
l加密敏感信息
监控告警
l关键指标监控
l异常自动告警
l性能趋势分析
容量规划
l存储空间预估
l网络带宽规划
l系统资源预留
备份恢复
l配置文件备份
l状态信息备份
l灾难恢复预案
2.9 总结与展望
本文设计的大数据自动采集系统,基于文件监控机制,实现了高效、可靠的数据采集功能。系统具有以下特点:
l配置驱动:通过灵活的配置文件适应不同业务场景
l实时响应:基于文件系统事件的即时采集
l健壮可靠:完善的异常处理和重试机制
l易于运维:详细的日志记录和监控指标
l扩展性强:支持插件化扩展和分布式部署
随着大数据技术的不断发展,未来可以在以下方向进行增强:
l智能调度:基于机器学习的自适应采集策略
l流式处理:与流计算框架深度集成
l云原生支持:容器化部署和云服务集成
l安全增强:端到端加密和审计追踪
l边缘计算:支持边缘节点的数据采集
2.10 python程序示例
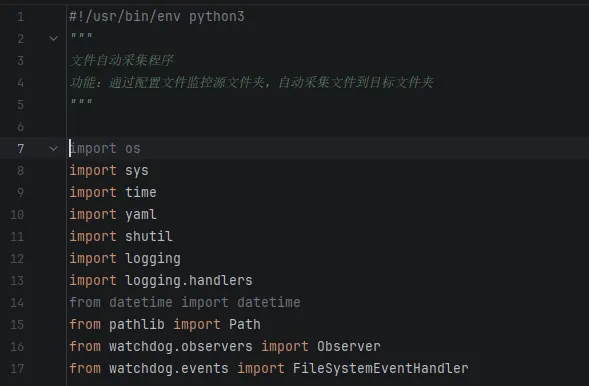
以上是程序中对于内置模块的导入
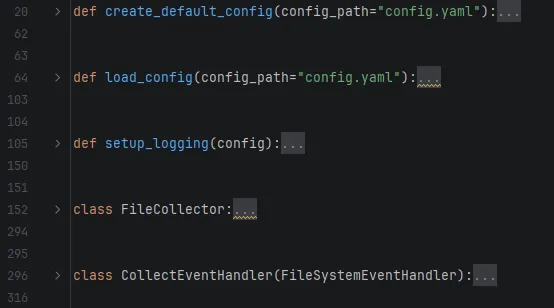
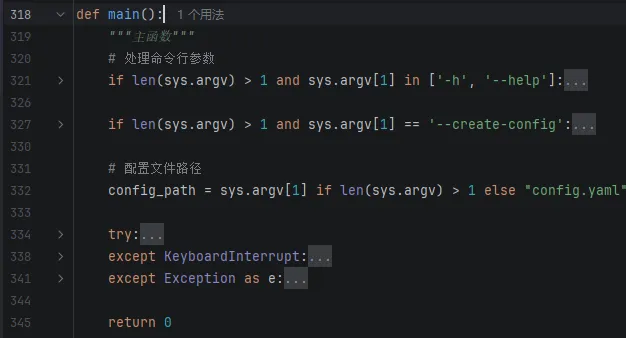
下面是主函数调用:
输出结果:
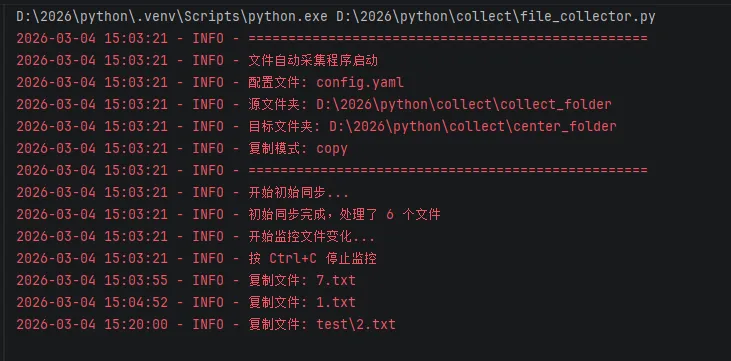
以上测试在本机模拟两个目录,通过新增文件、修改文件、创建子目录等方式,测试数据采集成功。
三、小结
本系统为大数据处理流程提供了可靠的数据来源,为企业数据价值的挖掘奠定了坚实基础。通过合理的配置和运维,能够满足大多数场景下的数据采集需求,是构建大数据平台的重要基础设施。
 10个月宝宝每天需要喝多少奶粉?