一个反常识的困境
很多学生告诉我:我学会了Python,但我依然不想用。
不仅要花了几个月学Python,Pandas、openpyxl、循环、函数……都学了。
在网上看教程,在IDE里调试,甚至还看了不少数据处理的博客文章。
但真到用的时候,会发现:
这次统计专业大类,我要写一段代码;
下一次统计年级分布,我又要改一段代码;
再下一次数据源变了,列位置不对了,还得继续改。
每一次都要打开IDE,回忆语法,调试报错。
需求稍微一变,代码就要重写一遍。
学是学会了,但真正落到工作里,还是觉得累。
所以,即使会写Python,面对这类任务的时候,大部分人第一反应依然是:
能不能用Excel公式凑一下?能不能手动算一下?
这听起来很矛盾,但我相信很多同行都有过这种体验。
转折:AI带来的,不是“写代码更快”
直到AI工具(比如Trae、CodeBuddy这类)的出现,
给打工人开了一扇窗。
以前的逻辑:学编程 → 写代码 → 改代码 → 运行 → 解决问题
现在的逻辑:描述需求 → AI生成代码 → 本地运行 → 完成
听起来只是顺序变了,但本质上,已经是两种完全不同的工作方式。
不是“AI帮我写Python更快了”,
而是“我根本不需要再把精力放在Python语法上了”。
我不需要记Pandas怎么分组,不需要知道openpyxl的方法名,也不需要反复调试循环里的逻辑错误。
我只需要用人话告诉AI:我要做什么,然后它就给我生成可以直接运行的代码。
这改变的,不只是效率,更是整个做事的心态。
真实案例:专业大类统计这件事,到底麻烦在哪
让我用一个最近真实发生的工作来具体说说。
开学初,领导给我丢过来一个表格,
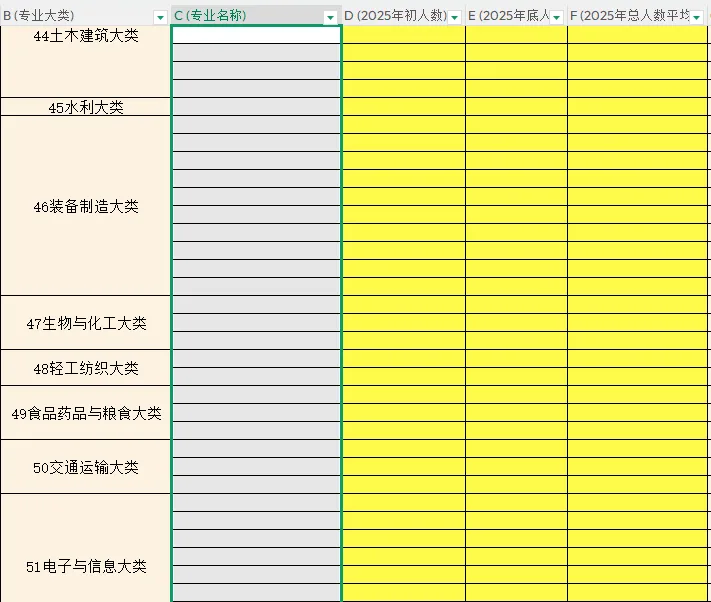
说:“填一下各学院专业大类的人数统计,要年初、年底、平均三个时间点。”
我打开表格一看,只有大类名称,没有对应的专业列表。而我手头的学生名单里,只有每个学生的专业名称,没有专业大类。
这就出现了一个关键问题:
必须先建立“专业 → 专业大类”的映射关系,后面的统计才做得下去。
新做法
第一步:把任务说清楚。
我有一份1万多名学生的Excel名单(已经脱敏处理,只保留专业,报包括个人信息),每个学生有专业名称。
请根据教育部2025年最新专业目录,把这些专业映射到对应的大类,再按大类统计学生人数,并按指定格式填进报表,输出年初、年底和平均三个时间点的数据。
第二步:让AI直接给出完整代码。
我把需求丢给AI,它直接把读取数据、建立映射、分类统计、格式转换这些逻辑一次性生成出来。
关键是:我没有自己写一行代码。
如果按以前的路子,我至少还得自己做这些事:
•打开IDE
•回忆pandas怎么读Excel
•想怎么用字典建立映射关系
•写循环、分组和汇总逻辑
•测试、调bug、修改
现在?这些我直接跳过去了。
第三步:本地运行,检查结果。
数据不出本机,敏感信息更安全。
代码跑完之后,我只需要核对结果,然后提交给领导。
最后真正花掉的时间,大概10分钟。
而且准确率更稳,没有手滑填错单元格的风险。
为什么这种方式更适合体制内的真实工作
1. 省掉的,不只是操作时间
很多人以为,AI的价值只是“帮你把代码写快一点”。但我现在越来越觉得,真正省掉的,是前期那一大段学习、回忆、修改、调试的心智消耗。
你不用先把自己切换成“程序员模式”,才有资格解决一个行政数据问题。
你只要把问题讲明白,就已经走完最关键的一步了。
2. 需求一变,也不用整个人重来
今天统计专业大类,明天也许就是统计就业率、招生情况、课程分布。
传统做法是每次改代码;现在的做法,是每次只改描述。
这点非常重要。因为行政工作本来就是需求常变,但流程相似。
AI正好接住了这类“重复结构 + 变化内容”的任务。
3. 本地运行,安全感完全不一样
这一点对体制内尤其关键。学生名单、绩效数据、工资信息,这些东西不是不能处理,而是不能乱传。
本地运行最大的意义,就是数据不离开自己的电脑。你既享受了AI的效率,又不用在隐私和安全上提心吊胆。
4. 映射关系一旦梳理好,就是资产
像这次的“专业 → 专业大类”映射,一旦建立起来,后面统计就业率、招生规模、成本结构,很多工作都能继续复用。
所以真正值钱的,往往不是那段代码,而是你把业务关系理清楚的那一步。
心态上的变化,才是最明显的
以前接到这类任务,我心里其实会先烦一下。
“又要花一两个小时做重复劳动……”
“又要一个格子一个格子填,特别容易出错……”
“明明学过Python,怎么还是每次都得从头折腾……”
现在不是不忙,而是没那么抗拒了。因为心里知道,这件事不用再靠硬扛。
以前觉得这事很烦,现在觉得:哦,10分钟的事,做掉就行。
效率提升是一层,更深的是心理压力明显变小了。
很多原来想拖一拖的任务,现在反而愿意马上处理。
给同行的四点建议
1. 不必先逼自己学成程序员
如果你的目标不是走专业开发路线,那就没必要先把门槛抬到“我必须精通Python”这么高。对很多行政场景来说,真正重要的是把问题讲清楚,而不是把语法背熟。
2. 优先梳理数据之间的对应关系
很多数据工作卡住,不是因为不会算,而是因为关系没理顺。
像“专业 → 大类”“教师 → 教研室”“班级 → 学院”这类映射,往往才是工作的关键节点。
3. 涉及敏感数据时,坚持本地运行
AI很好用,但不是所有场景都适合把原始数据上传到云端。
尤其在学校、事业单位这类环境里,本地运行几乎应该成为默认选项。
4. 从一个具体小场景开始
不用一上来就想着系统重构、流程再造。
先把眼前那个最烦、最重复、最耗时间的任务解决掉,感受一次真实收益,比什么大道理都更有效。
结尾
技术一直在变,但工作的本质没变:
把混乱的数据,整理成清晰的结论。
从手工整理,到Excel公式,到Python脚本,再到AI辅助,每种工具都有它的时代。
而现在,越来越多的工作,已经走到了一个新的阶段:
你不一定要亲自写代码,但你可以借AI把问题解决掉。
附注:真正需要谨慎的,不是工具,而是信息来源
这件事里最容易出问题的地方,其实不是代码本身,而是映射关系的信息来源。
例如:教育部专业目录会调整,有些专业在不同版本里所属大类会变化。
所以我在让AI生成代码时,一定会强调:
必须使用2025年最新版的专业目录。
AI很强,但前提条件必须对,这一点不能偷懒。
你在工作里,有没有这种“并不难,但特别磨人”的任务? 如果有,欢迎留言说说,也许我们能一起把它拆开、改造掉。
关注我 持续更新体制内AI实践 不讲大道理,只写真正用过、真正有效的。
 10个月宝宝每天需要喝多少奶粉?