
当前位置:首页>python>飞跃课堂回顾 | Python爬虫入门

飞跃课堂回顾 | Python爬虫入门

  • 2026-09-08 16:20:07
飞跃课堂回顾 | Python爬虫入门

亲爱的各位腾小飞

篇幅冗长的论文是不是让你望而生畏?

面对海量的网络信息

是不是想拥有一键get的超能力?

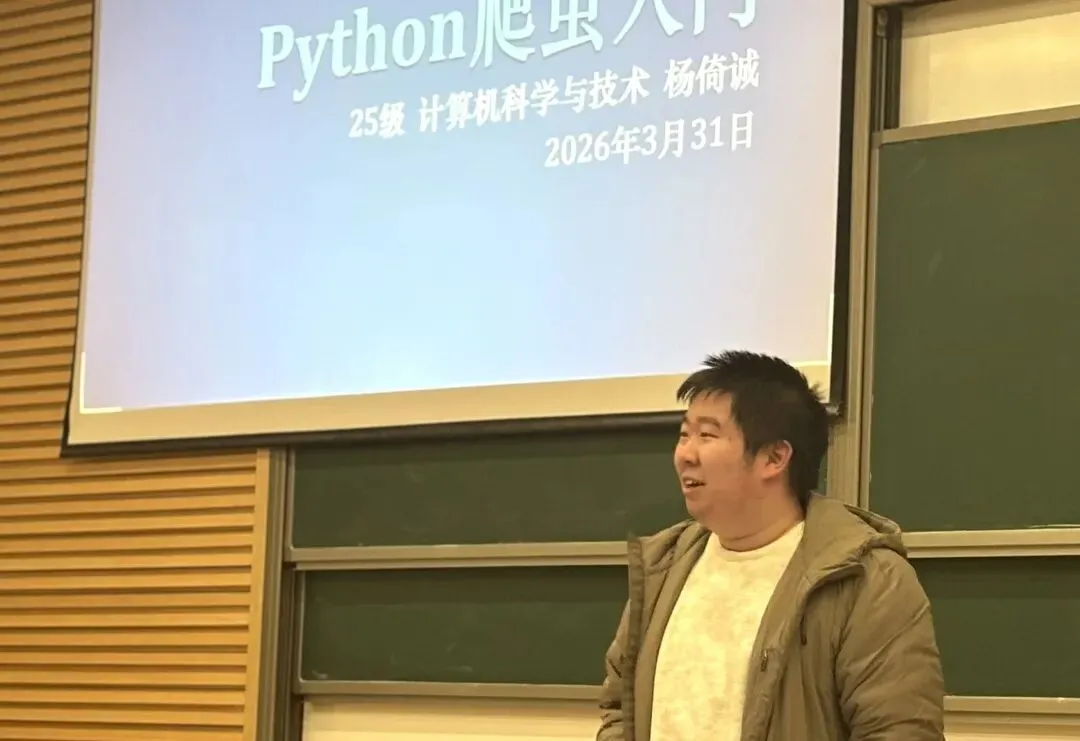
本次飞跃课堂我们邀请到了

计算机科学与技术专业的杨倚诚同学

带领大家从零开始

探索网络爬虫的秘密

没来得及参加课程

或者想重温课程精华的小伙伴

快跟上我们的脚步

一起回顾一下这场干货满满的分享吧!

01

初识爬虫

Crawl Basics

网络爬虫正如它的名字一般,就像一个不知疲倦的 “网络蜘蛛”,能够自动浏览并帮助我们高效地收集和整理信息。从获取课程表、饭卡余额,到查询快递物流、统计论文关键词,只要是和网页有关的内容,爬虫都能帮你自动化处理,大大提升效率。

02

原理解析

Principle Analysis

01

HTTP协议

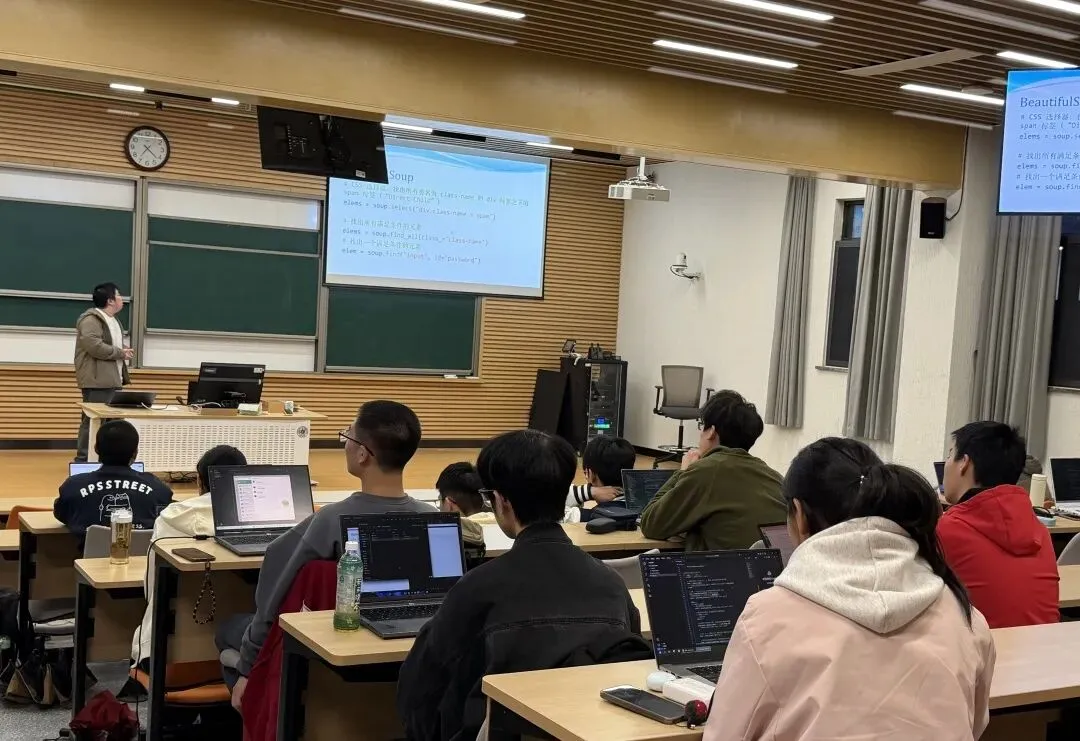
首先,杨同学用通俗的例子解释了 HTTP 协议的请求与响应过程:浏览器向服务器发送 “我需要某个页面” 的请求(GET),服务器则返回对应的页面内容(OK),这正是爬虫模拟浏览器行为的基础。

02

HTML、CSS 与 JavaScript

HTML 是网页的骨架,CSS 负责样式美化,而 JavaScript 则赋予网页动态交互能力。深入理解这些核心技术,是精准定位和高效提取网页数据的关键。

03

实战进阶:工具vs反爬

Advanced Practice

理论之后,我们就进入了实战环节,在这一环节,杨同学介绍了处理复杂网页的高级工具:Selenium。面对带有 JavaScript 动态加载内容的网页,普通的爬虫工具可能无能为力。这时,Selenium 等工具就派上了用场,它可以直接操控浏览器,像真人一样浏览网页,轻松应对复杂场景。

04

“礼貌” 爬虫

Polite Crawler

课程的最后,也是最重要的部分,大家在爬虫时一定要注意法律与伦理问题,任何需要登录的个人隐私数据、受版权保护的内容都是不能爬取的。同时,大家也要学会做出有礼貌的爬虫机器人,通过设置请求延迟、遵守网站的 robots.txt 协议,来尊重网站的规则。

以上就是这次飞跃课堂的全部内容啦

希望在未来的学习和研究中

大家都能运用今天所学

高效合规地获取信息

让数据成为自己的得力助手!

飞跃课堂

期待你的下次参与!

文案 | 唐一朝

排版 | 刘士铂

头图 | 刘士铂

编辑 | 周钰淏

责任编辑 | 王奕璇

审核 | 王银飞

最新文章

随机文章