由于借助 AI 工具学习编程已经变得非常容易了,因此之后的课程就不再默认进行视频讲解了,如果特别需要视频讲解也可以联系李老师预约讲解~讲义材料学习过程中遇到的问题也可以及时与李老师联系。
购买 RStata 名师讲堂会员即可参加该课程啦(之前的和未来的都可以参加)!
价格:2800/年 或者 4800/长期
购买会员可以从这里下单:https://rstata.duanshu.com/#/card/list/
名师讲堂会员权益:
- 参加平台上的其他 R 语言和 Stata 的课程;
- 以会员折扣价购买我们分享的数据资料(10 元/份);
* 如果发票可添加小编微信 r_stata2 (RStata 李老师)开具。如需数据资料,购买后可添加小编微信免费领取数据折扣卡。
更多关于 RStata 会员的更多信息可添加微信号 r_stata2 咨询:
课程主页(点击文末的阅读原文即可跳转):https://rstata.duanshu.com/#/brief/course/11a0e54fff2447f4a0d1542a30f4e8eb
指标来源与背景
关键核心技术突破(CKTB,Critical and Key Technology Breakthrough)指标体系来源于王海花等(2026)发表于《科学学研究》的论文:《专精特新企业技术专业化与关键核心技术突破》。
该研究以我国前五批上市的专精特新小巨人企业中新一代信息技术产业为研究对象,深入探索技术专业化对关键核心技术突破的作用效应,在实证研究中使用专利数据构建了 CKTB 综合评分指标。
理论依据
关键核心技术具有以下三个核心特征:
| |
|---|
| 基础性 | 技术的科学根基深厚、知识积累丰富,体现研究与开发的深度 |
| 体系性 | 技术在产业体系中的地位,体现与上下游关联的广度与合作 |
| 竞争性 | 技术在国际市场中的差异化竞争力,体现技术覆盖与保护范围 |
测度指标
基于三大特征维度,论文构建了如下 7 个专利层面指标:
特征维度 = c("基础性", "基础性", "基础性", 测度指标 = c("科学关联度", "技术累积度", "权利要求", 专利指标 = c("npl(非专利文献引用量)",kable(ind_df, align = "lll")指标说明:
- 非专利文献引用量(npl):专利引用的科技文献(如学术论文)数量,反映专利的科学知识根基深度
- 引用专利数量(bwd_cite):专利引用的在先专利数量(向后引用),体现技术积累程度
- 权利要求数量(claims):专利权利要求条款数,条款越多代表技术覆盖越精细
- 3年内被引次数(fwd_cite):专利申请后3年内被其他专利引用的次数,体现技术社会价值
- 专利权人数量(assignees):联合申请人数量,反映合作创新程度
- 同族成员数量(family):在其他国家/地区提交的同族专利数,体现国际竞争布局
- IPC覆盖(ipc_cover):企业当年专利跨越的 IPC 部(section)数量,反映技术领域多样性
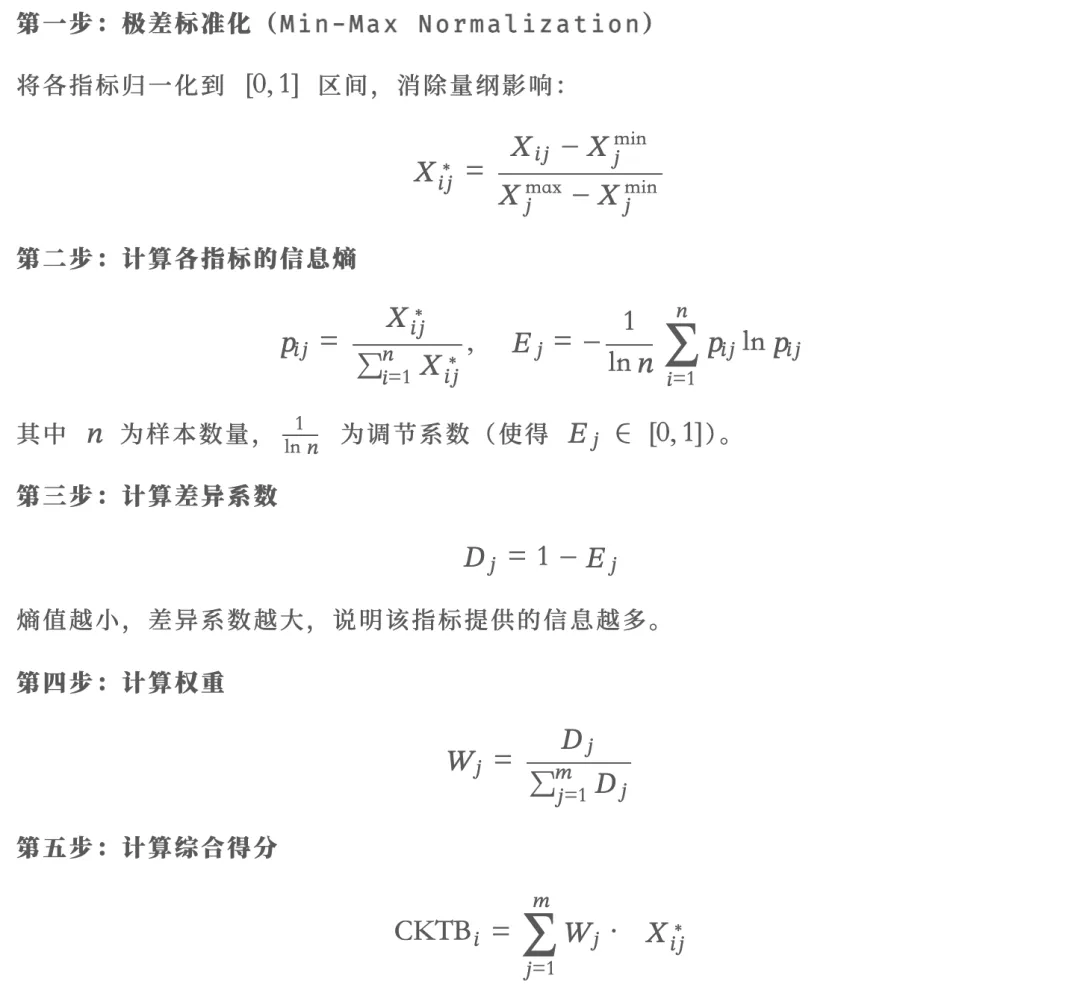
熵权法原理
**熵权法(Entropy Weight Method)**是一种客观赋权方法,不依赖专家主观判断,而是根据各指标的信息量来自动决定权重。其核心思想是:
如果某个指标在所有样本中的取值差异很大,说明它包含的信息量多,应给予更高权重;反之,若某指标的取值在所有样本中基本相同(无差异),则该指标对区分样本无帮助,权重接近 0。
计算步骤
熵权法函数实现(Python)
参数 X: n × m 的 DataFrame 或 ndarray,n=样本数量,m=指标数量 返回: dict,包含 scores(综合得分)、weights(权重)、E(信息熵) X = np.array(X, dtype=np.float64) denom[denom == 0] = 1e-10# 极差为 0 时防止除零 X_norm = (X - X_min) / denom X_norm = X_norm + 1e-10# 避免 log(0) col_sum = X_norm.sum(axis=0) k = 1.0 / np.log(n) # 调节系数 E = -k * (P * np.log(P + 1e-10)).sum(axis=0) E = np.minimum(E, 1.0) # 熵值上限为 1return {"scores": scores, "weights": W, "E": E}
使用 reticulate 创建与管理 Python 虚拟环境
在 R 中通过 reticulate 包来调用 Python,最好的实践是为项目创建一个专属的 Python 虚拟环境,将所需依赖隔离到独立空间,避免与系统 Python(如 Anaconda)发生版本冲突。
重要说明(避免"已初始化"报错):reticulate 在 R 会话中只能绑定一次 Python——一旦某个 {python} 代码块运行,Python 解释器就被锁定,之后再调用 use_virtualenv() 会报错:
ERROR: The requested version of Python cannot be used, as another version has already been initialized.因此,虚拟环境的激活必须在所有 {python} 代码块之前完成。本文档的解决方案是在 setup chunk 中通过 Sys.setenv(RETICULATE_PYTHON = ...) 提前锁定 Python 路径,这是 reticulate 选取 Python 的最高优先级入口。
安装 reticulate(仅首次)
# 设置 CRAN 镜像(knit 时 R 处于非交互模式,不会自动选择镜像)options(repos = c(CRAN = "https://mirrors.tuna.tsinghua.edu.cn/CRAN/"))if (!requireNamespace("reticulate", quietly = TRUE)) { install.packages("reticulate") message("reticulate 安装完成!") message("reticulate 已安装,版本:", packageVersion("reticulate"))虚拟环境初始化原理(已在 setup chunk 中完成)
本文档的 setup chunk(隐藏运行)包含如下逻辑:
.venv_python <- virtualenv_python(.venv_name)if(!file.exists(.venv_python)){ virtualenv_create(.venv_name) .venv_python <- virtualenv_python(.venv_name)# 通过环境变量抢先锁定 Python(优先级最高,早于任何 {python} chunk)Sys.setenv(RETICULATE_PYTHON = .venv_python)use_virtualenv(.venv_name, required =TRUE)在虚拟环境中安装 Python 包(仅首次)
py_pkgs <- c("numpy", "pandas")installed <- py_list_packages(".venv")$packageneed_install <- setdiff(py_pkgs, installed)if (length(need_install) > 0) { virtualenv_install(".venv", packages = need_install) message("已安装缺失的包:", paste(need_install, collapse = ", ")) message("所有 Python 包已就绪,无需安装")验证激活状态
查看已安装的包
pkgs <- py_list_packages(".venv")key_pkgs <- c("numpy", "pandas")pkgs[pkgs$package %in% key_pkgs, c("package", "version")]虚拟环境管理常用命令
# 删除虚拟环境:virtualenv_remove(".venv")# 升级包:virtualenv_install(".venv", packages = "numpy", ignore_installed = TRUE)
数据准备
本讲义使用的数据文件:
| |
|---|
2010~2012年上市公司与专利数据匹配结果_含引用与被引用信息.csv | 主数据:专利-企业匹配,含各类引用信息(约 1 GB) |
1985~2024年各专利当年~十一年内的被自引、被他引数量统计.csv | 被引统计:专利被他引的分年统计(约 979 MB) |
拓展专利信息.csv | 拓展信息:权利要求数量、同族专利(约 1.5 GB) |
上市公司数据来自:
1985~2024 年上市公司与专利数据匹配结果(版本3, 含申请、授权信息): https://rstata.duanshu.com/#/brief/course/04100321f88b411f90429be934934bff
被自引、被他引数量统计数据来自:
1985~2024 年各专利当年~十一年内的被自引、被他引数量统计: https://rstata.duanshu.com/#/brief/course/51e62d1eae074a4d8174a3969f5025c6
拓展专利信息.csv 是我又从原始专利数据提取补充的一些变量:
1985~2024 年专利申请与授权数据(版本 3,含申请人所处的省市区县): https://rstata.duanshu.com/#/brief/course/2397451274c546d3a36e156ffc865988
PATH_MATCH = "2010~2012年上市公司与专利数据匹配结果_含引用与被引用信息.csv"PATH_CITE = "1985~2024年各专利当年~十一年内的被自引、被他引数量统计.csv"PATH_EXTEND = "拓展专利信息.csv"
单公司演示:以凯莱英(002821)2012 年为例
为了清晰演示 CKTB 的计算过程,我们以凯莱英(股票代码:002821)2012 年的数据为例,逐步演示每个步骤。凯莱英是一家以化学合成和医药研发为核心的创新型企业,2012 年共申请了 23 件专利,样本量适中,演示效果清晰。
演示时使用 nrows=300000 读取前 30 万行数据(凯莱英记录最远至第 295539 行),确保能完整捕获该公司所有专利。全量计算见下一节。
第一步:读取主数据
# 读取前 300000 行(演示用,覆盖凯莱英全部记录)cols_main = ["股票代码", "股票名称", "newipzlid", "年份","引证科技文献", "引证专利", "当前权利人",# dtype 指定:股票代码必须为字符串(保留前导零),其他关键 ID 也设为字符串df_main_raw = pd.read_csv( PATH_MATCH, usecols=cols_main, nrows=300000, dtype={"股票代码": str, "newipzlid": str, "公开公告号": str, "申请号": str}df_main_raw = df_main_raw.rename(columns={"newipzlid": "patent_id",print(f"读取完成:{len(df_main_raw)} 条专利记录(演示用 30 万行)")firms = df_main_raw["firm_id"].nunique()years = sorted(df_main_raw["apply_year"].unique())print(f"涉及企业数:{firms} 家,年份:{'、'.join(str(y) for y in years)}")第二步:专利去重
同一专利可能因为多源数据拼接而产生重复记录,需要去重。策略:优先保留在被引用统计表中出现的专利(因为该专利有更完整的引用信息)。
# 读取被引用统计中的专利 ID 集合(用于去重时优先保留)cite_ids = pd.read_csv(PATH_CITE, usecols=["newipzlid"], nrows=200000, dtype={"newipzlid": str})cite_ids = set(cite_ids["newipzlid"].unique())print(f"被引用统计中的专利数(前 20 万行去重后):{len(cite_ids)}")df_main_raw["in_cite"] = df_main_raw["patent_id"].isin(cite_ids)df_main_raw["公开公告号_clean"] = df_main_raw["公开公告号"].str.replace(r"[A-Z]$", "", regex=True)# 去重:优先保留 in_cite=True 的记录# 先按 firm_id, apply_year, in_cite(降序)排序,再对公开公告号_clean和申请号分别去重df_main_raw = df_main_raw.sort_values( ["firm_id", "apply_year", "in_cite"], ascending=[True, True, False]df_main = df_main_raw.drop_duplicates( subset=["firm_id", "apply_year", "公开公告号_clean"], keep="first"df_main = df_main.drop_duplicates( subset=["firm_id", "apply_year", "申请号"], keep="first"print(f"去重前:{len(df_main_raw)} 条 → 去重后:{len(df_main)} 条")df_demo = df_main[(df_main["firm_id"] == "002821") & (df_main["apply_year"] == 2012)].copy()print(f"凯莱英(002821)2012 年专利数:{len(df_demo)} 条")第三步:读取拓展信息并合并
usecols=["newipzlid", "权利要求数量", "扩展同族"],df_extend = df_extend.rename(columns={"newipzlid": "patent_id", "权利要求数量": "claims_ext"})df_demo = df_demo.merge(df_extend, on="patent_id", how="left")print(f"拓展信息合并后:{len(df_demo)} 条记录")第四步:提取专利层面 CKTB 指标
# npl: 非专利文献引用量(基础性-科学关联度)各指标描述性统计:
indicator_cols = ["npl", "bwd_cite", "claims", "assignees", "family", "ipc_cover"]desc = df_demo[indicator_cols].describe().T[["min", "mean", "max"]]desc.columns = ["最小值", "均值", "最大值"]desc["均值"] = desc["均值"].round(2)第五步:合并 3 年内被引次数
df_cite_sample = pd.read_csv(PATH_CITE, nrows=200000, dtype={"newipzlid": str})df_fwd_demo = df_cite_sample[df_cite_sample["引用或被引用"] == "被他引信息"].copy()df_fwd_demo = df_fwd_demo[["newipzlid", "year", "三年内"]].rename( columns={"newipzlid": "patent_id", "year": "cite_year", "三年内": "fwd_cite"}df_fwd_demo["fwd_cite"] = df_fwd_demo["fwd_cite"].fillna(0).astype(int) df_fwd_demo, left_on=["patent_id", "apply_year"], right_on=["patent_id", "cite_year"], how="left"df_demo["fwd_cite"] = df_demo["fwd_cite"].fillna(0).astype(int)print(f"fwd_cite — 均值: {df_demo['fwd_cite'].mean():.2f},最大值: {df_demo['fwd_cite'].max()}")第六步:运行熵权法
第七步:汇总到企业-年度
firm_demo = df_demo.groupby(["firm_id", "apply_year"]).agg( CKTB=("cktb_score", "mean"), n_patents=("cktb_score", "count"), ipc_cover=("ipc_cover", "first")firm_demo = firm_demo.rename(columns={"apply_year": "year"})firm_demo["CKTB"] = firm_demo["CKTB"].round(4)firm_names = df_demo[["firm_id", "股票名称"]].drop_duplicates()firm_demo = firm_demo.merge(firm_names, on="firm_id", how="left")print(firm_demo[["firm_id", "股票名称", "year", "CKTB", "n_patents", "ipc_cover"]].to_string(index=False))Top 10% 稳健性指标:
top10_thr = np.quantile(df_demo["cktb_score"].values, 0.90)print(f"Top10% 得分门槛(凯莱英 2012 年):{top10_thr:.4f}")n_top10 = (df_demo["cktb_score"] >= top10_thr).sum()print(f"Top10% 关键核心技术专利数:{n_top10} 件(占比 {100 * n_top10 / len(df_demo):.1f}%)")
全量计算:所有公司、所有年份
上面演示了单家公司的计算逻辑,以下代码对全部数据(2010~2012 年)进行批量计算。
注意:由于原始数据文件约 1~1.5 GB,完整运行需要较多内存(建议 16 GB+ RAM)和时间(约 10~30 分钟)。
完整计算代码
PATH_MATCH = "2010~2012年上市公司与专利数据匹配结果_含引用与被引用信息.csv"PATH_CITE = "1985~2024年各专利当年~十一年内的被自引、被他引数量统计.csv"PATH_EXTEND = "拓展专利信息.csv"print(">>> 步骤1: 读取全量主数据...")cols_main = ["股票代码", "股票名称", "newipzlid", "年份","引证科技文献", "引证专利", "当前权利人",df_all = pd.read_csv(PATH_MATCH, usecols=cols_main, dtype={"股票代码": str, "newipzlid": str, "公开公告号": str, "申请号": str})df_all = df_all.rename(columns={"股票代码": "firm_id", "newipzlid": "patent_id", "年份": "apply_year"})print(f" 全量记录:{len(df_all)} 条")cite_ids = pd.read_csv(PATH_CITE, usecols=["newipzlid"], dtype={"newipzlid": str})["newipzlid"].unique()df_all["in_cite"] = df_all["patent_id"].isin(cite_ids)df_all["公开公告号_clean"] = df_all["公开公告号"].str.replace(r"[A-Z]$", "", regex=True)df_all = df_all.sort_values(["firm_id", "apply_year", "in_cite"], ascending=[True, True, False])df_all = df_all.drop_duplicates(subset=["firm_id", "apply_year", "公开公告号_clean"], keep="first")df_all = df_all.drop_duplicates(subset=["firm_id", "apply_year", "申请号"], keep="first")print(f" 去重后:{len(df_all)} 条")print(">>> 步骤3: 读取拓展信息...")df_extend = pd.read_csv(PATH_EXTEND, usecols=["newipzlid", "权利要求数量", "扩展同族"], dtype={"newipzlid": str})df_extend = df_extend.rename(columns={"newipzlid": "patent_id", "权利要求数量": "claims_ext"})df_all = df_all.merge(df_extend, on="patent_id", how="left")print(">>> 步骤5: 读取被引用统计...")df_fwd = pd.read_csv(PATH_CITE, dtype={"newipzlid": str})df_fwd = df_fwd[df_fwd["引用或被引用"] == "被他引信息"].copy()df_fwd = df_fwd[["newipzlid", "year", "三年内"]].rename( columns={"newipzlid": "patent_id", "year": "cite_year", "三年内": "fwd_cite"}df_fwd["fwd_cite"] = df_fwd["fwd_cite"].fillna(0).astype(int)df_all = df_all.merge(df_fwd, left_on=["patent_id", "apply_year"], right_on=["patent_id", "cite_year"], how="left")df_all["fwd_cite"] = df_all["fwd_cite"].fillna(0).astype(int)print(">>> 步骤8: 保存结果...")firm_cktb.to_csv("firm_cktb_2010_2012_python.csv", index=False)# Stata 格式(version=118 支持 UTF-8 中文)firm_cktb.to_stata("firm_cktb_2010_2012_python.dta", version=118, variable_labels={"firm_id": "股票代码", "year": "年份","CKTB": "熵权法综合得分", "n_patents": "专利数量","ipc_cover": "IPC覆盖", "CKTB_Top10": "Top10%专利数"})print("已保存:firm_cktb_2010_2012_python.csv 和 firm_cktb_2010_2012_python.dta")print("\n===== 按年份统计 =====")yearly = firm_cktb.groupby("year").agg( 企业数=("firm_id", "count"), 均值_CKTB=("CKTB", "mean"), 标准差_CKTB=("CKTB", "std"), 均值_专利数量=("n_patents", "mean")yearly["均值_CKTB"] = yearly["均值_CKTB"].round(4)yearly["标准差_CKTB"] = yearly["标准差_CKTB"].round(4)yearly["均值_专利数量"] = yearly["均值_专利数量"].round(1)print(yearly.to_string(index=False))print("\n===== CKTB Top10 企业(2012 年)=====")top_firms = firm_cktb[firm_cktb["year"] == 2012].nlargest(10, "CKTB")top_firms["CKTB"] = top_firms["CKTB"].round(4)print(top_firms.to_string(index=False))
变量说明
最终输出的企业-年度面板数据包含以下变量:
变量名 = c("firm_id", "year", "CKTB", "n_patents", "ipc_cover", "CKTB_Top10"),"当年专利跨越的 IPC 部(section)数量","得分位于前 10% 的关键核心技术专利数量(稳健性检验)"把上市公司专利数据替换成全部年份的就可以计算全部结果了~
如何参加课程?
购买 RStata 名师讲堂会员即可参加该课程啦(之前的和未来的都可以参加)!
价格:2800/年 或者 4800/长期
购买会员可以从这里下单:https://rstata.duanshu.com/#/card/list/
名师讲堂会员权益:
- 参加平台上的其他 R 语言和 Stata 的课程;
- 以会员折扣价购买我们分享的数据资料(10 元/份);
* 如果发票可添加小编微信 r_stata2 (RStata 李老师)开具。如需数据资料,购买后可添加小编微信免费领取数据折扣卡。
更多关于 RStata 会员的更多信息可添加微信号 r_stata2 咨询:
课程主页(点击文末的阅读原文即可跳转):https://rstata.duanshu.com/#/brief/course/11a0e54fff2447f4a0d1542a30f4e8eb