第一章 Linux Block Layer 演进背景
1.1 单队列 Block Layer 的性能瓶颈
早期 Linux Block Layer 使用单请求队列(Single Queue)模型。所有 IO 请求都会进入 request_queue,然后由 block layer 排序、合并、调度,最后交给底层存储驱动。对于传统机械硬盘时代,这种模型已经足够,因为 HDD 本身随机访问延迟极高,IOPS 通常只有几百。
Application ↓VFS ↓Filesystem ↓Block Layer ↓Single Request Queue ↓SATA/SCSI Driver ↓Disk
但 SSD 与 NVMe 出现后,存储性能发生巨大变化。现代 NVMe SSD 单盘即可达到数十万甚至百万 IOPS,而 Linux 单队列模型开始暴露严重问题:
全局 request_queue 锁竞争CPU cacheline bouncing软中断集中NUMA 跨核访问单队列调度瓶颈
尤其在多核服务器中,大量 CPU 同时提交 IO,会竞争同一个 request_queue spinlock,导致 CPU 大量时间浪费在锁等待上,而不是实际 IO,这也是 Linux Block Layer 必须重构的根本原因。
1.2 blk-mq 的设计目标
Linux 在 3.13 内核正式引入 blk-mq(Block Multi Queue)架构。其核心目标是:
消除全局锁提升多核扩展性降低 cache contention支持 NVMe 并行队列减少 IO completion 延迟提升 NUMA locality
blk-mq 本质上是将:单 request_queue拆分为:
per-CPU software queue + hardware dispatch queue
典型的结构:
CPU0 → SW Queue0 → HW Queue0CPU1 → SW Queue1 → HW Queue1CPU2 → SW Queue2 → HW Queue2
这样不同 CPU 提交 IO 时不再竞争同一把锁,而是使用本地 software queue,大幅提高并发能力,现代 Linux NVMe、SCSI、virtio-blk、MMC、loop 等驱动,基本都已经全面切换至 blk-mq。
第二章 blk-mq 整体架构
2.1 blk-mq 分层模型
blk-mq 整体架构可以分为:
Bio Layer ↓Request Layer ↓blk-mq Software Queue ↓blk-mq Hardware Queue ↓Driver Dispatch ↓Storage Device
Linux block layer 中最核心的数据结构包括:
biorequestblk_mq_ctxblk_mq_hw_ctxrequest_queue其中:bio → 文件系统提交的块 IOrequest → block layer 调度后的请求blk_mq_ctx → software queue contextblk_mq_hw_ctx → hardware queue context传统 block layer 最大问题是:多个 CPU ↓竞争同一个 request_queue而 blk-mq 中:每 CPU 拥有独立 ctx从而避免全局锁竞争。
2.2 Software Queue 与 Hardware Queue
blk-mq 中最重要的设计,是 software queue 与 hardware queue 分离,Software Queue:
Hardware Queue:
对应真实硬件 dispatch queue面向 driver负责真正下发 IO
例如 NVMe SSD 通常支持:64/128/256 submission queue
Linux blk-mq 会将 hardware queue 映射到 NVMe queue pair,整体路径:
CPU Core ↓blk_mq_ctx ↓blk_mq_hw_ctx ↓Driver Queue ↓NVMe SQ
这种设计极大提高了 SMP scalability。
第三章 blk-mq 核心数据结构
3.1 request_queue 结构解析
Linux block layer 核心结构仍然是 request_queue,典型定义:
struct request_queue { struct blk_mq_tag_set *tag_set; struct blk_mq_hw_ctx **queue_hw_ctx; unsigned int nr_hw_queues; struct elevator_queue *elevator;};其中:tag_set → blk-mq tag 管理queue_hw_ctx → hardware queue 数组nr_hw_queues → hardware queue 数量elevator → IO scheduler
blk-mq 本质上仍然围绕 request_queue 运作,只是内部实现已经完全多队列化。
3.2 blk_mq_ctx 与 blk_mq_hw_ctx
blk_mq_ctx 表示 software queue:
struct blk_mq_ctx { struct lock_list wait; struct request_list rq_lists; unsigned int cpu;};
每个 CPU 通常对应一个 ctx,blk_mq_hw_ctx 表示 hardware queue:
struct blk_mq_hw_ctx { struct request_queue *queue; struct blk_mq_ctx **ctxs; unsigned int nr_ctx; spinlock_t lock;};它负责:dispatch requesttag allocationdriver interactioncompletion
Linux 会根据:CPU topology NUMA 设备 queue 数量自动建立 ctx 与 hctx 映射关系。
第四章 blk-mq IO 提交流程
4.1 bio 到 request 转换
Linux 文件系统提交 IO 时,首先产生 bio:submit_bio(bio);,随后 block layer 会将 bio 转换为 request:
bio ↓blk_mq_submit_bio() ↓blk_mq_get_request() ↓request allocation
request 本质上是:多个 bio 的聚合,Linux 仍然会尝试:merge plug reorder 以提高 IO 效率。
4.2 request dispatch 流程
request 创建后,会进入 software queue:blk_mq_ctx随后 dispatch到:blk_mq_hw_ctx最终调用 driver:queue_rq(hctx, &bd);driver实现:
staticblk_status_tnvme_queue_rq( struct blk_mq_hw_ctx *hctx, const struct blk_mq_queue_data *bd){ ...}
这里真正完成:
DMA setupdescriptor filldoorbell notify
最终 IO 被送入硬件。
第五章 Tag 机制解析
5.1 blk-mq Tag 的作用
blk-mq 中最关键的机制之一是 tag,传统 block layer 使用 request pointer 跟踪 IO,而 blk-mq 使用:整数 tag 标识 request,比如:
Request #15Request #16Request #17
每个 tag 对应:硬件队列中的唯一 slot,这与 NVMe command ID 十分类似,Linux 使用:struct blk_mq_tags管理 tag bitmap。
5.2 Tag Allocation 流程
request 分配时:blk_mq_get_tag()会从 bitmap 中寻找空闲 tag。典型流程:
CPU Submit IO ↓Allocate Tag ↓Bind Request ↓Driver Queue ↓Completion ↓Free Tag
tag 的意义非常重要:
避免 request 动态查找提高 completion 效率减少锁竞争支持高并发
现代 NVMe 高性能,很大程度上依赖 tag-based queue model。
第六章 blk-mq 与 NVMe
6.1 NVMe Queue Pair 架构
NVMe 天然适合 blk-mq,NVMe 本身采用:
Submission QueueCompletion Queue模型:CPU0 → SQ0/CQ0CPU1 → SQ1/CQ1CPU2 → SQ2/CQ2blk-mq 与 NVMe 的对应关系:blk_mq_hw_ctx ↔NVMe Queue Pair
所以Linux blk-mq 与 NVMe 几乎是完美匹配。
6.2 NVMe IO 路径
典型 NVMe blk-mq 路径:
submit_bio ↓blk_mq_submit_bio ↓blk_mq_get_request ↓nvme_queue_rq ↓Fill NVMe Command ↓Write SQ Tail Doorbell ↓Controller Fetch Command
完成的路径:
NVMe Completion ↓MSI-X Interrupt ↓nvme_irq ↓blk_mq_complete_request ↓bio_endio
整个路径几乎完全 lockless。
第七章 IO Scheduler 与 blk-mq
7.1 blk-mq 调度器架构
传统 block layer 调度器包括:CFQ Deadline NOOP
blk-mq 出现后,Linux 重写了 scheduler framework,当前主要包括:mq-deadline,kyber,bfq,none这里:none通常用于 NVMe。
7.2 mq-deadline 工作机制
mq-deadline 本质上是:deadline scheduler 的 blk-mq 版本,核心目标是降低 starvation 控制 latency 维持公平性,它会维护:
read queuewrite queuedeadline timer
当 IO 超时强制 dispatch,避免写请求长期饿死读请求。
但对于高性能 NVMe很多场景直接使用 none,因为 SSD 本身已经拥有复杂内部调度。
第八章 blk-mq Completion 机制
8.1 IO Completion 路径
blk-mq completion 核心路径:
Device Complete ↓MSI-X IRQ ↓Driver ISR ↓blk_mq_complete_request() ↓Complete request ↓Wakeup bio
completion 通常运行在本地 CPU从而提高 cache locality。
8.2 SoftIRQ Completion 模型
Linux completion 可能运行在:
hardirqsoftirqtask contextblk-mq 支持:direct completionsoftirq completionpoll completion例如:IOPOLL模式下:CPU busy poll CQ避免中断开销。
这样对于 ultra-low-latency NVMe 非常重要。
建了一个嵌入式Linux技术群,专门聊难题分析和求职面试,欢迎大家一起加入,共同解决工作中的疑难杂症问题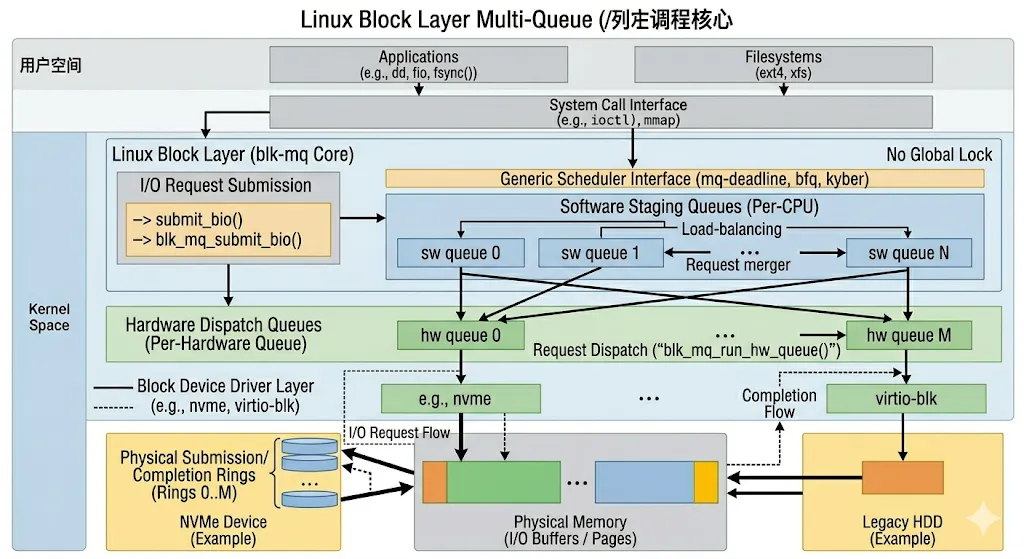
 10个月宝宝每天需要喝多少奶粉?