Linux:文本处理三驾马车 保姆级速成笔记
- 2026-10-11 07:36:16
Linux:文本处理三驾马车 保姆级速成笔记
注:所有学习材料来自生信技能树(卖萌哥主讲,豆包整理补充,纯实战导向)
~~~内容比较详细,自己使用为主!!
一、本节课核心目标
✅ 看懂生信三大核心数据格式(fasta/fastq/gtf)的结构 ✅ 熟练使用grep进行文本搜索和筛选 ✅ 掌握sed进行文本替换、删除、插入 ✅ 学会awk进行按列处理和简单计算 ✅ 能独立完成课件中的所有课堂练习
"这节课是生信Linux的分水岭,学会了三驾马车,就能处理90%的测序数据文本问题;学不会,后面的转录组分析寸步难行。"
二、前置知识:生信三大核心数据格式(必须先看懂)
所有文本处理命令都是针对这些格式设计的,先搞懂格式,再学命令。
1. FASTA格式(.fa/.fasta):存储序列
用途:存储基因组、转录组、蛋白序列
特征:两部分,Id行和序列行
结构:
第一行:以 >开头,是序列的ID和描述信息第二行及以后:序列本身(ATCGN/氨基酸):一个字母表示一个碱基或氨基酸
示例:
>gi|556503834|ref|NC_000913.3| Escherichia coli str. K-12 substr. MG1655, complete genome
AGCTTTTCATTCTGACTGCAACGGGCAATATGTCTCTGTGTGGATTAAAAAAAGAGTGTCTGATAGCAGC
TTCTGAACTGGTTACCTGCCGTGAGTAAATTAAAATTTTATTGACTTAGGTCACTAAATACTTTAACCAA
查看命令:
less -S Data/example.fa
2. FASTQ格式(.fq/.fastq):存储测序数据
用途:存储二代测序的原始reads和质量值
结构:每4行代表一条reads(生信人刻进DNA的知识点)
第1行:以 @开头,reads的ID和描述第2行:测序序列(ATCGN) 第3行:以 +开头,可重复ID或留空第4行:质量值(和第2行长度一一对应)长度必须与第二行相同
示例:
@ERR329499.1 HWUSI-EAS697:8:115:13414:19955#ACAGTG/1
AAAAAATTGGTGTTATAAGACTTCTGGACCCTGAAGATGTCGATGTCTCCTCACCTGATGAAAAATCAGT
+
FFFFFFFFFFIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIIII
核心计算:
总reads数 = 总行数 ÷ 4 命令: zcat reads.1.fq.gz | wc -l | awk '{print $1/4}'
3. GTF格式(.gtf):存储基因注释信息
用途:存储基因、转录本、外显子、CDS等的位置信息
总共有9列
结构:制表符分隔的9列,每一行代表一个特征
#开头的是注释信息,包括版本,构建时间,上市时间
查看命令(生信标准写法):
# 单行显示+列对齐,不会乱成一团
less -S Data/example.gtf | column -t | less -S
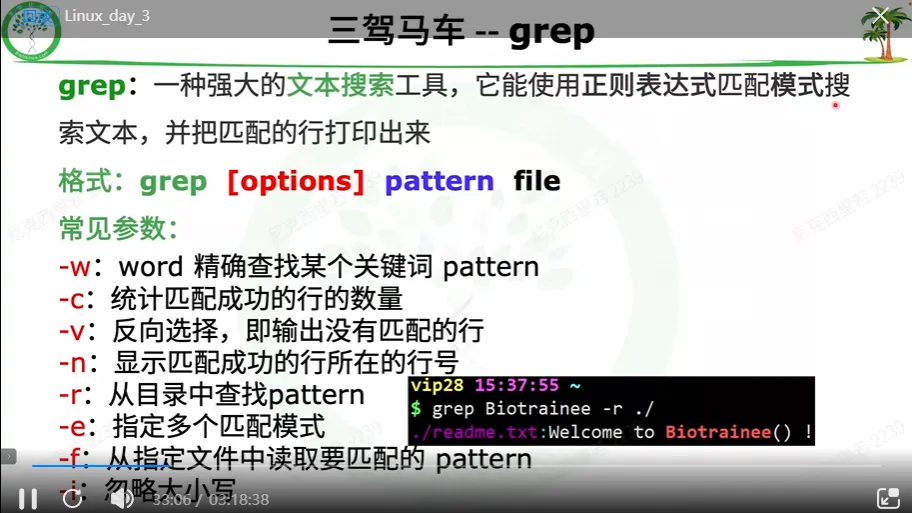
三、文本处理三驾马车之1:grep(文本搜索筛选)
英文全称:Global Regular Expression Print
作用:在文本中搜索匹配指定模式的行,并打印出来
✅ 生信中用得最多的命令,没有之一!
1. 基本语法
grep [选项] 搜索模式 文件名
# 管道符用法(最常用)
cat 文件名 | grep [选项] 搜索模式
less 文件名 | grep [选项] 搜索模式
2. 核心常用参数(必须全部背下来)
-w | gene不会匹配到gene_id | |
-c | ||
-v | ||
-n | ||
-e | ||
-f | ||
-i |
3. 老师课堂演示的所有实战例子
# 1. 搜索包含"Biotrainee"的文件(递归搜索当前目录下所有文件)
grep Biotrainee -r ./

# 2. 搜索gtf中所有包含"gene"的行(❌ 错误:会匹配到gene_id)
less Data/example.gtf | grep 'gene'

# 3. 精确匹配"gene"单词(✅ 正确:只匹配feature列的gene)
less Data/example.gtf | grep -w 'gene'

# 4. 统计gtf中基因的总数(最常用)
less Data/example.gtf | grep -w -c 'gene'
# 输出:20

# 5. 反向匹配:输出所有不是gene的行
less Data/example.gtf | grep -w -v 'gene'

# 6. 同时匹配多个模式:搜索gene和UTR
less Data/example.gtf | grep -w -e 'gene' -e 'UTR'

# 7. 从文件中读取搜索模式:批量搜索file文件中的所有关键词
vim pattern
cat file
# gene
# start_codon
# stop_codon
less Data/example.gtf | grep -w -f file
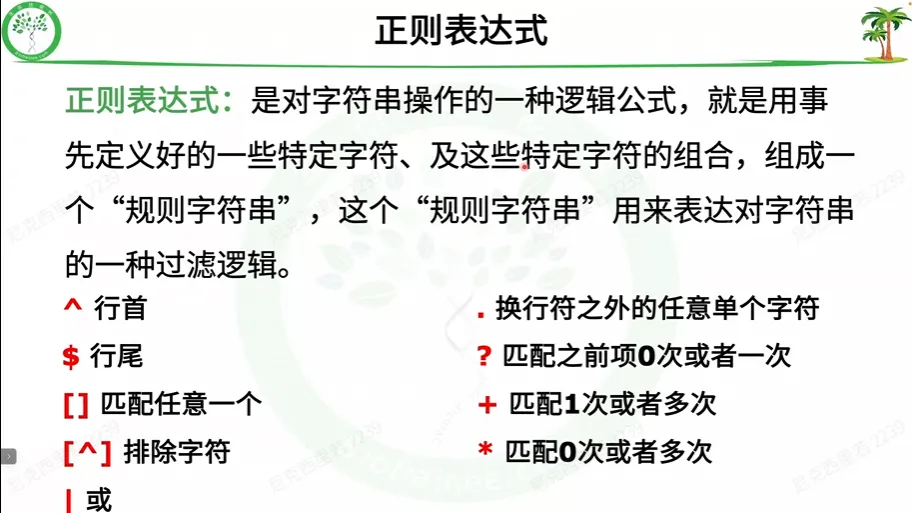
4. 基础正则表达式(grep的灵魂)
正则表达式是用来描述字符串模式的公式,grep、sed、awk都支持。
^ | grep '^T' readme.txt | ||
$ | grep ')$' readme.txt | ||
. | grep 'f.ee' readme.txt | ||
* | grep 'f*ee' readme.txt | ||
+ | grep 're\+' readme.txt | ||
? | grep 'f\?ee' readme.txt | ||
[] | grep '[bB]' readme.txt | ||
[^] | grep '[^t]' readme.txt | ||
⚠️ 注意:在grep中,+、?、|需要加反斜杠转义,或者使用grep -E(扩展正则表达式)。
四、文本处理三驾马车之2:sed(流编辑器)
英文全称:Stream Editor
作用:对文本进行逐行处理,包括插入、删除、替换、修改
✅ 生信中主要用来批量替换文本、删除指定行、提取指定行
1. 基本语法
sed [选项] '脚本' 文件名
# 管道符用法
cat 文件名 | sed [选项] '脚本'
2. 脚本格式
[地址范围][!] 命令 [内容]
地址范围:指定要处理哪些行,不写则处理所有行 **!**:取反,处理不匹配地址范围的行 命令:要执行的操作(a/i/d/c/s/p等)
3. 常用地址范围写法
2 | |
2,4 | |
2,$ | |
2~3 | |
/pattern/ |
4. 核心常用命令
a | sed '1a 新内容' file | |
i | sed '1,2i 新内容' file | |
d | sed '1,3d' file | |
c | sed '2,4c 新内容' file | |
s | sed 's/旧字符串/新字符串/g' file | |
p | sed -n '2,4p' file |
5. 老师课堂演示的所有实战例子
# 1. 在第1行后面追加一行"Welcome to Biotrainee()"
cat readme.txt | sed '1a Welcome to Biotrainee()'

# 2. 在第1到第2行前面各插入一行"Welcome to Biotrainee()"
cat readme.txt | sed '1,2i Welcome to Biotrainee()'

# 3. 删除第1到第3行
cat readme.txt | sed '1,3d'

# 4. 把第2到第4行替换成一行"***********"
cat readme.txt | sed '2,4c ***********'

# 5. 替换字符串:把所有"is"替换成"IS"(g表示全局替换)
cat readme.txt | sed 's/is/IS/g'

# 6. 只替换每一行的第2个"is"
cat readme.txt | sed 's/is/IS/2'

# 7. 只替换第1行的"ee"为"EE"
cat readme.txt | sed '1s/ee/EE/'

# 8. 每隔3行替换一次"ee"为"EE"
cat readme.txt | sed '1~3s/ee/EE/'

# 9. 只替换包含"www"的行中的"ee"为"EE"
cat readme.txt | sed '/www/ s/ee/EE/'

# 10. 字符转换:把所有小写abcde转换成大写ABCDE
cat readme.txt | sed 'y/abcde/ABCDE/'

# 11. 打印包含"ee"的行(类似grep)
cat readme.txt | sed -n '/ee/p'
⚠️ 重要警告:sed -i会直接修改原文件!没有回收站!修改前一定要备份!
# 错误:直接修改原文件,无法恢复
sed -i 's/is/IS/g' readme.txt

# 正确:先备份原文件,再修改
sed -i.bak 's/is/IS/g' readme.txt
# 会生成readme.txt.bak备份文件
五、文本处理三驾马车之3:awk(按列处理神器)
作用:按列处理文本,支持条件判断、循环、数学运算,是一个小型编程语言
✅ 生信中最强大的文本处理工具,没有之一!所有表格类数据(gtf/bed/vcf)都用awk处理
1. 基本语法
awk [选项] '{脚本}' 文件名
# 管道符用法
cat 文件名 | awk [选项] '{脚本}'
2. 核心内置变量(必须背下来)
$0 | |
$1 | |
$2 | |
$NF | |
NR | |
FS | |
OFS |
3. 三种脚本结构
(1)基础结构:逐行处理
awk '{print $1, $3}' file
# 打印每一行的第1列和第3列
(2)条件结构:只处理匹配条件的行
awk '/pattern/ {print $0}' file
# 只打印匹配pattern的行
(3)三段式结构(最强大)
awk 'BEGIN{预处理} {逐行处理} END{后处理}' file
BEGIN{}:在处理第一行之前执行,只执行一次,用来设置变量、打印表头{}:逐行处理,每一行执行一次END{}:在处理完所有行之后执行,只执行一次,用来统计、打印结果
4. 老师课堂演示的所有实战例子
# 1. 提取gtf的第9列(属性列)
less -S Data/example.gtf | awk '{print $9}'

# 2. 提取gtf的第1列、第3列、第4列、第5列
less -S Data/example.gtf | awk '{print $1, $3, $4, $5}'

# 3. 设置输出分隔符为冒号
less -S Data/example.gtf | awk 'BEGIN{OFS=":"} {print $3, $4, $5}'

# 4. 打印行号和第9列
less -S Data/example.gtf | awk '{print NR, $9}'

# 5. 只打印feature是UTR的行(类似grep -w UTR)
less -S Data/example.gtf | awk '$3=="UTR" {print $0}'

# 6. 三段式示例:打印表头,然后打印所有UTR行,最后打印"end"
less -S Data/example.gtf | awk 'BEGIN{print "find UTR feature"} $3=="UTR" {print $0} END{print "end"}'

# 7. 条件判断:如果是gene,打印整行;否则打印"xxx is not gene"
less -S Data/example.gtf | awk '{if($3=="gene") {print $0} else {print $3, "is not gene"}}'

# 8. 数学运算:计算每个外显子的长度(end - start + 1)
less -S Data/example.gtf | awk '$3=="exon" {print $5 - $4 + 1}'

# 9. 计算所有外显子的总长度
less -S Data/example.gtf | awk '$3=="exon" {sum += $5 - $4 + 1} END{print "Total exon length:", sum}'
六、Linux常见符号与通配符
# | # 这是一行注释 | |
\ | echo \$PATH | |
> | ls > file.txt | |
>> | ls >> file.txt | |
. | ./run.sh | |
.. | cd .. | |
~ | cd ~ | |
'' | echo '$PATH' | |
"" | echo "$PATH" | |
$() | echo "今天是$(date)" |
七、课堂练习 逐题详细解答(必须全部做一遍)
练习1:grep相关
统计example.gtf中有多少个gene
less Data/example.gtf | grep -w -c 'gene'
统计example.gtf中有多少个exon
less Data/example.gtf | grep -w -c 'exon'
提取example.gtf中所有CDS和UTR的行
less Data/example.gtf | grep -w -e 'CDS' -e 'UTR'
提取example.fq中所有以@开头的行(reads ID)
less Data/example.fq | grep '^@'
统计example.fq中有多少条reads
less Data/example.fq | grep -c '^@'
# 或者
wc -l Data/example.fq | awk '{print $1/4}'
练习2:sed相关
查看example.gtf的前10行
head -n 10 Data/example.gtf
# 或者用sed
sed -n '1,10p' Data/example.gtf
把example.gtf中所有的"HAVANA"替换成"ENSEMBL"
sed 's/HAVANA/ENSEMBL/g' Data/example.gtf
把example.fa的第2行及以后的所有小写字母转换成大写
sed '2,$ y/atcgn/ATCGN/' Data/example.fa
处理md5.txt文件,提取所有fastq文件名和对应的md5值
sed 's/;/\n/g' md5.txt | grep -E 'fastq.gz|^[a-z0-9]{32}'
提取reads.1.fq.gz的第40行
zcat reads.1.fq.gz | sed -n '40p'
练习3:awk相关
查看example.gtf的前10行
less Data/example.gtf | awk 'NR<=10 {print $0}'
提取example.gtf中所有source是ENSEMBL的行
less Data/example.gtf | awk '$2=="ENSEMBL" {print $0}'
从gtf的第9列中提取gene_id和transcript_id,以及gene_type
less Data/example.gtf | awk '{
    match($0, /gene_id "([^"]+)"/, g);
    match($0, /transcript_id "([^"]+)"/, t);
    match($0, /gene_type "([^"]+)"/, gt);
    print g[1], t[1], gt[1]
}'
八、新手必踩的10个坑
❌ grep gene会匹配到gene_id,一定要加-w精确匹配❌ sed -i直接修改原文件,没有备份,一定要先备份❌ awk的字段分隔符默认是空白字符,gtf的第9列有空格,不能直接用 $9提取gene_id❌ 正则表达式中的特殊字符(如 +、?、|)需要转义❌ 重定向 >会覆盖原文件,追加要用>>❌ 单引号和双引号搞混,单引号不解析变量,双引号解析 ❌ fastq文件行数除以4才是reads数,不要直接用行数 ❌ gtf的起始位置是从1开始,不是从0开始 ❌ awk的条件判断用 ==,不是=(=是赋值)❌ 忘记加管道符 |,命令不生效
九、核心命令速查表(打印出来贴电脑上)
grep | grep -w 'gene' file | |
grep -c 'gene' file | ||
grep -v 'gene' file | ||
sed | sed 's/old/new/g' file | |
sed '1,3d' file | ||
sed -n '2,4p' file | ||
awk | awk '{print $1,$3}' file | |
awk '$3=="gene" {print $0}' file | ||
awk '{sum+=$5-$4} END{print sum}' |
十、第四天上课前的学习建议
先把上面的所有例子都复制到终端里跑一遍,看输出结果,理解每个命令的作用 独立完成所有课堂练习,不要看答案,做错了再对照 重点掌握grep和awk,sed可以先掌握替换和删除,其他的以后再学 把速查表打印出来,忘了就看一眼,不用死记硬背 遇到问题先看报错信息,大部分报错都写得很清楚
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:596563534@qq.com 。
