Python爬虫入门连载08:基础反爬绕过——伪装浏览器、延时访问、简单防盗链处理
很多新手写爬虫经常遇到这些问题:
·代码一运行就访问被拒绝
·直接返回空白页面
·频繁请求后被封IP
·图片爬取下不来、显示防盗链
不是你代码写错了,是网站有基础反爬机制,识别出你是爬虫,故意拦截。今天教你新手必会的3招基础反爬绕过,学会之后,90%普通网站都能正常爬,再也不会轻易被拦。
一、网站为什么能识别你是爬虫?
1.没有浏览器身份标识,一眼认出是代码请求
2.访问速度太快,一秒刷好几页,不像正常人浏览
3.爬图片没有来路标识,触发防盗链拦截
4.没有Cookie会话,直接裸奔访问
我们就针对性一一伪装、绕过。
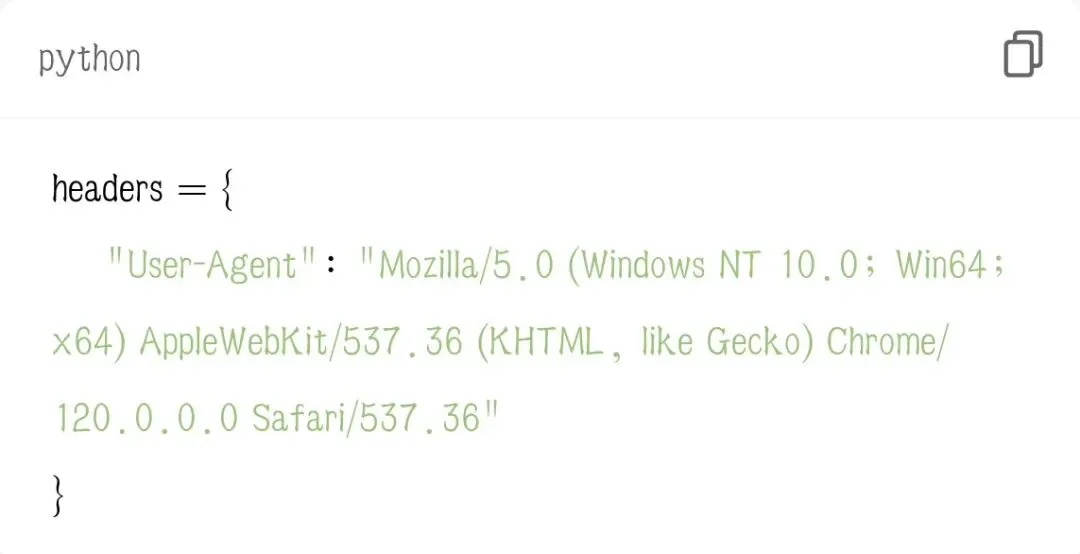
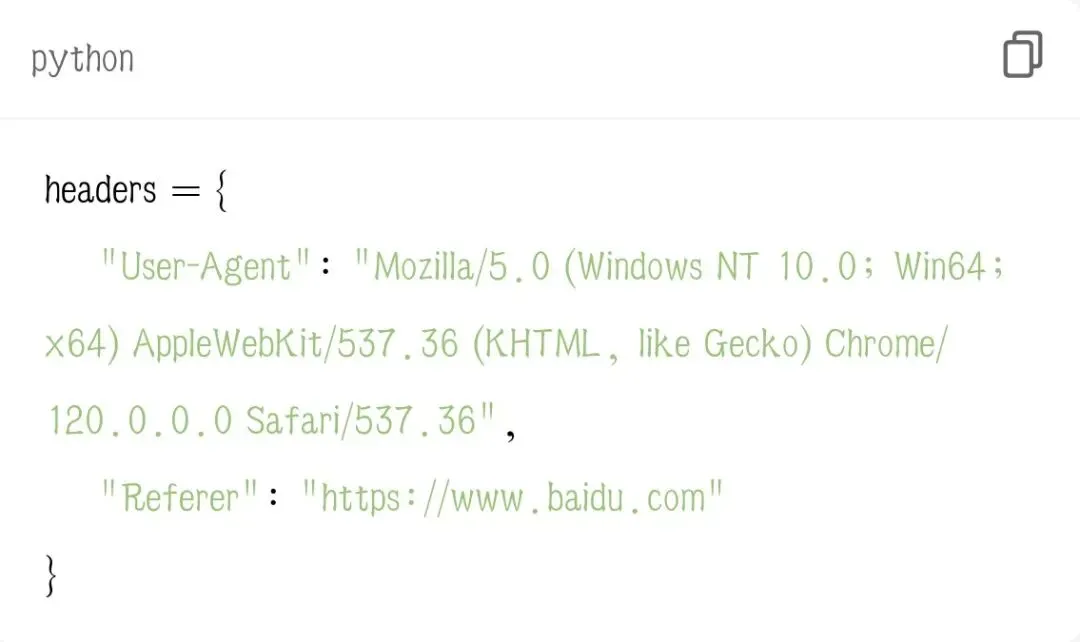
二、第一招:User-Agent 伪装成浏览器(必加)
什么是User-Agent相当于网络身份证,告诉网站:我是Chrome浏览器,不是爬虫程序。标准通用UA(直接复制用)
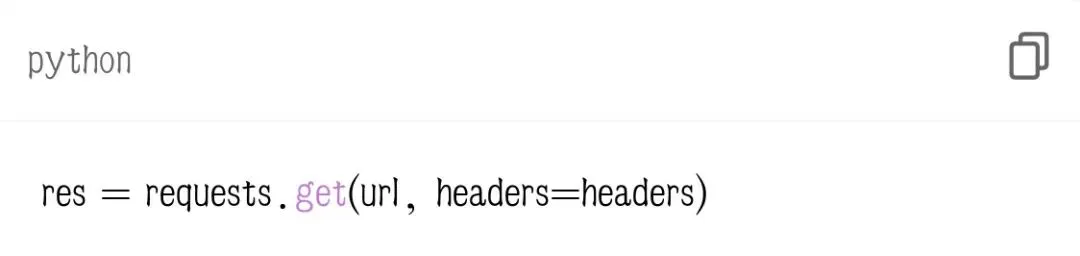
使用方式
每次发请求都带上 headers:
从今天起,所有爬虫默认都加UA,养成习惯。
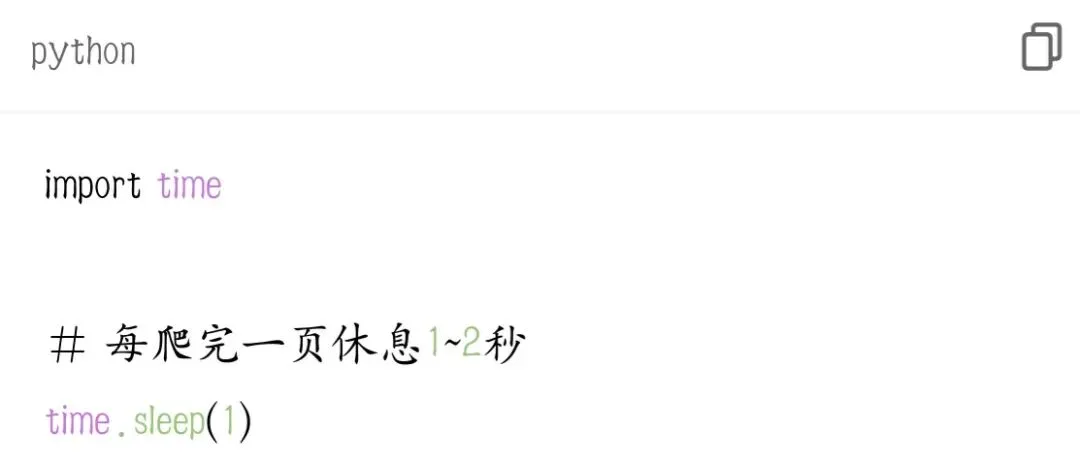
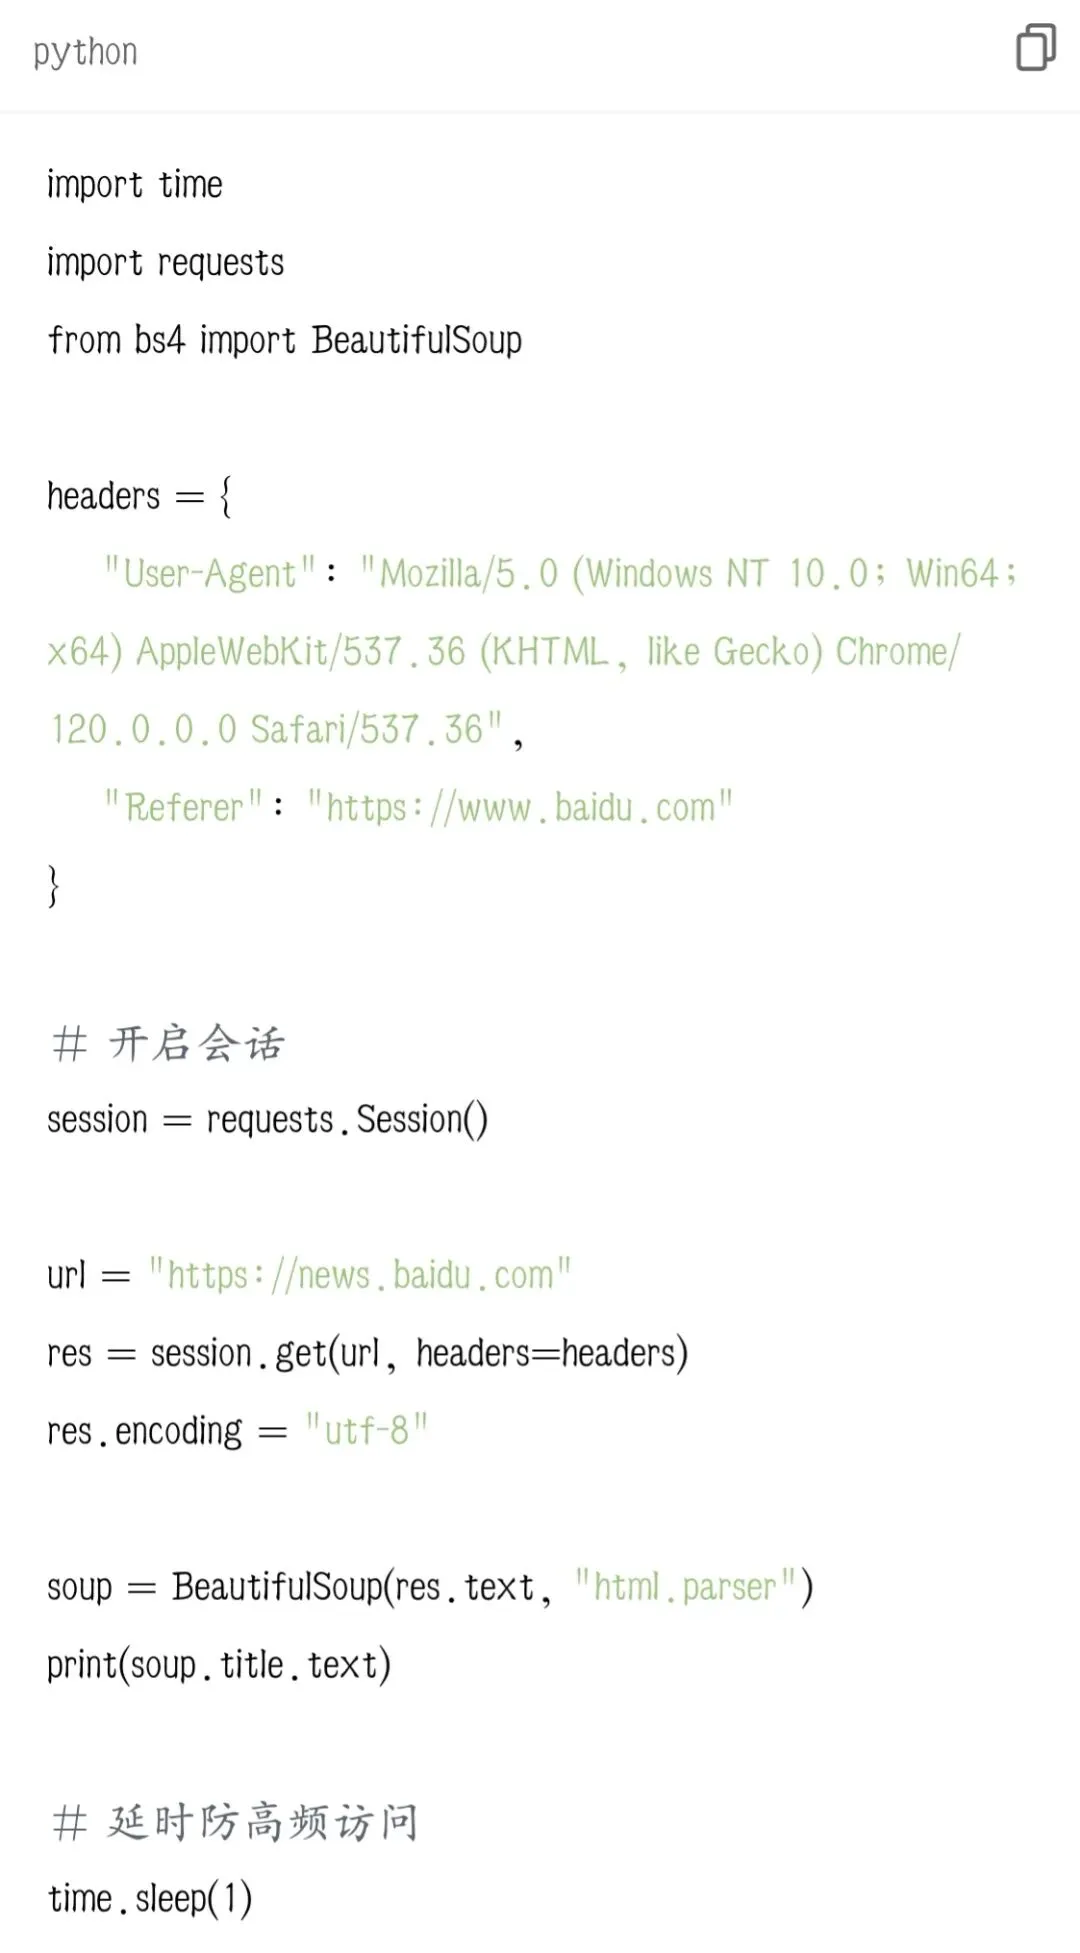
人看网页不会秒切下一页,爬虫循环太快容易被封IP。用 time.sleep() 加延时,礼貌间隔请求。
用法示例
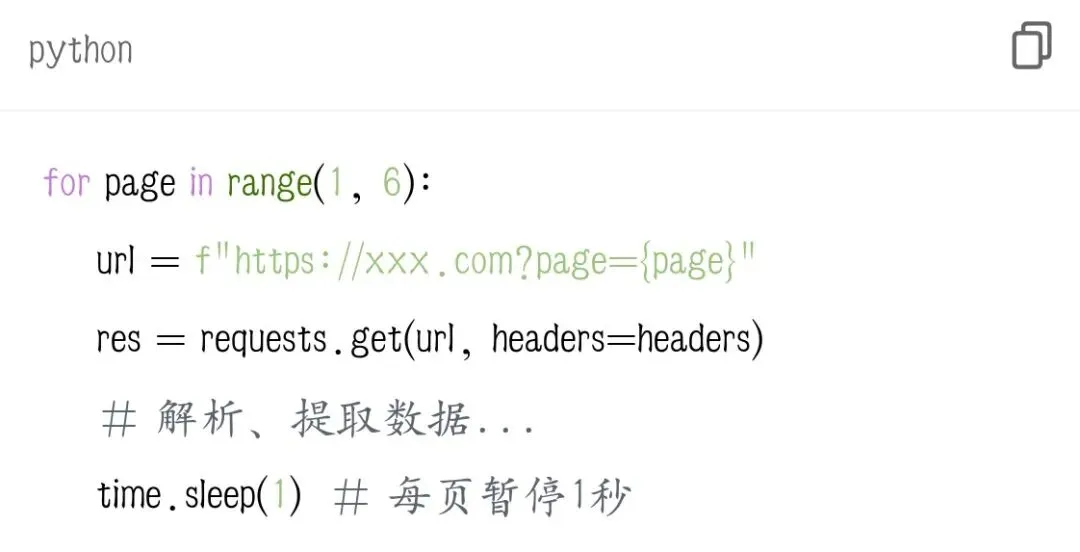
分页爬虫标准写法
建议:普通网站延时1秒,严格网站延时2~3秒。很多图片站有防盗链,不带Referer直接403,图片下载失败。加一个 Referer 请求头,告诉网站:我从你本站跳转过来的,不是盗爬。带Referer完整请求头
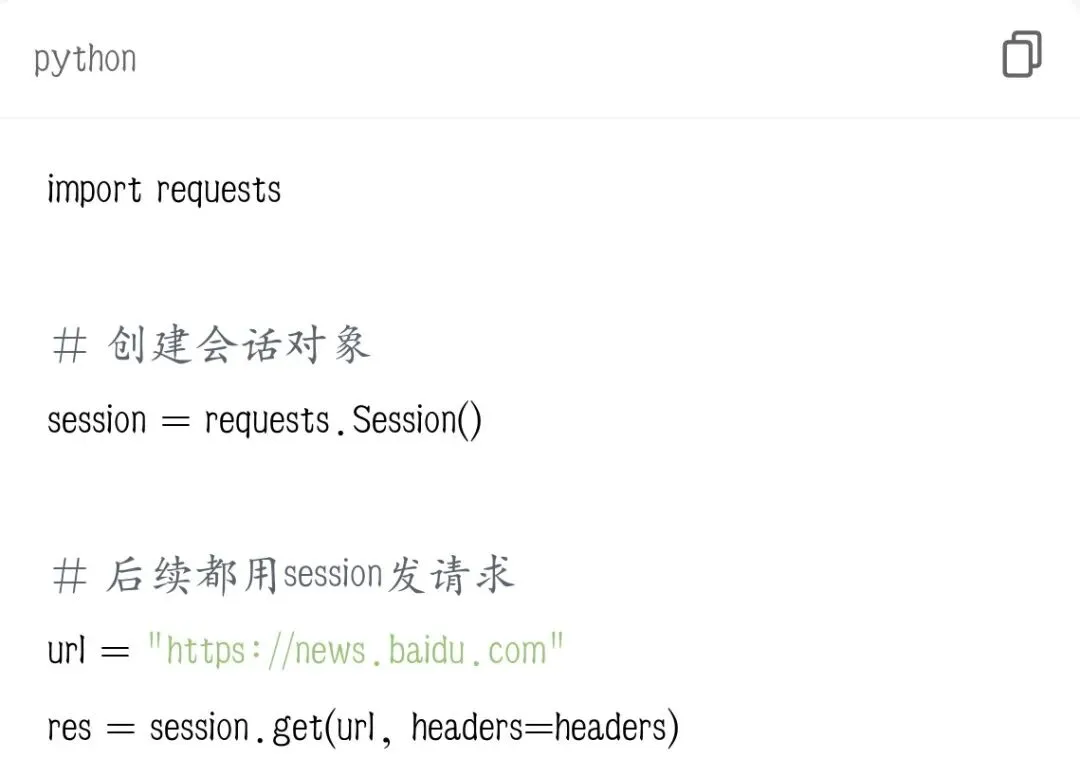
Referer可以填目标网站域名,也可以填百度首页通用兜底。用 requests.Session() 创建会话,自动携带Cookie,像浏览器一样保持登录状态、访问痕迹。会话用法
优点:自动保存Cookie,连续访问更稳定,不容易被识别。
七、新手反爬必记口诀
1.必加User-Agent,伪装成浏览器
2.必加time.sleep,放慢访问节奏
3.爬图片加Referer,绕过防盗链
4.频繁访问用Session会话,保持Cookie
5.不疯狂爬大量页数,低调合规最安全
八、法律与合规再次提醒
只爬公开、非涉密、非隐私普通网页;
不爬登录才能看的数据、不爬付费资源、不恶意高频请求压垮服务器。
学习练手完全没问题,商用需谨慎。
本期小结
1.User-Agent 伪装浏览器身份,基础反爬第一步
2.time.sleep 延时访问,防封IP
3.Referer 解决图片防盗链下载失败
4.Session 会话保持Cookie,访问更稳定
5.四招学会,日常爬虫基本不会被拦截
小作业
把你之前写的新闻爬虫、图片爬虫,全部加上:UA请求头 + 每页延时1秒,测试是否更稳定。
下期预告
Python爬虫连载09:综合实战项目——新闻自动采集并保存Excel完整项目整合前面所有知识点:请求、解析、分页、反爬伪装、存入Excel,做一个可直接复用的完整新闻采集系统!