由于借助 AI 工具学习编程已经变得非常容易了,因此之后的课程就不再默认进行视频讲解了,如果特别需要视频讲解也可以联系李老师预约讲解~讲义材料学习过程中遇到的问题也可以及时与李老师联系。
购买 RStata 名师讲堂会员即可参加该课程啦(之前的和未来的都可以参加)!
价格:2800/年 或者 4800/长期
购买会员可以从这里下单:https://rstata.duanshu.com/#/card/list/
名师讲堂会员权益:
- 参加平台上的其他 R 语言和 Stata 的课程;
- 以会员折扣价购买我们分享的数据资料(10 元/份);
* 如果发票可添加小编微信 r_stata2 (RStata 李老师)开具。如需数据资料,购买后可添加小编微信免费领取数据折扣卡。
更多关于 RStata 会员的更多信息可添加微信号 r_stata2 咨询:
课程主页(点击文末的阅读原文即可跳转):https://rstata.duanshu.com/#/brief/course/f60028067ed945658184d221dece39b3
今天给大家分享如何使用 Python 测算上市公司技术专业化与技术多样化程度。该方法参考自王慧扬等《知识搜索与科技领军企业关键核心技术突破》,通过变异系数和Shannon 熵指数来分别衡量企业的技术专业化与多样化水平。
附件中提供了该参考文献的 PDF 文件,感兴趣的小伙伴可以阅读原文。
指标来源与计算原理
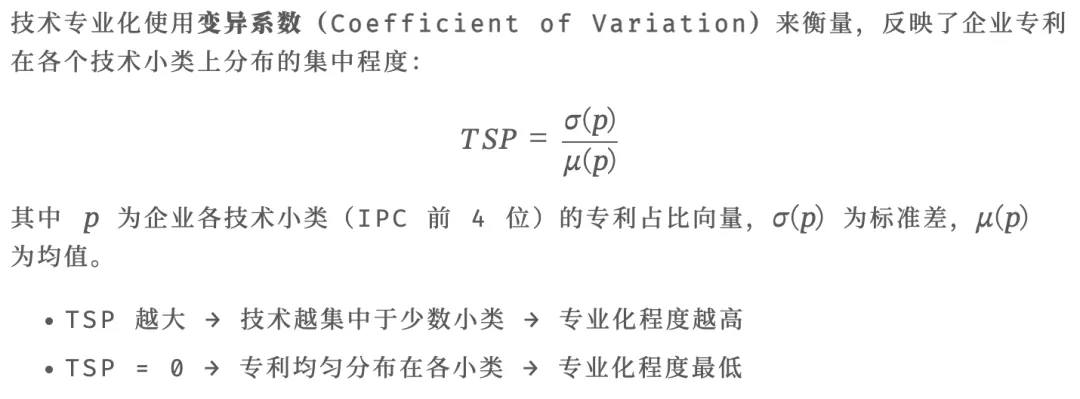
技术专业化(TSP)
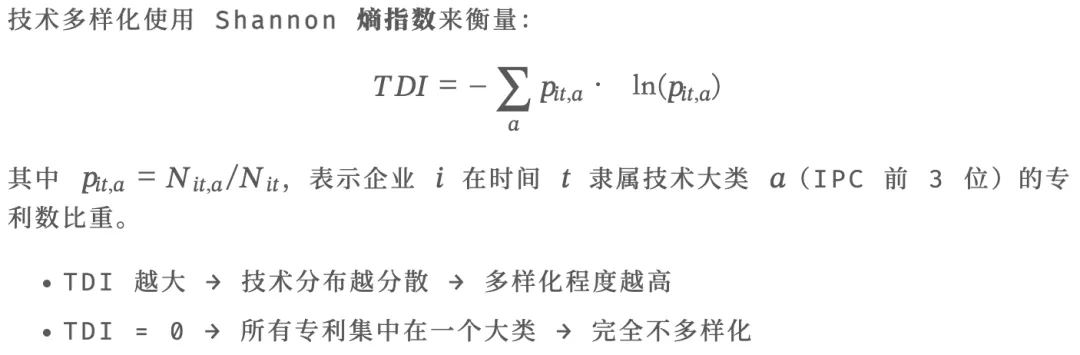
技术多样化(TDI)
计算步骤概述
整个计算过程分为以下几个步骤:
- 数据读取:读取 2020 年上市公司与专利数据匹配结果
- 专利去重:清洗公开公告号并按股票代码+年份+公告号/申请号去重
- IPC 分类提取:提取 IPC 大类(前 3 位)和小类(前 4 位),移除 IPC 为空的记录
- 计算 TSP:基于 IPC 小类专利占比的变异系数
- 计算 TDI:基于 IPC 大类专利占比的 Shannon 熵指数
使用 reticulate 创建与管理 Python 虚拟环境
在 R 中通过 reticulate 包来调用 Python,最好的实践是为项目创建一个专属的 Python 虚拟环境,将所需依赖隔离到独立空间,避免与系统 Python(如 Anaconda)发生版本冲突。
重要说明(避免"已初始化"报错):reticulate 在 R 会话中只能绑定一次 Python——一旦某个 {python} 代码块运行,Python 解释器就被锁定,之后再调用 use_virtualenv() 会报错:
ERROR: The requested version of Python cannot be used, as another version has already been initialized.因此,虚拟环境的激活必须在所有 {python} 代码块之前完成。本文档的解决方案是在 setup chunk 中通过 Sys.setenv(RETICULATE_PYTHON = ...) 提前锁定 Python 路径,这是 reticulate 选取 Python 的最高优先级入口。
安装 reticulate(仅首次)
options(repos = c(CRAN = "https://mirrors.tuna.tsinghua.edu.cn/CRAN/"))if (!requireNamespace("reticulate", quietly = TRUE)) { install.packages("reticulate") message("reticulate 安装完成!") message("reticulate 已安装,版本:", packageVersion("reticulate"))在虚拟环境中安装 Python 包(仅首次)
py_pkgs <- c("numpy", "pandas")installed <- py_list_packages(".venv")$packageneed_install <- setdiff(py_pkgs, installed)if (length(need_install) > 0) { virtualenv_install(".venv", packages = need_install) message("已安装缺失的包:", paste(need_install, collapse = ", ")) message("所有 Python 包已就绪,无需安装")验证激活状态
虚拟环境管理常用命令
详细计算代码
数据读取与预处理
# dtype=str:全部读为字符串,与 R 的 read_csv(cols(.default = "c")) 一致df_2020 = pd.read_csv("2020年上市公司与专利数据匹配结果.csv", dtype=str)print(f"原始数据: {len(df_2020)} 行")专利去重
按照以下步骤进行专利去重(与 R 代码逻辑完全一致):
# Step 1: 清洗公开公告号(去掉末尾字母)# R: str_remove(公开公告号, "[A-Z]$")df_2020["公开公告号_clean"] = df_2020["公开公告号"].str.replace(r"[A-Z]$", "", regex=True)# Step 2: 按 股票代码 + 年份 + 公开公告号_clean 去重# R: distinct(股票代码, 年份, 公开公告号_clean, .keep_all = TRUE)df_2020 = df_2020.drop_duplicates(subset=["股票代码", "年份", "公开公告号_clean"], keep="first")print(f"按公告号去重后: {len(df_2020)} 行")# Step 3: 按 股票代码 + 年份 + 申请号 去重# R: distinct(股票代码, 年份, 申请号, .keep_all = TRUE)df_2020 = df_2020.drop_duplicates(subset=["股票代码", "年份", "申请号"], keep="first")print(f"按申请号去重后: {len(df_2020)} 行")关键函数对照:
| | |
|---|
str_remove(x, "[A-Z]$") | str.replace(r"[A-Z]$", "", regex=True) | |
distinct(..., .keep_all=TRUE) | drop_duplicates(subset=..., keep="first") | |
提取 IPC 分类信息
# 大类(Class): 如 G06, H04(前3位,含部字母+2位数字)# 小类(Subclass): 如 G06F, H04L(前4位,含部字母+3位数字+可能字母)# 技术专业化 → 使用IPC小类(前4位,如G06F)# 技术多样化 → 使用IPC大类(前3位,如G06)na_count = df_2020["IPC主分类"].isna().sum()print(f"IPC主分类的NA值数量: {na_count} (占比{na_count/len(df_2020)*100:.2f}%)")# R: str_sub(IPC主分类, 1, 3) / str_sub(IPC主分类, 1, 4)df_2020["IPC大类"] = df_2020["IPC主分类"].str[:3]df_2020["IPC小类"] = df_2020["IPC主分类"].str[:4]# R: filter(!is.na(IPC大类) & !is.na(IPC小类))df_2020 = df_2020.dropna(subset=["IPC大类", "IPC小类"])print(f"移除IPC为NA后的数据维度: {len(df_2020)} 行")计算技术专业化(TSP)
# 技术专业化:变异系数(Coefficient of Variation)# TSP = 标准差(各技术小类专利占比) / 均值(各技术小类专利占比)# TSP越大 → 技术越集中于少数小类 → 专业化程度越高print(f"技术专业化(TSP)计算完成,共 {len(TSP)} 家企业")print(TSP["TSP"].describe())关键函数对照:
| | |
|---|
group_by() %>% summarise(n()) | groupby().agg(size) | |
sd(x) | x.std() | |
case_when() | np.where() | |
计算技术多样化(TDI)
# TDI = -Σ p_it_a * ln(p_it_a)# TDI越大 → 技术分布越分散 → 多样化程度越高print(f"技术多样化(TDI)计算完成,共 {len(TDI)} 家企业")print(TDI["TDI"].describe())合并结果并保存
# R: inner_join(...) %>% arrange(股票代码) TSP[["股票代码", "技术小类数量", "TSP"]] .merge(TDI[["股票代码", "技术大类数量", "TDI"]], on="股票代码", how="inner") .merge(firm_total_patents, on="股票代码", how="inner")print(f"最终结果: {len(result)} 行, {len(result.columns)} 列")print(result[["TSP", "TDI", "总专利数"]].describe())result.to_csv("技术专业化与多样化_2020年_python.csv", index=False)print("\n结果已保存到: 技术专业化与多样化_2020年_python.csv")结果概览
print("=== 结果预览(前20行) ===")print(result.head(20).to_string(index=False))for col in ["TSP", "TDI", "总专利数"]:print(f" 最小值: {s.min():.4f}")print(f" 25%: {s.quantile(0.25):.4f}")print(f" 中位数: {s.median():.4f}")print(f" 均值: {s.mean():.4f}")print(f" 75%: {s.quantile(0.75):.4f}")print(f" 最大值: {s.max():.4f}")如何参加课程?
购买 RStata 名师讲堂会员即可参加该课程啦(之前的和未来的都可以参加)!
价格:2800/年 或者 4800/长期
购买会员可以从这里下单:https://rstata.duanshu.com/#/card/list/
名师讲堂会员权益:
- 参加平台上的其他 R 语言和 Stata 的课程;
- 以会员折扣价购买我们分享的数据资料(10 元/份);
* 如果发票可添加小编微信 r_stata2 (RStata 李老师)开具。如需数据资料,购买后可添加小编微信免费领取数据折扣卡。
更多关于 RStata 会员的更多信息可添加微信号 r_stata2 咨询:
课程主页(点击文末的阅读原文即可跳转):https://rstata.duanshu.com/#/brief/course/f60028067ed945658184d221dece39b3