「快慢笔记」原创 · 阅读约 10 分钟三剑客 = Linux 文本处理的 3 个核心工具,默认都按行处理,但分工不同。命令不用背,遇到问题查,多用。
一、三剑客速览(一张图 + 一张表)
三剑客 = Linux 文本处理的 3 个核心工具,默认都按行处理,但分工不同。
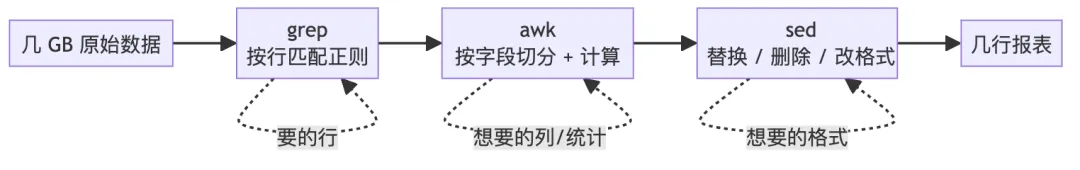
📌 三剑客协作数据流(从"几 GB 原始数据"到"几行报表"):
| | |
|---|
| grep | g/re/p = global regular expression print | |
| awk | 名字取自 3 个发明者姓氏首字母:Aho、Weinberger、Kernighan | 按行 → 按字段切分 → 执行"模式 { 动作 }" |
| sed | sed | 按行处理,执行脚本化编辑命令(s 替换、d 删除、p 打印等) |
三剑客共同出处:1973-1977 年间,贝尔实验室(Bell Labs)三波人接力发明的 Unix 工具。共同设计哲学:小而美——一个工具只做一件事,但做到极致。
二、原始方案 vs 进阶方案(对比表)
只对比"原始手工方案"和"进阶命令行方案",两者都能用——只是"几小时 vs 几秒"的差距。
| | |
|---|
| less | grep "ERROR" log |
| cat log | grep -nC 3 "ERROR" log |
| Excel 打不开(几 GB)、Python 写脚本(几十分钟) | awk '{sum+=$10; n++} END{print sum/n}' log |
| Excel 做透视表(几小时)、SQL 导库(几十分钟) | awk '{cnt[$1]++} END{for(k in cnt) print k, cnt[k]}' log |
| SSH 500 次 + vi 改 500 次(几小时) | sed -i.bak 's/old/new/g' file |
| 写 Python 脚本 / 写 bash for 循环(几十分钟) | for f in *.txt; do mv "$f" "${f%.txt}.md"; done |
| | grep -rn --include="*.py" "^def " src/ |
| | sed -i '/^#/d; /^$/d' config.ini |
数据来源:以上 8 个场景为生产环境常见任务,时间估算基于 1 GB 输入文件 + 1 核 CPU + 8 GB 内存的常规配置(grep/awk 大文件扫描 < 10 秒,Python 处理同量数据 < 1 分钟)
三、啥时候用哪个(口诀 + 决策表)
一句话口诀:
| | |
|---|
| | grep "ERROR" log |
| | grep -n "ERROR" log |
| | grep -v "200 OK" log |
| | grep -i "error" log |
| | awk '{print $1}' file |
| | awk -F: '{print $1}' /etc/passwd |
| | awk '$3 > 100 {print $1}' file |
| | awk '{sum+=$1} END{print sum/NR}' |
| | sed 's/old/new/g' file |
| | sed '/^#/d' file |
| | sed -i.bak 's/old/new/g' file |
四、grep
4.1 读懂 grep:从 ed 编辑器抽出来的工具
grep名字来自 ed 编辑器的一条命令 g/re/p(globalregularexpressionprint),意思是"全局查找匹配正则的行,并打印"。
来历:1973 年,Ken Thompson(C 语言前身 B 语言的作者、Unix 联合创始人)在贝尔实验室写 ed 编辑器时,同事 Doug McIlroy 请他把 ed 里的"正则匹配"功能抽成一个独立的小工具。他用了一晚上,把 ed 的正则引擎拆出来,加上"扫一遍输入 → 匹配上就打印"的逻辑,这个新工具就叫 grep(就是 ed 里那条命令的缩写)。Ken Thompson 自述:"grep 是我的私用工具,公开之前我用了一阵子。"
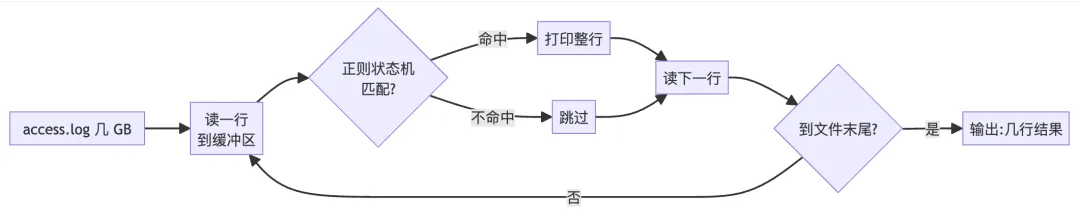
一行话讲清 grep:在文件或输入流里按行扫描,用正则表达式匹配每行内容,匹配上就打印整行到标准输出,匹配不上就跳过。
4.2 跑起来长啥样(5 步处理表)
关键点:
- 按行读——不需要把整个文件装进内存,所以几 GB 也吃得下
4.3 进阶能力清单:grep 能做的 8 件事
| |
|---|
| grep "关键词" 文件 |
| grep -n "关键词" 文件 |
| grep -v "关键词" 文件 |
| grep -i "关键词" 文件 |
| grep -nC 3 "关键词" 文件 |
| grep -rn "关键词" 目录 |
| grep -rn --include="*.py" "关键词" src/ |
| grep -E "模式1|模式2" 文件 |
4.4 5 步走通:从 grep "k" file 到 grep -E
4.5 复制即跑:5 个例子覆盖 80% 场景
每个例子的"读前须知":先复制"前置"那 1 段建数据,再复制"例子"那 1 段跑命令。不建数据跑命令会报错。
前置(准备测试数据):
mkdir -p /tmp/grep-demo && cd /tmp/grep-democat > access.log <<'EOF'192.168.1.10 - GET /api/user 200 1024192.168.1.11 - POST /api/login 401 56192.168.1.10 - GET /api/order 200 2048192.168.1.12 - GET /api/admin 403 12810.0.0.5 - GET /health 200 32EOF
例子 1(基础):找含 "login" 的行—— 只想看哪些请求是登录接口
grep "login" access.log# 输出:# 192.168.1.11 - POST /api/login 401 56
例子 2(行号):找 "GET" + 显示行号—— 想把行号贴给同事
grep -n "GET" access.log# 输出:# 1:192.168.1.10 - GET /api/user 200 1024# 3:192.168.1.10 - GET /api/order 200 2048# 4:192.168.1.12 - GET /api/admin 403 128# 5:10.0.0.5 - GET /health 200 32
例子 3(反向):找"不是 200 状态码"的请求—— 日志里 99% 是 200,只看错误
grep -v "200" access.log# 输出(只剩错误请求):# 192.168.1.11 - POST /api/login 401 56# 192.168.1.12 - GET /api/admin 403 128
例子 4(忽略大小写):日志里 "Error" "ERROR" "error" 都能找
echo "Error: connection refused" > err.logecho "WARNING: disk full" >> err.loggrep -i "error" err.log# 输出:# Error: connection refused
例子 5(扩展正则):多模式"或"—— 找 192.168 网段或 10.0 网段的请求
grep -E "192\.168|10\.0" access.log# 输出(全部 5 行,都被匹配上)
五、awk
5.1 读懂 awk:3 个发明者姓氏首字母命名的语言
awk 名字取自 3 个发明者姓氏的首字母:Aho、Weinberger、Kernighan。
来历:1977 年,在贝尔实验室,Alfred Aho(也是 egrep 的作者)、Peter Weinberger、Brian Kernighan 三人合作设计了一门专门处理结构化文本的脚本语言,这就是 awk。它的目标是"既能像 grep 那样搜模式,又能像 shell 那样做条件分支和循环,还能像 C 那样处理字符串和数字"。
awk 跟 sed 的关键区别:sed 是"流编辑器"(只改文本),awk 是"完整的脚本语言"(有变量、循环、函数、数组)。awk 一开始就是冲着"出报表"设计的,所以天然支持 $1 $2 $NF 取列、求和、平均、分组统计。
一行话讲清 awk:把输入的每一行按"字段分隔符"切分(默认是空白字符,$1 第 1 字段、$2 第 2 字段、$NF 最后一个字段、$0 整行),对每行执行"模式 { 动作 }"——模式匹配就执行动作,匹配不上就跳过。
awk 主要有 3 个实现版本(2026 H1 现状):
- gawk(GNU awk):功能最全,Red Hat/Rocky 默认,5.4.0(2026-02-22)
- mawk(Mike Brennan awk):速度快,Debian/Ubuntu 默认
- nawk(Brian Kernighan new awk):BSD/macOS 默认
5.2 跑起来长啥样(7 步处理表)
| | | |
|---|
| | | |
| 读一行 → 记录($0) | | |
| 按 FS(默认空白)切字段 | $1 第 1 字段 / $2 第 2 字段 / $NF 最后一个 / $0 整行 | |
| BEGIN 块执行(可选) | | |
| 模式 { 动作 } | | |
| END 块执行(可选) | | |
| | | |
关键点:
5.3 进阶能力清单:awk 必练 8 个写法
| |
|---|
| awk '{print $1}' file |
| awk '{print $1, $3}' file |
| awk -F: '{print $1}' /etc/passwd |
| awk '$3 > 100 {print $1}' file |
| awk '{sum+=$1} END{print sum}' file |
| awk '{sum+=$1; n++} END{print sum/n}' file |
| awk '{cnt[$1]++} END{for(k in cnt)print k,cnt[k]}' |
| awk 'BEGIN{print "head"}{...}END{print "sum"}' |
5.4 5 步走通:从 print $1 到 BEGIN/END
| | |
|---|
| awk '{print $1}' | |
| awk '{print $1, $3}' | |
| awk -F: '{print $1}' | |
| awk '$3>100 {print $1}' | |
| awk 'BEGIN{...}{...}END{...}' | |
5.5 复制即跑:5 个例子从取列到出报表
读前须知:先复制"前置"建数据,再跑"例子"。score.txt 5 列:姓名 学号 语文 数学 英语
前置(准备测试数据):
mkdir -p /tmp/awk-demo && cd /tmp/awk-democat > score.txt <<'EOF'Marry 2143 78 84 77Jack 2321 66 78 45Tom 2122 48 77 71Mike 2537 87 97 95Bob 2415 40 57 62EOF
例子 1(基础):取第 1 列(姓名)—— 只想看姓名,不要学号和成绩
awk '{print $1}' score.txt# 输出:# Marry# Jack# Tom# Mike# Bob
例子 2(多列):姓名 + 语文成绩—— 做一张"姓名 + 语文"简表
awk '{print $1, $3}' score.txt# 输出:# Marry 78# Jack 66# Tom 48# Mike 87# Bob 40
例子 3(分隔符):/etc/passwd 取用户名—— /etc/passwd 用冒号分隔,默认空白切不动
awk -F: '{print $1}' /etc/passwd# 输出:# root# daemon# www-data# sshd
例子 4(条件):只关心数学及格(>= 60)的人—— 只想看及格的
awk '$4 >= 60 {print $1, "数学及格, 成绩:", $4}' score.txt# 输出:# Marry 数学及格, 成绩: 84# Jack 数学及格, 成绩: 78# Tom 数学及格, 成绩: 77# Mike 数学及格, 成绩: 97# (Bob 数学 57 没及格,被过滤掉)
例子 5(报表):求语文平均分—— 出"全班平均分"报表
awk '{sum+=$3; n++} END {printf "语文平均分: %.1f (共 %d 人)\n", sum/n, n}' score.txt# 输出:# 语文平均分: 63.8 (共 5 人)
六、sed
6.1 读懂 sed:流编辑器到底"流"在哪
sed=streameditor(只拆这两个字母,其他都是凑的),意思是"流式文本编辑器"。
来历:1973-1974 年,Lee E. McMahon在贝尔实验室设计。动机是 grep 的扩展——grep 只能 "globalregularexpressionprint"(全局搜正则并打印),McMahon 想做"g/re/s"(全局搜正则并substitute 替换),但他预见到"g/re/d"、g/re/c"……会越出越多,不如写一个通用目的的、按行处理的、脚本化的流编辑器,这就是 sed。它的语法(s/pattern/replacement/、d删除、p打印、/模式分隔符)直接继承自 ed 编辑器。
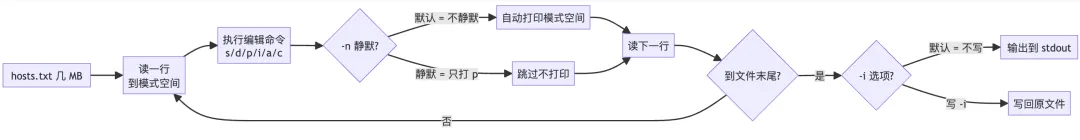
一行话讲清 sed:从输入流(文件或管道)里逐行读取,对每行执行一条或多条编辑命令(用紧凑的脚本语言写),处理完写到标准输出。"流"指的是数据像水流一样从源流到目的地,边流边改。
sed 跟 grep / awk 的关键区别:
6.2 跑起来长啥样(7 步处理表)
| | | |
|---|
| | | |
| 读一行 → 模式空间 | | |
| 执行编辑命令脚本 | s 替换 / d 删除 / p 打印 / i 插入 / a 追加 / c 替换行 等 | |
| -n 静默模式? | 默认 = 不静默(自动打印模式空间)/ -n = 静默(只打 p 指定的) | |
| | | |
| -i 选项? | 默认 = 不写(输出到 stdout) / -i = 写回原文件 | |
| | 不写 -i:stdout 输出 / 写 -i:原文件已改 | |
关键点:
- sed 默认就打印模式空间到 stdout(除非用
-n 关闭)
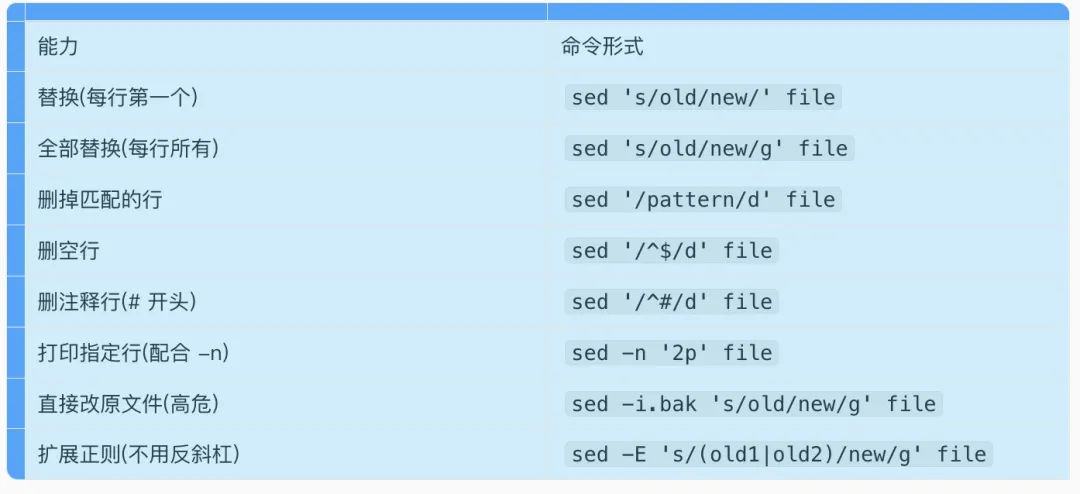
6.3 进阶能力清单:sed 必练 8 个写法
6.4 5 步走通:从 s/old/new/ 到 -i.bak
| | |
|---|
| sed 's/old/new/' file | |
| sed 's/old/new/g' file | |
| sed '/pattern/d' file | |
| sed -n 'Np' file | |
| sed -i 's/old/new/g' file | 直接改原文件 |
6.5 复制即跑:5 个例子从替换到改原文件
前置(准备测试数据):
mkdir -p /tmp/sed-demo && cd /tmp/sed-democat > hosts.txt <<'EOF'127.0.0.1 localhost192.168.1.10 web01192.168.1.11 web0210.0.0.5 db1EOF
例子 1(基础):把 192.168.1.10 改成 10.0.1.10—— 单个 IP 修改
sed 's/192.168.1.10/10.0.1.10/' hosts.txt# 输出:# 127.0.0.1 localhost# 10.0.1.10 web01 ← 改了# 192.168.1.11 web02# 10.0.0.5 db1
例子 2(全部替换):把 192.168 全替换成 10.0—— 加 /g 才换每行所有
sed 's/192.168/10.0/g' hosts.txt# 输出:# 127.0.0.1 localhost# 10.0.1.10 web01# 10.0.1.11 web02# 10.0.0.5 db1
例子 3(删除):删掉 10.0 开头的行—— 只想保留内网 IP,删公网
echo "10.0.1.10 web01" | sed '/^10.0/d'# 输出: (空)
例子 4(打印指定行):只看第 2 行—— 不用 cat 全部
sed -n '2p' hosts.txt# 输出:# 192.168.1.10 web01
例子 5(高危 · 改原文件):必须先备份—— -i 直接改原文件,不可逆
# 错误示范 ❌(直接改,不可恢复):sed -i 's/192.168/10.0/g' hosts.txt# 正确示范 ✅(改之前先 cp 一份):cp hosts.txt hosts.txt.baksed -i 's/192.168/10.0/g' hosts.txtcat hosts.txt # 看看改完是啥样diff hosts.txt hosts.txt.bak # 对比改了哪些# 满意了,删备份;不满意,cp 回去rm hosts.txt.bak
七、入门必练 8 招(80% 场景)
8 个命令覆盖 80% 日常场景。前 6 个背下来**;7-8 是"救命操作"。
| | |
|---|
| grep -n "关键词" 文件 | |
| grep -v "不要的" 文件 | |
| grep -i "关键词" 文件 | |
| awk '{print $1}' 文件 | |
| awk -F: '{print $1}' /etc/passwd | |
| awk '$N > 数字 {print $1}' | |
| sed 's/old/new/g' 文件 | |
| sed -i.bak 's/old/new/g' 文件 | |
八、sed -i 高危警告:改文件必须先备份
sed -i 是三剑客里唯一"不可逆"的操作。改错回不去。
标准安全姿势(4 行,救命用):
cp 待改文件 待改文件.bak # 1. 先备份sed -i 's/old/new/g' 待改文件 # 2. 改文件diff 待改文件 待改文件.bak # 3. 对比改了哪些# 满意 → rm 待改文件.bak# 不满意 → cp 待改文件.bak 待改文件 # 4. 不满意就恢复
最推荐的"懒人安全姿势"(-i.bak自动备份):
# 一行搞定:改 + 自动留 .bak 备份sed -i.bak 's/old/new/g' 待改文件ls 待改文件.bak # 自动生成的备份diff 待改文件 待改文件.bak # 对比# 满意 → rm 待改文件.bak
两种姿势对比:
| | |
|---|
cp + sed -i | | |
sed -i.bak | | GNU sed 专属,macOS BSD sed 不支持 |
九、5 道练习题(从简到难)
跑完这 5 题,grep/awk/sed 的"日常 80%"就算会了。
练习 1(grep 入门):找 access.log 里的 404# 准备数据mkdir -p /tmp/ex && cd /tmp/excat > log.txt <<'EOF'2026-07-01 10:00:00 GET /api/user 2002026-07-01 10:01:00 GET /api/order 4042026-07-01 10:02:00 POST /api/login 4012026-07-01 10:03:00 GET /api/admin 404EOF# 找 404grep "404" log.txt
练习 2(grep 行号 + 排除):找 404 的行号 + 看"不是 200 状态码"的请求grep -n ”404” log.txtgrep -v ”200” log.txt
练习 3(awk 取列):从 log.txt 取"时间"和"路径"两列awk '{print $2, $4}' log.txt# 期望:10:00:00 /api/user 等
练习 4(awk 条件):找"第 4 列(状态码)大于等于 400"的请求,只打印第 4 列awk '$4 >= 400 {print $4}' log.txt# 期望:404, 401, 404
练习 5(sed 替换):把 log.txt 里所有 "GET" 改成 "GET(读)"# 先演练(不写 -i)sed 's/GET/GET(读)/g' log.txt# 确认无误再写cp log.txt log.txt.baksed -i 's/GET/GET(读)/g' log.txtcat log.txt
十、故障反查(9 大场景 → 立刻用哪个)
Ctrl+F 搜故障关键词,比从头读到尾管用 100 倍。
| | |
|---|
| | grep -n "关键字" 文件 |
| | grep -nC 3 "ERROR" log |
| | grep -oE "IP" log | sort | uniq -c | sort -rn |
| | grep -rn --include="*.py" "^def " src/ |
| | awk -F, '{print $1, $3}' file.csv |
| | awk '{cnt[$1]++} END {for (k in cnt) print k, cnt[k]}' |
| | awk '{sum+=$1; n++} END {print sum, sum/n}' |
| | sed -i.bak 's/old/new/g' file |
| | sed -i -E '/^$/d; /^#/d' file |
📚 系列导航
 10个月宝宝每天需要喝多少奶粉?