Flink Python API:Pythonic DataFrame 背后的多模态编程模型
- 2026-09-29 12:29:33
摘要:本文围绕 Flink 在多模态数据处理方向的探索展开,介绍多模态 workload 给数据处理系统带来的新挑战,以及 Flink 如何通过 Python DataFrame API、多模态原生数据类型、内置多模态算子、Arrow 列式优化和非阻塞 Checkpoint 等能力,构建实时与离线统一的多模态数据处理引擎。
随着大语言模型与多模态模型能力快速发展,企业中长期沉淀的图片、音频、视频、文档等非结构化数据,正在从“存得下”走向“用得好”。过去,这些数据虽然一直存在,但受限于模型理解能力和数据处理工具链,往往难以被规模化利用。今天,随着 LLM 能力的不断增强,图像理解、文档解析、音频转录、视频处理、Embedding 生产等多模态数据处理场景开始得到越来越广泛的关注,多模态数据处理能力也随之成为数据基础设施必须面对的新命题。
这类 workload 与传统结构化 BI 计算有明显差异:单条记录处理成本更高,payload 更大,处理链路更长,并且往往同时混合多种类型的负载:IO 密集型、CPU 密集型、GPU 密集型。如何把昂贵的 GPU 资源高效利用起来,如何降低大对象在引擎内流转的成本,如何在长链路任务中保证容错与恢复效率,成为多模态数据处理走向生产的关键。
Flink 具备天然适合这一方向的基础能力:Pipeline 执行模式可以让不同类型工作负载在流水线中协同运行,Checkpoint 可以显著降低故障恢复时的重算成本,成熟的背压、Checkpoint 机制、容错与调度能力也为生产稳定性提供了基础。文章《从结构化到多模态:Apache Flink,多模态数据处理的流式底座》已经系统阐述了 Flink 为什么适合多模态数据处理。本文聚焦 Python DataFrame API、多模态数据类型等 API 层的能力,重点介绍我们在 Flink 引擎中面向多模态数据处理场景提供了哪些新的能力。
Python DataFrame API:面向多模态场景的原生 Python API 层
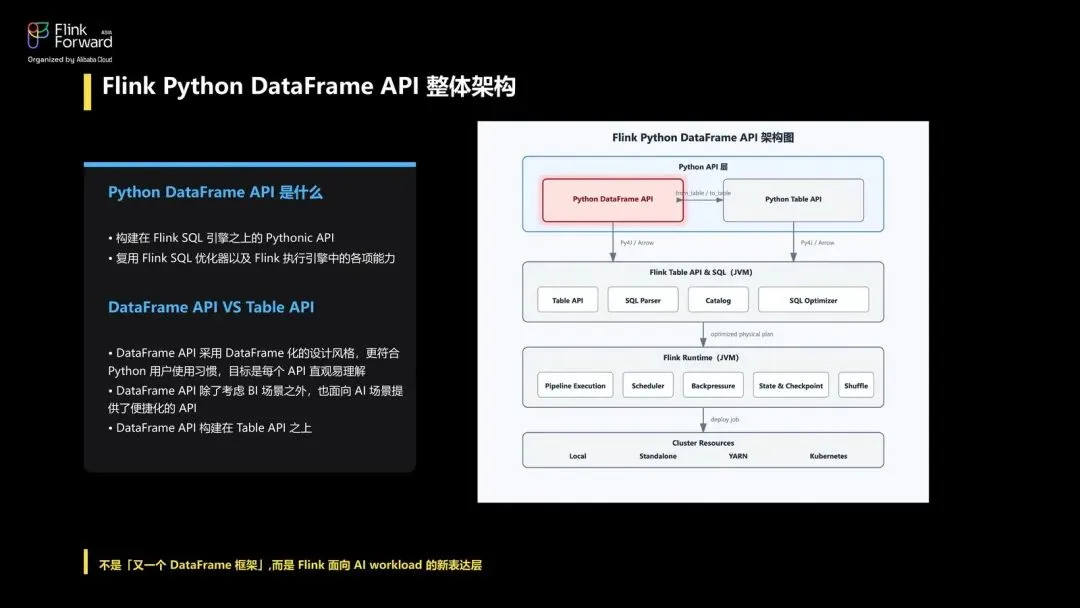
为了让 Python 用户更自然地编写多模态任务,我们在 PyFlink 中引入了 Python DataFrame API。它是构建在 Flink SQL 引擎之上的 Pythonic API,提供更贴近 Python 与 AI 开发者习惯的表达方式,并复用 Flink SQL 优化器和 Flink 执行引擎的各项能力。
DataFrame API 整体架构
更具体地看,Python DataFrame API 解决的不是“给 Table API 换一层 Python 语法糖”,而是把 Flink 面向 AI workload 的表达层重新组织成 DataFrame 风格。它的核心设计可以概括为以下几点:
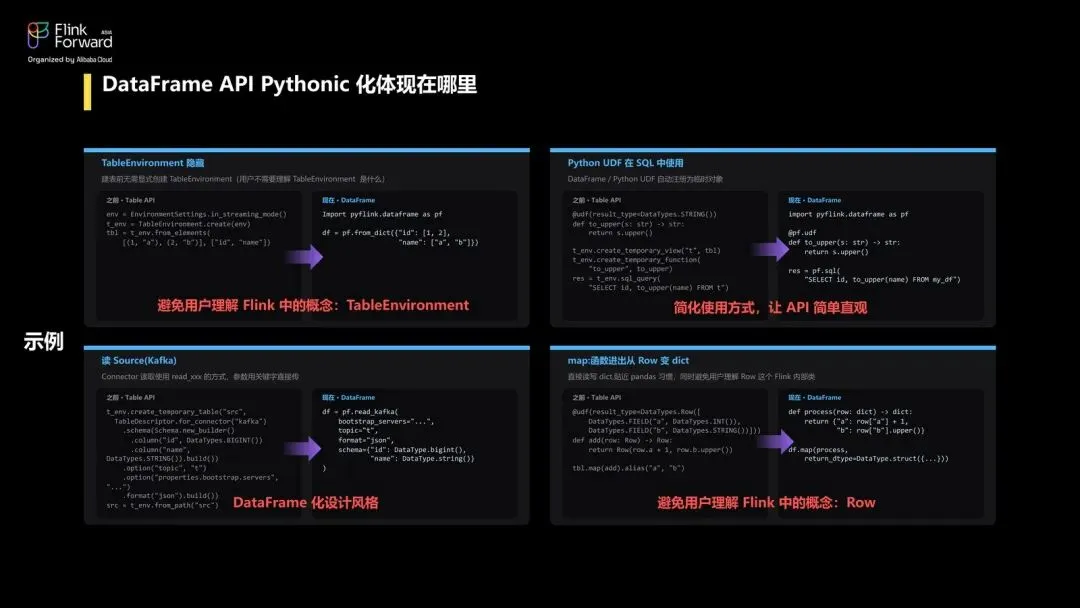
- 表达层 Pythonic 化:隐藏 TableEnvironment、Row 等各种 Flink 内部概念,让创建 DataFrame、注册 UDF、读写 Connector 等操作更贴近 Python 用户使用习惯,降低用户上手门槛。
- 能力层复用 Flink SQL:DataFrame API 构建在 Flink SQL / Table API 之上,因此不是另起一套执行系统,而是复用 Flink SQL 优化器、Flink Connector 生态、Flink 运行时和 Checkpoint 等能力。
- 面向多模态数据处理场景提供一体化能力:关系运算、行式 Python UDF、批量 Python UDF、异步 Python UDF、内置多模态算子和 LLM 调用可以在同一条链上自由组合;支持算子级 GPU 资源声明、并发度控制等能力。
隐藏 Flink 概念,降低 Python 用户上手门槛
import pyflink.dataframe as pf# 从 Python 对象直接创建 DataFrame,不需要显式创建 TableEnvironmentdf = pf.from_dict({ "id": [1, 2], "name": ["flink", "multimodal"]})@pf.udfdef normalize_name(name: str) -> str: return name.upper()# Python UDF 可以直接在 SQL 中使用result = pf.sql("SELECT id, normalize_name(name) AS name FROM df")在这个示例中,用户不需要理解 Flink 中的 TableEnvironment、临时视图、函数注册等概念,就可以完成 Python DataFrame API 作业逻辑的编写。
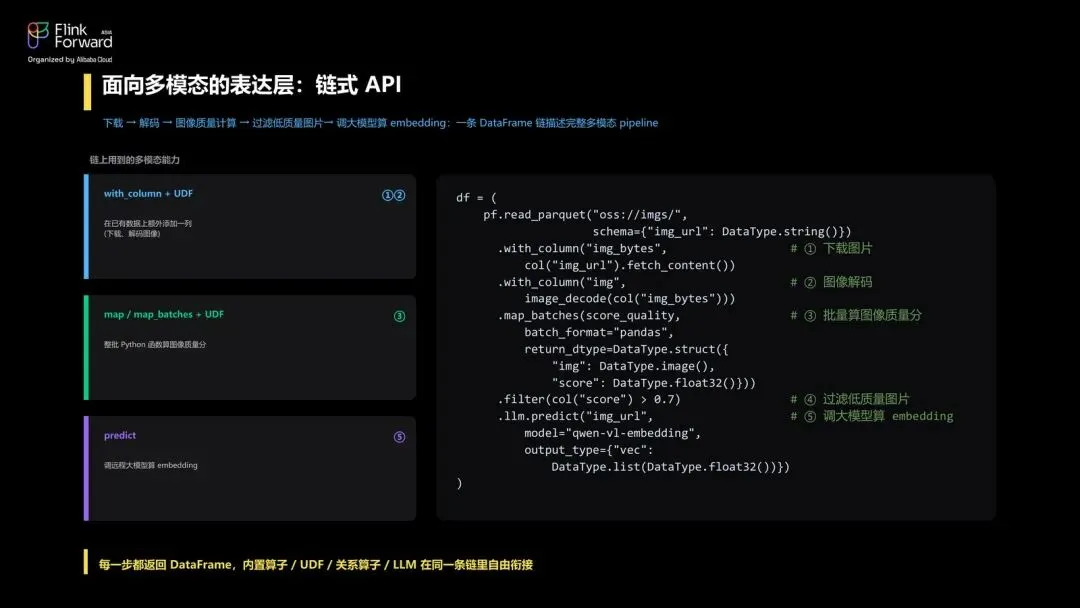
链式 API,让多模态处理逻辑编写起来更顺手、理解起来更直观
df = ( pf.read_kafka( bootstrap_servers="kafka:9092", topic="image-events", format="json", schema={"img_url": DataType.string(), "uid": DataType.string()} ) .with_column("img_bytes", col("img_url").fetch_content()) .with_column("img", image_decode(col("img_bytes"))) .map_batches(score_quality, batch_format="pandas", batch_size=64, return_dtype=DataType.struct({ "uid": DataType.string(), "img": DataType.image(), "score": DataType.float32() })) .filter(col("score") > 0.7))在这类 pipeline 中,每一步都返回新的 DataFrame。像上面的例子中,图像下载、解码、批量质量评估、过滤等操作可以顺着数据流自然串起来,同时每一步仍然可以被 Flink 拆成独立算子做优化、调度和容错。
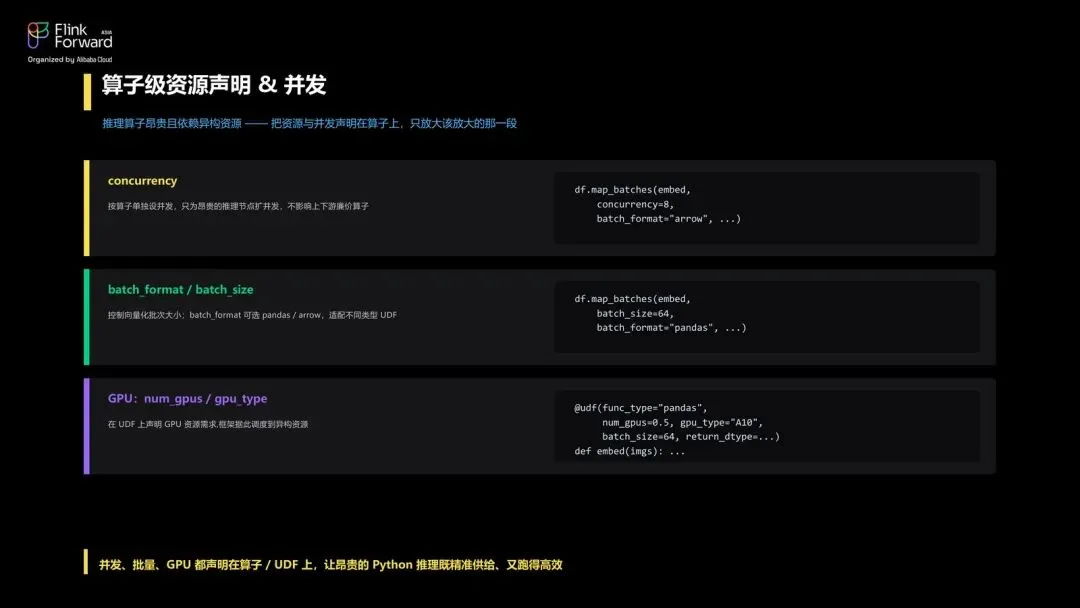
算子级 GPU 资源声明 & 并发度配置
@pf.udf(func_type="arrow", num_gpus=0.5, gpu_type="A10", batch_size=64)def embed(batch: pa.Array) -> pa.Array: # 批量推理:让 GPU 在更大的 batch 上工作 return pa.array(model.encode(batch.to_pylist()))@pf.udf(concurrency=32)async def enrich_remote(uid: str) -> dict: # 远程高时延服务:用异步 UDF 避免阻塞流水线 return await client.get_profile(uid)out = ( df.with_column("vec", embed(col("img"))) .with_column("profile", enrich_remote(col("uid"))) .write_parquet("oss://bucket/multimodal/features/"))多模态 workload 中,不同阶段的瓶颈差异很大:多模态数据下载是 IO 密集型,解码和预处理偏 CPU,Embedding 或模型推理依赖 GPU,远程模型调用则通常是高时延异步请求,因此 DataFrame API 需要支持用户算子级配置 GPU 资源以及并发度,而不是粗粒度地配置整个作业。
支持多种类型的 Python UDF,满足不同场景下用户的需求
多模态任务通常需要把不同类型的计算放在同一条链路中处理,因此 UDF 体系需要覆盖更多执行形态。
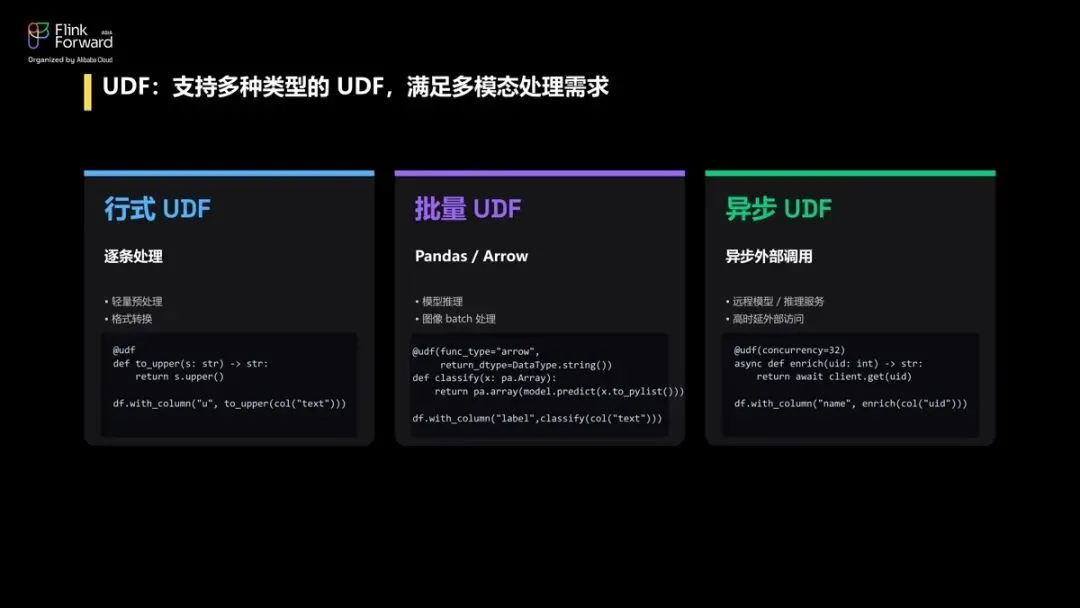
目前的设计中,DataFrame API 支持三类典型 Python UDF:
- 行式 UDF:适合轻量预处理、格式转换等逐条处理场景;
- 批量 UDF:支持 Pandas / Arrow 等批格式,适合模型推理、图像 batch 处理等需要攒批提升吞吐的场景;
- 异步 UDF:适合调用远程模型、推理服务或其他高时延
下面用一个多模态内容处理链路举例:
行式 UDF:适合轻量清洗、字段归一化、元信息解析
@pf.udfdef normalize_uri(uri: str) -> str: return uri.strip().replace("http://", "https://")df = df.with_column("image_url", normalize_uri(col("image_url")))批量 UDF:适合图片分类、Embedding、OCR 等需要批量计算以提升吞吐的场景,比如模型推理、批量图像处理等
def classify_images(images: pa.Array) -> pa.Array: return vision_model.predict(images)df = df.map_batches( classify_images, batch_format="arrow")异步 UDF:适合调用远程 LLM、向量化服务或外部审核服务
@pf.udfasync def call_caption_model(image): return await caption_client.generate(image)df = df.with_column("caption", call_caption_model("image"))行式 UDF 让轻量逻辑保持简单,批量 UDF 让 GPU 推理性能更好,异步 UDF 则避免远程服务调用阻塞整条链路。三类 UDF 可以在同一条 DataFrame pipeline 中组合,分别匹配 CPU、GPU 和外部服务这几类不同工作负载。
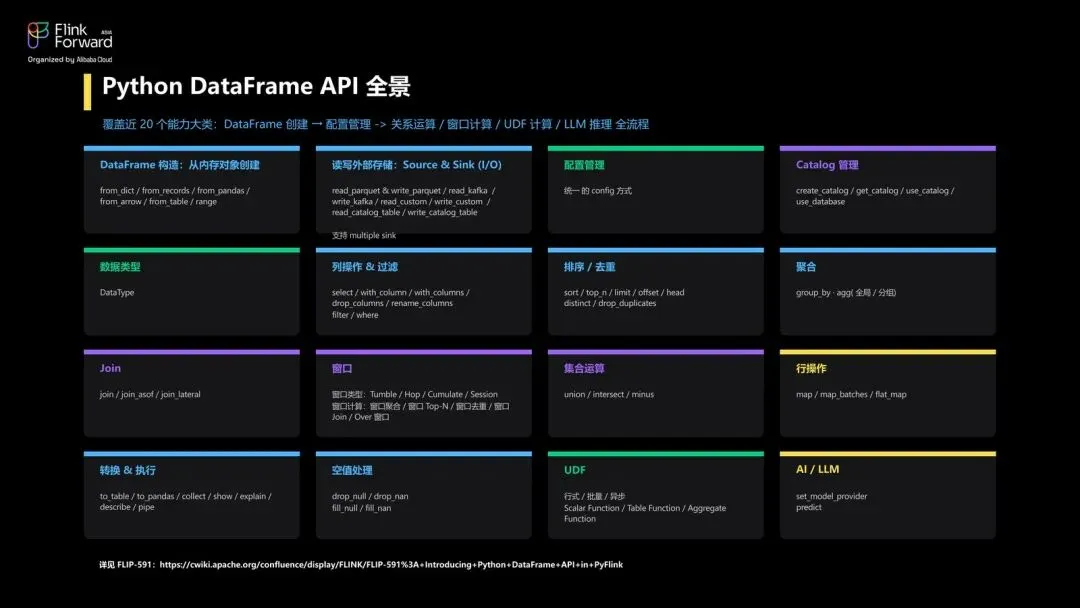
Python DataFrame API 一览
从 API 全景看,这套 DataFrame API 覆盖了多模态数据处理流程中的各项能力,包括 DataFrame 构造、Source/Sink 读写、Catalog 访问、配置、列操作、聚合、Join、窗口计算、集合运算、UDF、AI/LLM、转换与执行等近 20 类能力,它的目标是为 AI workload 提供完整的处理能力。
原生多模态数据类型与内置多模态处理能力
在传统结构化计算中,图片、音频、视频等对象往往只能被当作 Binary 传输。这样虽然可行,但系统无法理解其中的语义,也很难围绕这些对象做优化。
面向多模态场景,Flink 社区将引入四类原生数据类型:
- Image:用于图像解码、视频抽帧后的图像表示,可携带 mode、shape 等元信息;
- Tensor:用于模型输入等多维数组表示;
- Vector:用于 Embedding 结果等向量表示;
- File:用于音频、视频、文档等文件引用,可携带 uri、offset、length、size、content_type 等信息。
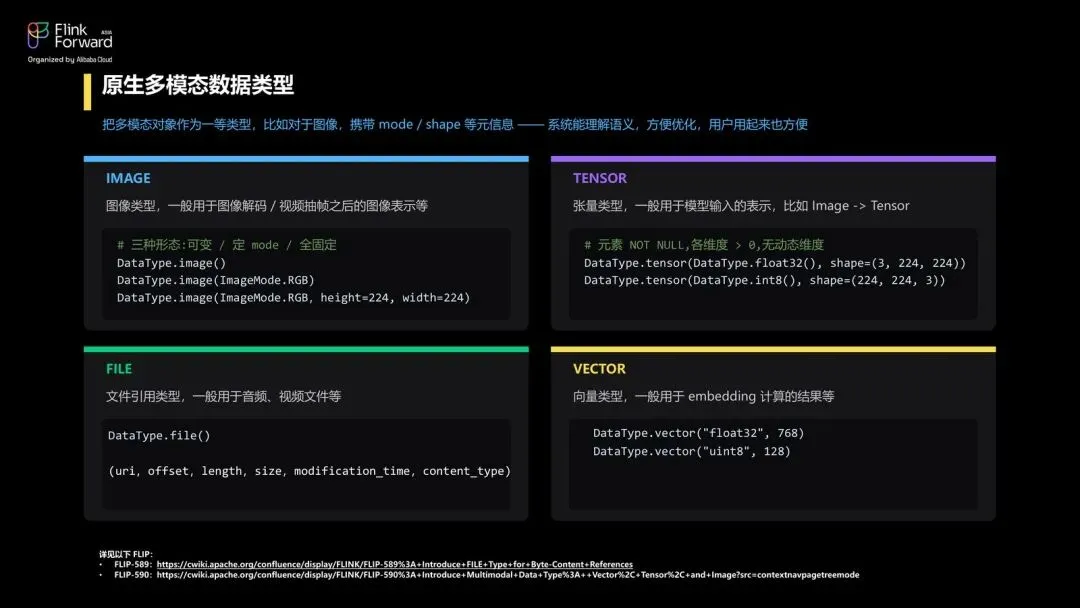
当多模态对象成为一等类型,用户编写作业会更自然,系统也可以基于类型和元信息做更深入的执行优化。例如 Image 不再只是一段无语义的二进制,而是带有格式、尺寸、通道等信息的数据对象;Vector 也不再只是数组,而是可以表达元素类型和维度的向量结果。
除了多模态数据类型之外,常见多模态数据处理逻辑也会沉淀为 Flink 引擎内置能力,减少用户重复编写 Python UDF 的成本,降低使用门槛,我们计划引入上百个面向多模态数据处理场景的内置功能,比如:
- 图像:image_decode、image_resize、image_to_tensor、image_ocr、image_sharpness、image_metadata;
- 视频:video_metadata、video_extract_frames、video_clip、video_concat;
- 音频:audio_metadata、audio_resample、audio_split_by_speech、audio_to_tensor;
- 文本:text_normalize、text_chunk、text_token_count、text_join_chunks。
这些能力的目标,是把多模态数据处理中高频、通用、可优化的部分下沉到 Flink 原生能力中,让用户把精力放在业务逻辑和模型选择上。
Flink 引擎做多模态数据处理,性能怎么样
谈到用 Flink 做多模态处理,一个常见疑问是:多模态处理主要发生在 Python 生态中,而 Flink 是 Java 引擎,跨语言、跨进程开销会不会很大?
答案取决于数据在整个处理链路上如何表示和传输,如果每一步都发生格式转换、序列化和反序列化,开销一定会被放大;但如果可以让数据以高效列式格式贯穿 Java 与 Python、算子与算子、subtask 与 subtask 之间,Flink Java 引擎并不必然带来高额 overhead。
这里的关键是 Arrow。Arrow 已经是大数据领域跨进程、跨语言、跨引擎的数据交换标准;而在 Python 多模态生态中,图像、Tensor、向量等对象底层也常常落到 NumPy ndarray 表示。Arrow 与 NumPy 能够支持零拷贝互转,因此可以成为连接 Flink 引擎与 Python 计算格式的高效桥梁。
围绕这一点,我们做了以下几方面的优化:
- Operator 内:Java 进程与 Python 进程之间通过共享内存和 Arrow 格式传输数据,降低跨进程通信与序列化成本;
- Operator 间:引入 VectorizedColumnBatchRowData,使列式批数据能够在 Flink 算子间高效流转,避免反复行列转换;
- Subtask 间:同一 TaskManager 内不同 subtask 之间也可以通过共享内存进行零拷贝数据交换。
通过多层零拷贝和全链路列式化,Flink 可以把开销从“跨语言不可避免很大”转变为“通过统一数据表示尽量压低”。
非阻塞 Checkpoint:将 Checkpoint 耗时跟多模态数据处理耗时解耦
多模态 workload 会对 Flink 的 Checkpoint 提出新挑战。在多模态 Pipeline 中,执行链路可能很长,单条数据处理时间也可能很不稳定。传统做法下,为了保证 Exactly Once,Python 算子当前的实现,Checkpoint 时需要等待 Python 进程中正在处理的数据处理完成。如果当前任务正在做 GPU 推理或远程模型调用,Checkpoint 就可能被长时间阻塞,导致 Checkpoint 耗时不可控。
面对这一问题,我们引入了 Python 算子的非阻塞 Checkpoint 能力。核心思想与 Flink Unaligned Checkpoint 类似:Checkpoint 不再等待所有慢处理完成,而是把尚未收到完整结果的 input 写入算子状态,把尚未发送到下游的 result 写入算子状态;恢复时再根据状态进行重放,保证不丢不重。
同时,算子还会根据下游 soft backpressure 状态决定是否继续发送数据,避免在网络层被阻塞。这样即使 Python UDF 或远程模型调用很慢,Barrier 也可以被及时处理,Checkpoint 耗时与多模态处理耗时解耦,从而守住 Exactly Once 语义,同时可以保证作业稳定性,不管多模态处理耗时多久,都可以在秒级完成 Checkpoint。
Benchmark:端到端效果验证
我们在同一个环境中,对比了 Flink、Daft、Ray 在 5 个典型多模态场景中的端到端耗时,覆盖图片、视频、音频、文档与图片入库去重等场景。
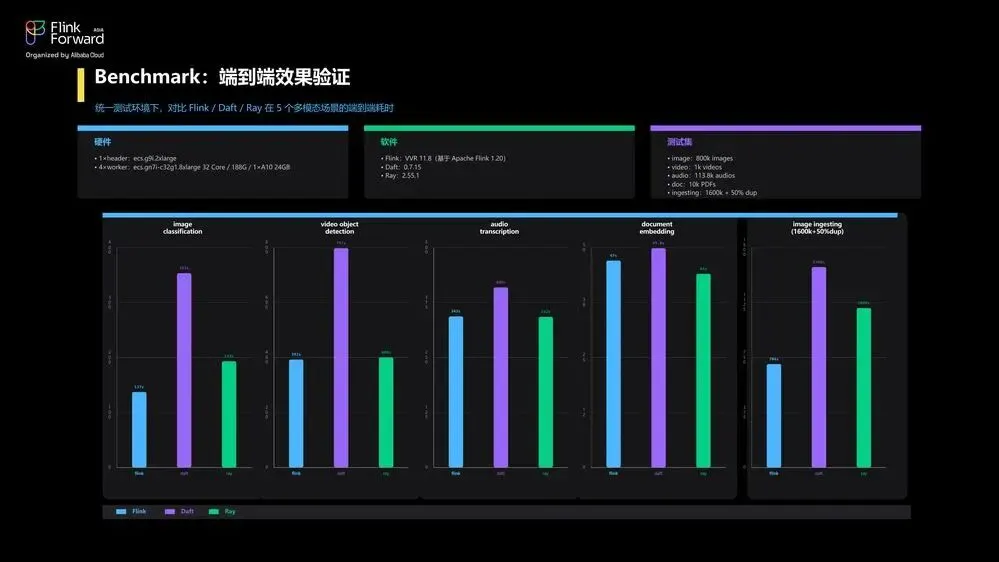
测试环境包括 1 台 header 节点和 4 台 worker 节点,每台 worker 为 32 Core / 188GB / 1 张 A10 24GB GPU。软件版本为 Flink VVR 11.8(基于 Apache Flink 1.20)、Daft 0.7.15(最新)、Ray 2.55.1(最新)。
如图所示,Flink 在多个场景下与 Daft、Ray 等面向 Python/AI 生态的处理框架表现相当,并在部分场景中受益于 Flink Pipeline 执行模式,可以取得更好的结果。
这些结果表明,经过 API、数据表示与执行层优化后,Flink 不仅可以表达多模态 pipeline,也可以在端到端作业性能上接近甚至超过其他 Python/AI 数据处理框架。
从实时走向统一的多模态处理引擎
很多人谈到 Flink 与多模态,第一反应是“实时多模态处理”:例如在线内容理解、实时 Embedding、推荐特征抽取、流式图文音视频混合处理等,这确实是 Flink 非常擅长的场景。
除此之外,Flink 同样也适合用于离线多模态处理。这里的“离线”并不是传统 stage-by-stage 的批执行,而是使用 Flink 流引擎中的 Pipeline 执行模式来处理 bounded source:数据源是有界的,任务最终会结束,但执行过程采用流引擎中的 Pipeline 执行模式,可以享受 Pipeline 执行、Checkpoint、容错等 Flink 引擎固有的优势。
这意味着,同一套技术栈可以同时服务两类场景:
- Unbounded Source:实时多模态处理,如在线内容理解、实时 Embedding、流式图文音视频混合处理;
- Bounded Source:离线多模态处理,如图片清洗去重、文档 Embedding、音视频批处理、大规模数据治理与离线特征生产。
上层是统一的表达层:DataFrame API、多模态数据类型、Python UDF 与内置多模态算子;下层是统一的执行层:Pipeline 执行、Checkpoint、运行时优化与资源调度。
如何试用上述能力 & 社区规划
目前,上述能力已经在阿里云实时计算 Flink 版中支持(VVR 11.8 及以上版本),用户可以参考「实时计算 Flink 版快速入门」上手体验:https://help.aliyun.com/zh/flink/realtime-flink/quickstart。与此同时,这些能力也将贡献到 Apache Flink 开源社区,我们已经在 Apache Flink 社区创建了相关 FLIP 并持续推进中,欢迎感兴趣的同学一起到社区共建:
- FLIP-589:Introduce FILE Type for Byte-Content Referenceshttps://cwiki.apache.org/confluence/display/FLINK/FLIP-589
- FLIP-590:Introduce Multimodal Data Type: Vector, Tensor, and Imagehttps://cwiki.apache.org/confluence/display/FLINK/FLIP-590
- FLIP-591:Introducing Python DataFrame API in PyFlinkhttps://cwiki.apache.org/confluence/display/FLINK/FLIP-591
- FLIP-593:Introduce Built-in Operators for Multimodal Data Processinghttps://cwiki.apache.org/confluence/display/FLINK/FLIP-593
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Linux 并发编程全解析:从线程同步到 I/O 多路复用
- PythonEnglish Typing Tutor - 英语指法打字练习系统
- 【视频教程】AI赋能的Python-GEE遥感云大数据分析与可视化实践及多领域案例进阶应用
- Python之Flask-WTF表单实现
- 从0到1学习Python的基本语法2
- 服务器崩了别慌!Linux 运维高频故障急救手册
- 用Python做了一个数据清洗工具,空行、重复、空格一键清理,数据瞬间变干净
- 免费白嫖腾讯云 Linux 桌面服务器!浏览器直接访问,WorkBuddy + Codex 24小时挂机干活
- Python装饰器精要解析
- 超额消纳量机制下独立售电商购售电策略(Python代码实现)