MCU上一个xQueueSend搞定的事,到Linux进程隔离后得"穿墙"通信——本文把两套IPC摆在一起,看清本质再选型。
一、FreeRTOS的IPC工具箱 共享内存下的传话方式
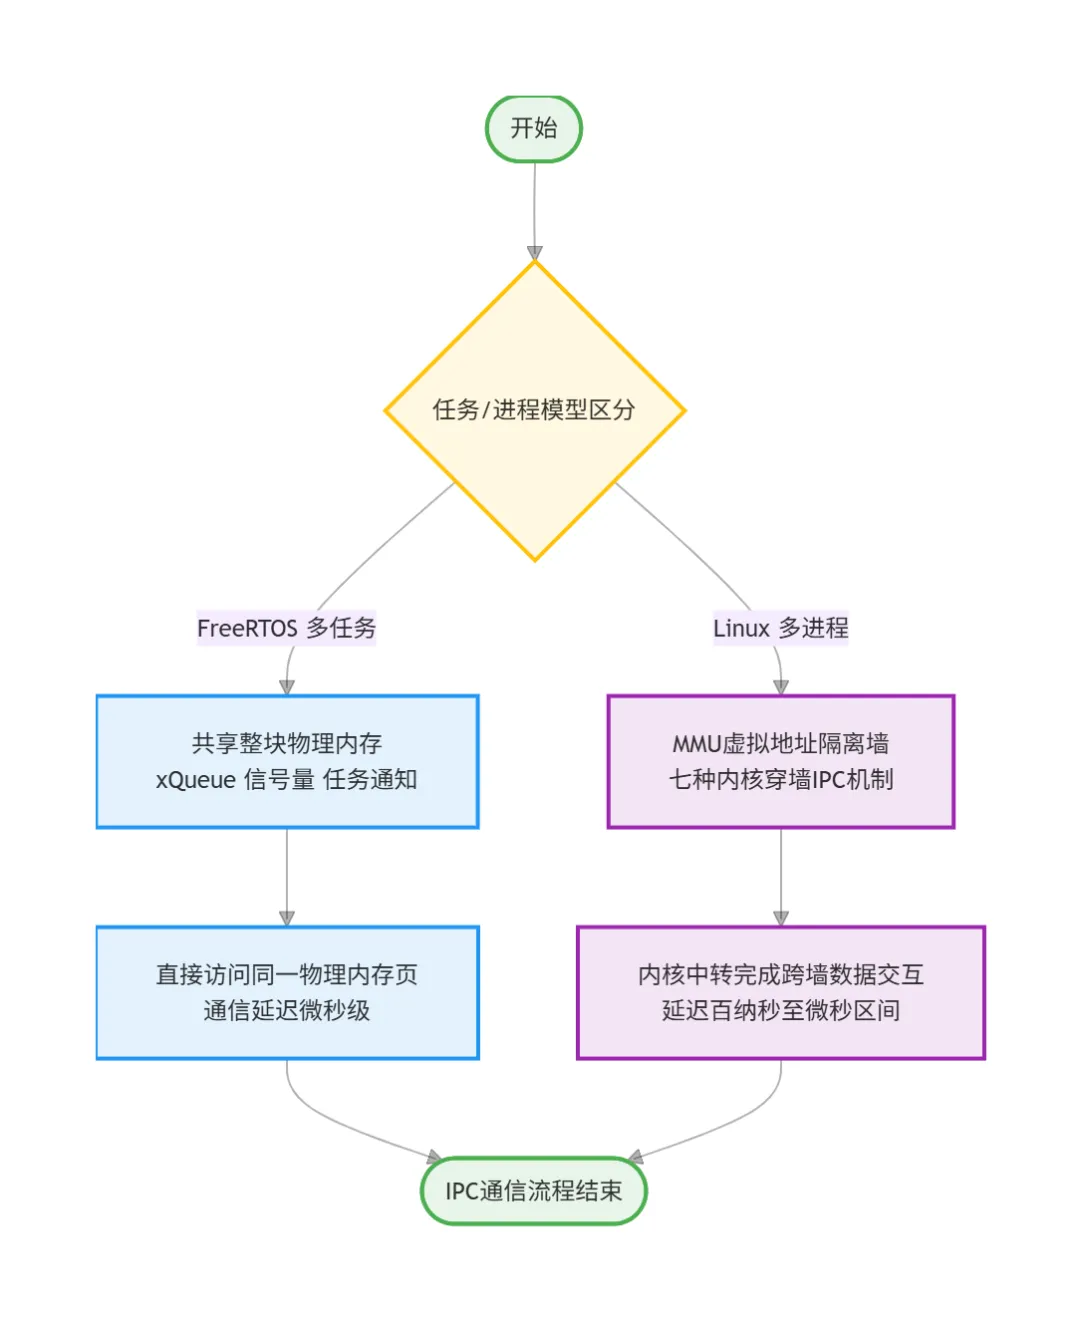
FreeRTOS 所有任务共享同一物理地址空间,TaskA 往 0x20001000 写值,TaskB 直接读就行。内核提供了 6 种标准传话方式:
static QueueHandle_t sensor_queue;static SemaphoreHandle_t ready_sem;static TaskHandle_t output_handle;void sensor_task(void *pv){int samples[16];while (1) { adc_read_burst(samples, 16); xQueueSend(sensor_queue, samples, 100); xSemaphoreGive(ready_sem); }}void process_task(void *pv){int raw[16];float result;while (1) {if (xSemaphoreTake(ready_sem, 100) != pdTRUE)continue; xQueueReceive(sensor_queue, raw, 0); result = kalman_filter(raw); xTaskNotify(output_handle, *((uint32_t *)&result), eSetValueWithOverwrite); }}
这条链路用了三种 IPC:消息队列传原始数据(量大要 FIFO),信号量传"有新数据"的状态,任务通知传滤波结果(单值最低延迟)。FreeRTOS 的 IPC 全在同一个物理地址空间,"发给你"就是"把数据放到你知道的地方"。
本节要点:FreeRTOS任务共享物理内存,IPC本质是"找双方都知道的地址"。
二、Linux进程隔离 FreeRTOS那套为什么行不通
同一个虚拟地址 0x7f000000,进程 A 的页表映射到存着"温度=25.3"的物理页,进程 B 的页表映射到存着"速度=100"的物理页——MMU 造的这道墙,让所有通信都必须经由内核提供的"穿墙术"。FreeRTOS 的全局变量、消息队列直接操作物理内存,到了 Linux 这套行不通了。
本节要点:MMU让进程虚拟地址隔离,同一地址映射到不同物理页,通信必须通过内核介入。
三、Linux七种IPC逐个拆 核心机制与代码实战
管道(Pipe)——父子进程单向数据流
内核维护环形缓冲区,fork 后父子进程共享这对 fd:
int fd[2];pipe(fd);if (fork() == 0) { close(fd[1]);char buf[100]; read(fd[0], buf, sizeof(buf));} else { close(fd[0]); write(fd[1], "hello from parent", 18);}
单向字节流,对应 FreeRTOS 的流缓冲区,容量默认 64KB。
命名管道(FIFO)——无亲缘进程的数据流
管道只能父子间用。命名管道在文件系统有个入口,任意进程都能打开:
mkfifo /tmp/my_pipeecho "sensor_data" > /tmp/my_pipe &cat /tmp/my_pipe
本质还是管道,多了文件系统入口,其他特性完全一样。
消息队列——带优先级的结构化消息
跟 xQueueSend 一个思路:结构化消息、按优先级消费、有消息边界不粘包:
mqd_t mq = mq_open("/sensor_mq", O_CREAT | O_RDWR, 0666, NULL);char msg[] = "temperature:25.3";mq_send(mq, msg, strlen(msg), 3); // 优先级3char buf[1024];unsigned int prio;mq_receive(mq, buf, sizeof(buf), &prio); // 取优先级最高的
跟 FreeRTOS 的 xQueueSend / xQueueReceive 几乎对称。
共享内存——最快的零拷贝IPC
消息队列每次收发都内核拷贝,共享内存跳过拷贝——两边映射同一块物理内存:
int fd = shm_open("/my_shm", O_CREAT | O_RDWR, 0666);ftruncate(fd, 4096);void *ptr = mmap(NULL, 4096, PROT_READ | PROT_WRITE, MAP_SHARED, fd, 0);sprintf((char *)ptr, "hello from PID=%d", getpid());
零拷贝最快,但没有内置同步,必须搭配信号量,对应 FreeRTOS 的全局变量。适合视频帧传递、实时数据流。
信号量——共享内存的配套锁
sem_t *sem = sem_open("/my_sem", O_CREAT, 0666, 1);sem_wait(sem);sprintf(shm_ptr, "new_data");sem_post(sem);
跟 xSemaphoreTake / xSemaphoreGive 对称。共享内存 + 信号量是经典组合。
信号(Signal)——只传状态不传数据
给进程发"事件发生了"的信号,可以打断正在执行的任何代码:
void on_shutdown(int sig) { save_checkpoint(); exit(0); }signal(SIGUSR1, on_shutdown);while (1) pause();
对应 FreeRTOS 的任务通知。典型坑:SIGPIPE 默认杀进程。
Socket——唯一能跨网络的IPC
int fd = socket(AF_UNIX, SOCK_STREAM, 0); // 本机int fd = socket(AF_INET, SOCK_STREAM, 0); // 跨机器
前面所有 IPC 只能本机用,Socket 既能跨进程也能跨机器。
System V IPC——工业现场的常客
POSIX IPC(mq_open/shm_open/sem_open)API 现代,但工业设备、车载系统、老 ARM Linux 项目里仍然大量用 System V IPC:
/* System V 共享内存 */key_t key = ftok("/tmp/shm_proj", 65);int shmid = shmget(key, 4096, 0666 | IPC_CREAT);char *str = (char *)shmat(shmid, NULL, 0);shmdt(str);shmctl(shmid, IPC_RMID, NULL);/* System V 消息队列(首字段必须是 long msg_type) */struct msg_buffer { long msg_type; char msg_text[100]; };int msgid = msgget(ftok("/tmp/msg_proj", 65), 0666 | IPC_CREAT);struct msg_buffer msg = { .msg_type = 1, .msg_text = "temperature:25.3" };msgsnd(msgid, &msg, sizeof(msg.msg_text), 0);
System V 用 key_t 命名、内核持久需显式 IPC_RMID 删除,信号量是信号量集可一次操作多个。排查用 ipcs -a 查看,ipcrm 删残留。
进阶要点:伪共享与内存屏障
共享内存上多核后有两个坑:伪共享——两个变量在同一缓存行频繁修改导致缓存失效,解法是按 64 字节对齐;内存屏障——写端先写共享内存再 sem_post,但 CPU 可能重排指令导致读端看到旧数据,解法是加 __sync_synchronize() 屏障。生产环境永远是共享内存 + 信号量 + 显式屏障成对出现。
本节要点:Linux IPC七大机制本质是"穿MMU墙"的不同方式,核心选管道/消息队列/共享内存+信号量/Socket四类。
四、性能对比与选型决策 数据驱动的IPC选择
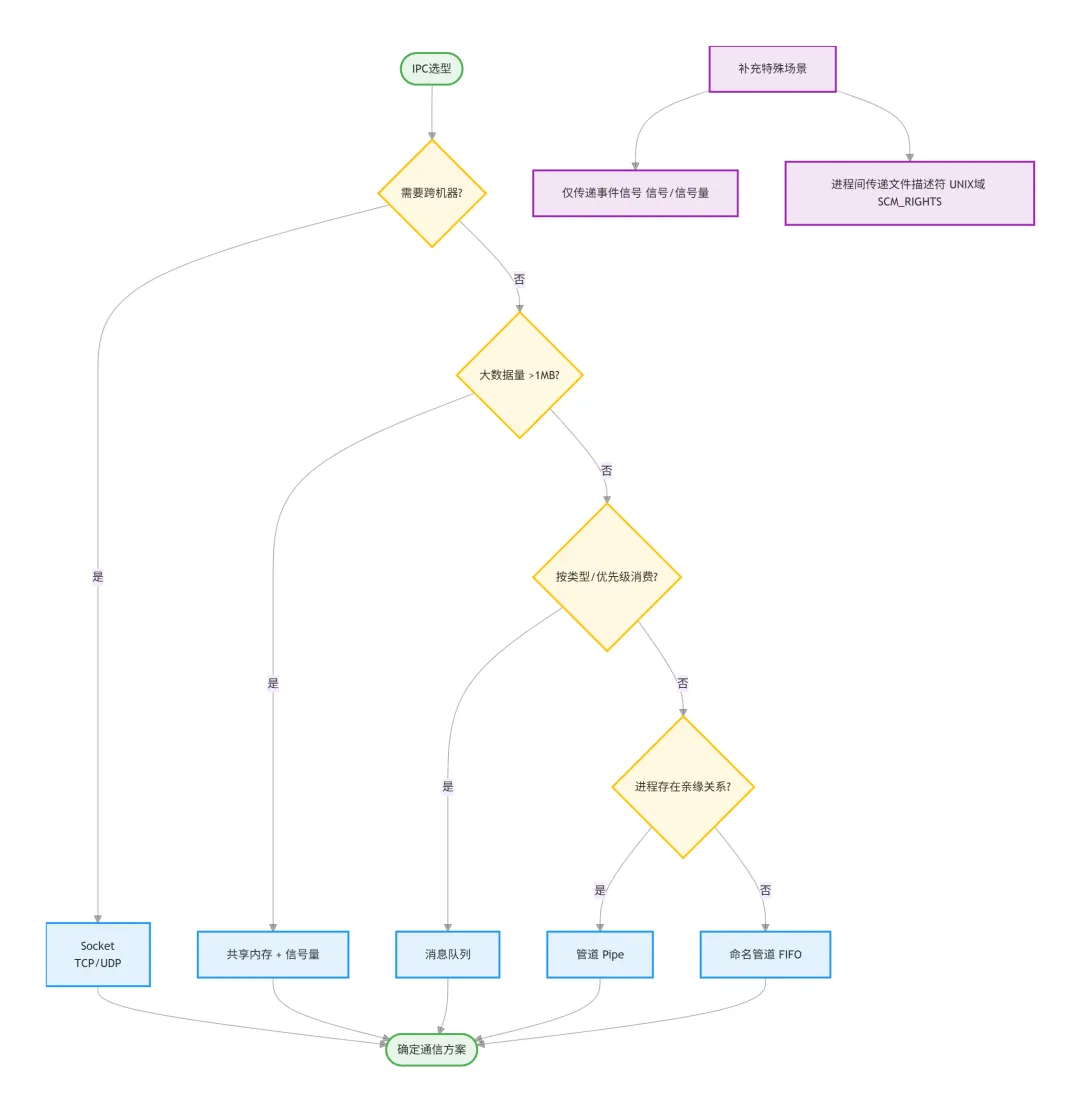
本节要点:跨机器用Socket,大数据用共享内存,排优先级用消息队列,父子进程用管道。
五、注意事项 实战踩坑记录
| | |
|---|
| | |
| | signal(SIGPIPE, SIG_IGN) |
| | |
| | |
| | |
| | setsockopt(SO_REUSEADDR) |
| | |
| | __sync_synchronize() |
本节要点:管道关端、SIGPIPE忽略、共享内存必加同步和屏障——这三个坑踩中任何一个都够调试半天。
六、总结 从MCU到Linux的IPC核心差异
- FreeRTOS 任务共享物理内存,IPC 就是"放数据到对方知道的地址"
- Linux 进程虚拟地址隔离,通信必须通过内核介入"穿墙"
- 共享内存 + 信号量对应 MCU 的全局变量,消息队列对应
xQueue,信号对应任务通知 - 选型口诀:管道传数据、共享内存传大块、消息队列排优先级、Socket 连网络
从 MCU 转 Linux 写 IPC,最大的认知转变是:默认你看不到对方的内存,所有通信都必须显式通过内核提供的通道。理解了这堵 MMU 的墙,两套体系就是一回事。
 10个月宝宝每天需要喝多少奶粉?