领导又来问我Linux驱动和裸机驱动的底层差异了,我能回答上来吗?
- 2026-10-11 05:34:51
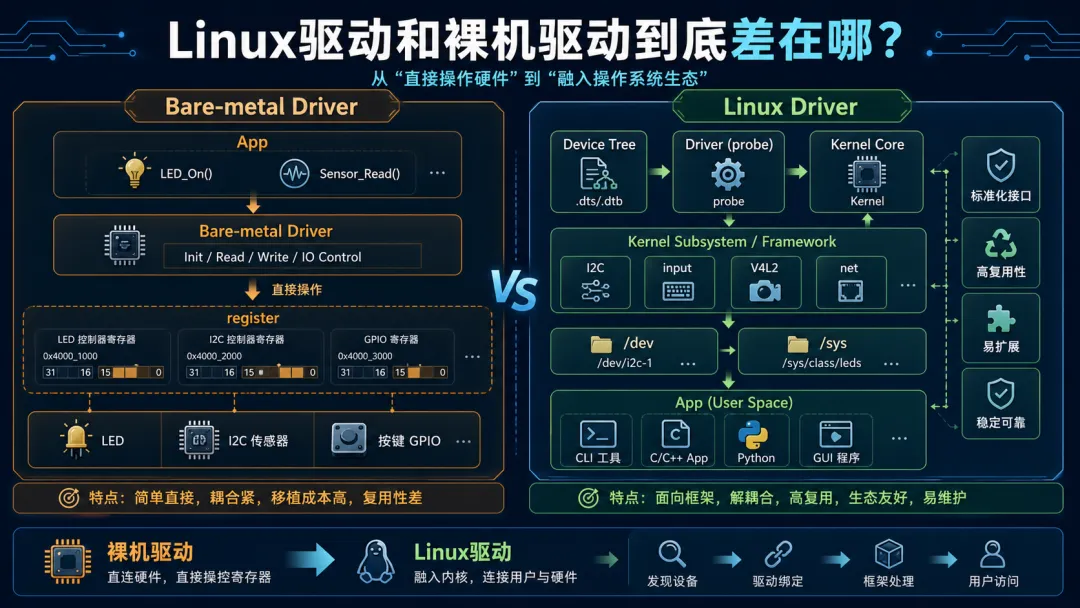
同样是读一个按键,Linux驱动为什么比裸机多出这么多东西
同样是读取一个 GPIO 按键。
裸机里,你配置 GPIO 输入,选好上拉,读电平,最多再加一个外部中断,事情基本就结束了。
到了 Linux,教程却突然冒出一串新东西:设备树、compatible、platform_driver、probe、input 子系统、/dev/input/eventX。底层明明还是那个 GPIO,为什么要绕这么远?
刚接触 Linux 驱动时,很容易把这些东西当成“内核规定的固定格式”,照着例程填完,设备也许能跑,但每一层为什么存在,还是没连起来。
其实两类驱动在最底层做的事情没有本质区别:配置硬件、读写寄存器、处理中断。真正的区别,是它们所处的系统不一样。
裸机驱动主要回答“我怎样控制这个硬件”;Linux 驱动还要回答“这个设备怎样成为系统里一项可管理的资源”。
沿着一个按键从上电到被应用读到的过程看,这个区别就清楚了。
一、裸机驱动直接,是因为很多条件已经确定
裸机或常见 MCU RTOS 项目里,硬件和软件通常是一对一配好的:板子型号确定,GPIO 编号确定,调用驱动的业务也在同一个固件中。
它的调用关系通常很短:系统启动时初始化 GPIO,业务需要时直接读取电平;如果使用中断,就在中断服务函数里记录按键事件,再交给任务处理。
启动初始化 GPIO 和中断 → 业务读取状态 → 得到按下或松开
编译以后,业务、驱动和板级配置一起进入同一份固件。谁初始化 GPIO、谁读取它、什么时候调用,工程本身已经约定好了。
这种直接并不是“低级”。硬件固定、资源有限、功能边界清楚时,它反而很合适。成熟的裸机工程一样可以拆成 HAL、BSP、驱动和业务层,也可以做得很漂亮。
但操作系统面对的情况更复杂。Linux 不能默认“GPIO 23 永远属于这个按键”,也不能允许任意应用直接改它,因为同一套内核可能运行在不同板卡上,系统里还有别的驱动和进程也在申请资源。
所以 Linux 需要把原本写死在工程里的信息拆开:板子上有什么,由硬件描述提供;谁能驱动它,由匹配规则决定;设备什么时候初始化,由内核统一调度;应用怎么使用,则由内核子系统定义。
二、Linux多出来的几层,分别解决什么问题
上一篇已经讲过设备树为什么要把板级信息从驱动里拆出来。这里不再重复各个属性,只沿着这个按键继续看后半段:设备描述出来以后,怎样真正落到驱动和应用手里。
设备树会描述板子上存在这样一个设备,它使用哪个 GPIO、触发沿是什么、compatible 是什么。驱动则声明支持哪些 compatible。两边对上以后,内核才把这个设备交给驱动。
驱动拿到设备后,不是立刻给应用暴露一个自定义函数,而是先接入合适的内核子系统。按键通常接 input 子系统,最后以标准输入事件的形式交给用户态。
整个过程大致是这样:
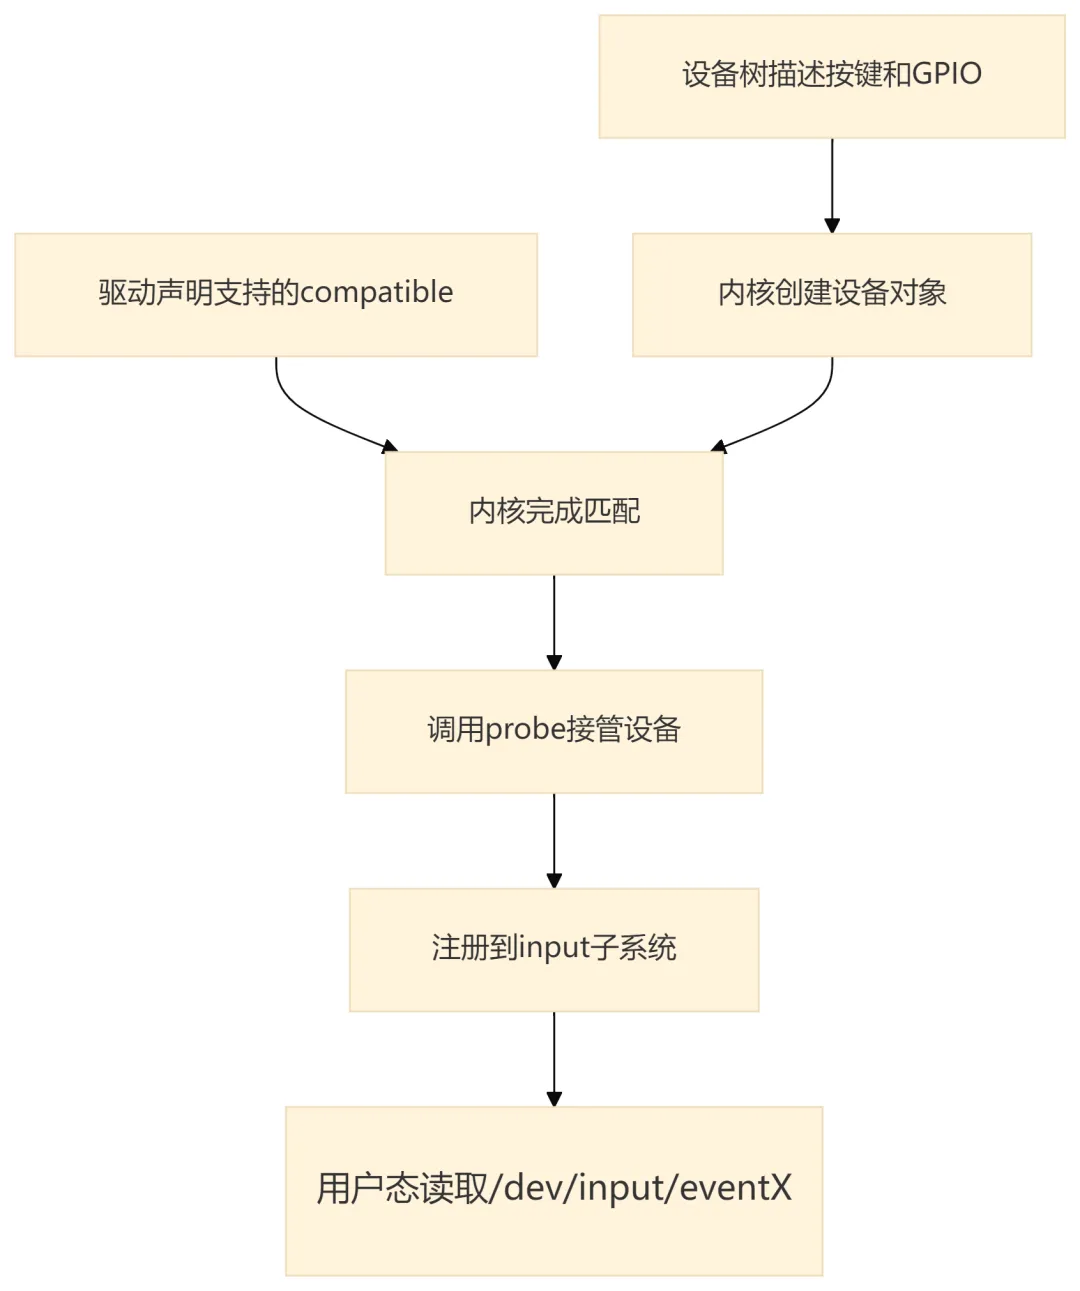
这里每一层都有具体作用:
probe | |
设备树也不是 Linux 发现设备的唯一方式。USB、PCI 等总线可以枚举设备,I2C、SPI 设备则常由设备树或 ACPI 描述。来源不同,后面“设备与驱动匹配,匹配后绑定”的思路是相通的。
三、probe到底是什么,谁在调用它
probe 最容易被名字带偏。
有人把它理解成“驱动主动扫描硬件”,甚至会到处找是谁在 main() 里调用了它。可在常见的平台设备驱动中,进入 probe 之前,内核已经根据设备信息和驱动匹配表完成了一轮匹配。
更准确的理解是:
probe是设备与驱动匹配成功后,由内核调用的绑定和初始化入口。
驱动注册时,会把自己的匹配条件和 probe 回调一起交给内核。可以把它看成一张简单的登记表:
compatible | |
probe | |
当设备树节点中的 compatible 与驱动匹配表对上,platform 总线就会调用这个驱动的 probe,并把当前设备实例及其资源交进来。
这句话里有两个重点。
第一,probe 不是应用调用的普通初始化函数。驱动只负责登记回调,调用时机由内核决定。设备先出现、驱动后加载可以匹配;驱动先注册、设备后出现也可以匹配。
第二,probe 面对的是一个具体设备实例。同一份驱动如果匹配到两个同型号设备,内核可以调用两次 probe,每次传入不同的设备和资源。驱动因此不能把所有状态都粗暴塞进一组全局变量里,通常要为每个设备保存自己的私有数据。
在 probe 里,常见工作并不神秘:
从设备描述中取得 GPIO、寄存器、中断、时钟等资源 向内核申请这些资源,避免和其他驱动冲突 初始化硬件并设置中断处理 向 input、IIO、V4L2 等子系统注册设备 保存后续读写和卸载时需要的设备状态
任何关键步骤失败,probe 都应该把错误返回给内核。此时内核不会假装设备已经可用,日志里通常也能看到绑定失败的原因。设备解绑或驱动卸载时,还要沿着相反方向注销接口、停止硬件并释放资源。
所以不要只把 probe 翻译成“探测”。有些驱动确实会在里面读取芯片 ID,确认硬件是否正常,但它更核心的含义是:从这里开始,这个驱动正式负责这个设备。
四、Linux驱动不一定要创建自己的/dev节点
从裸机转过来后,另一个常见习惯是:每写一个 Linux 驱动,就想注册字符设备,再设计一套 read()、write()、ioctl()。
这样当然能做,但不一定合适。
Linux 已经为很多设备类型定义了成熟子系统。接入正确子系统,上层就能使用已有工具和标准接口,不需要每个项目重新发明一套协议。
/dev/input/eventX | ||
/sys/class/leds | ||
/dev/videoX | ||
比如一个 GPIO 按键,内核已有 gpio-keys 驱动时,很多情况下只写设备树就够了,根本不需要再写一份私有驱动。这反而是理解 Linux 驱动框架后的正常选择:先找已有子系统和通用驱动,确实不适用时再自己实现。
字符设备更适合那些没有现成标准模型、又确实需要自定义用户接口的硬件。即使如此,也要先想清楚阻塞读写、并发访问、权限、错误码和 ABI 兼容,而不是只追求“能生成一个节点”。
五、读Linux驱动时,先抓住这条主线
Linux 驱动看起来比裸机驱动重,是因为它多承担了设备发现、资源归属、生命周期和用户接口这些系统级问题。复杂度并不全在寄存器操作上。
两者可以这样看:
probe | ||
这张表不是在判断谁更先进。裸机也能做出清晰的分层,Linux 也能写出一团糟。选择哪种模型,取决于产品需要的是一份紧凑固件,还是一个同时承载多设备、多进程和标准接口的完整系统。
以后再读一个 Linux 驱动,可以先别急着钻进每一行寄存器代码。先找四件事:
它属于哪条总线,靠什么信息完成匹配? probe取得了哪些资源,失败时返回什么错误?它注册进了哪个内核子系统? 用户态最终从哪里、用什么方式访问它?
这四个问题连起来,驱动的骨架就出来了。剩下的寄存器配置、中断处理和数据传输,才是这个具体硬件自己的部分。
归根结底,裸机驱动更关心“怎样把硬件控制起来”,Linux 驱动则要再往前走一步:让这个硬件被系统正确识别、可靠管理,并通过合适的接口交给应用。
相关文章
扒一扒设备树的外皮,看看它本质上是在做什么? Bootloader的简易介绍,领导认为你必懂的几个内容 一块嵌入式Linux板子上电以后竟然偷偷干了这么多事 嵌入式Linux和RTOS到底差异在哪?对比的意义在哪?
你第一次看到 probe 时,是把它理解成初始化函数,还是理解成内核主动扫描硬件?
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Linux 操作系统常见磁盘故障与完整解决方案(高级运维实战版)
- Python连载03|模块、包与高级语法:装饰器、生成器一次搞懂
- 小丸工具箱有Linux版了?!
- 同事炫耀他的 Python 代码只有十行,我展开一看,好家伙,每行都巨长.
- Python教程 - 前端入门:React/Vue 基础 + 调用 API
- 如果一个女生,从0开始学Python会怎么样?
- Linux Mint正式宣布Wayland稳定版可用
- Linux网络操作系统项目教程(欧拉/麒麟)(微课版)(第5版)
- Pydantic AI真的是Python开发者的AI框架首选吗
- 零基础吃透 Linux|全套学习笔记整理好了|