当前位置:首页>Linux>Linux 内核 - GPU Buddy 分配物理连续内存的巧思

Linux 内核 - GPU Buddy 分配物理连续内存的巧思

  • 2026-09-10 17:15:48
Linux 内核 - GPU Buddy 分配物理连续内存的巧思
GPU Buddy 是现代显卡主流物理内存分配器,基于经典伙伴系统(Buddy System)做二分拆分与合并,具备碎片控制好、元数据开销低的优势,常用来管理显卡 VRAM 物理连续内存。
GPU Buddy 同样支持连续物理内存分配,但在长期运行后 VRAM 碎片化会引发内存伪不足问题:总空闲内存充足,但无法分配出指定尺寸连续内存。
本篇文章,我们主要是关心这个连续物理内存分配能力。会重点分析一下 2023 年,AMD 工程师提交的一笔优化补丁,补丁名称为:drm/buddy: Improve contiguous memory allocation,优化目标是解决碎片场景下,物理内存分配伪不足问题。

什么是伪不足?先来看一下原生内核策略中的缺陷

原生 drm buddy 连续内存分配的核心规则:
  • 分配请求尺寸强制用 roundup_power_of_two() 向上对齐到最近 2 的幂阶整块
  • 直接查找对应 order 的完整空闲高阶伙伴块;若无整块空闲,直接返回 -ENOSPC,不再做进一步尝试
最小管理粒度 4K
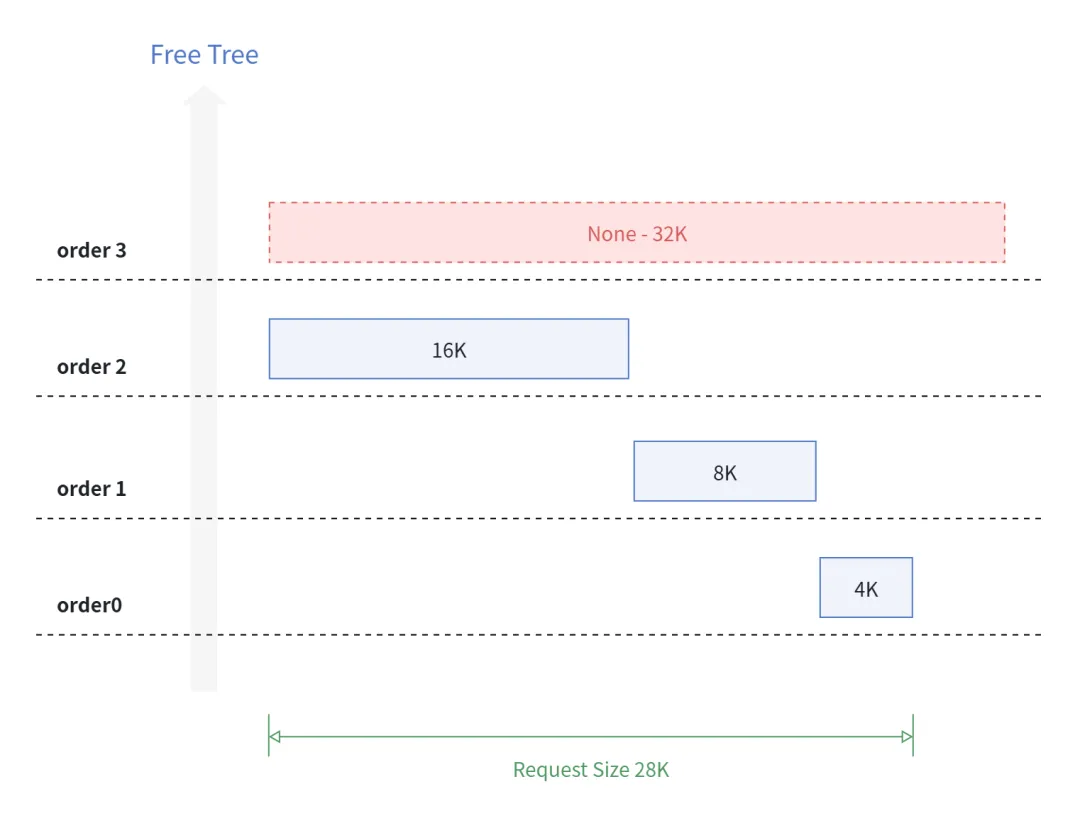
以上面示意图为例的话,在原始内核中当我们的分配请求大小为 28K 时,分配器默认的行为是先将请求进行 order size 对齐至 32K(order=5),随着 GPU 的长时间使用,许多内存块被 split 后使用,大块长连续内存将变得不再可得,所以在当前状态下内存分配请求将无法被满足。
但实际上,我们从图中也能看得到,符合要求的物理空间是存在的,但在 GPU Buddy 管理器上并不能直接体现出来。为了优化解决这个问题,文章最前面提到的 contiguous 分配算法应运而生。

contiguous 连续内存分配算法原理

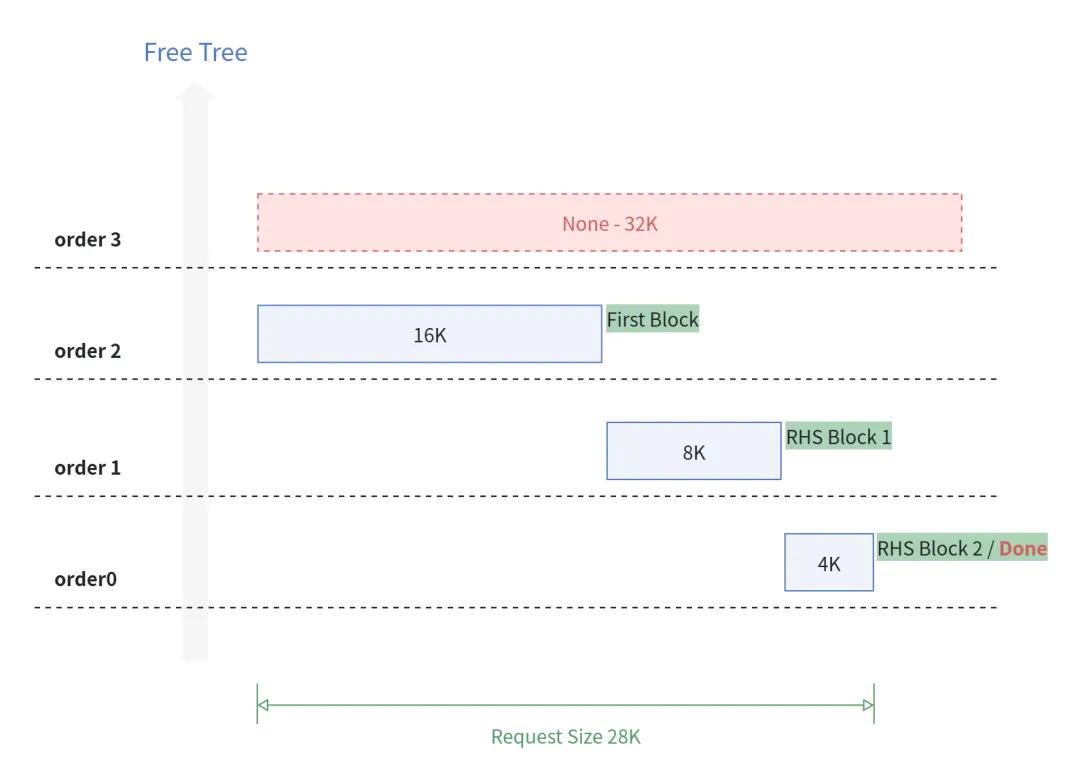
这个补丁新增 __alloc_contig_try_harder 后备路径,通过 DRM_BUDDY_CONTIGUOUS_ALLOCATION 标志触发,不再只依赖单一整块分配,而是在一块大空闲块内,同时尝试从RHS(右侧)和 LHS(左侧)逐步分段分配、拼接出满足精确尺寸和对齐要求的连续区域,把左右两侧可用空闲子块组合成一条物理连续内存,不再必须占用一整个高阶伙伴块。
常规内存请求仍走原有 buddy 路径保证性能,仅原生查找失败时才进入 try_harder 分支;算法会校验地址对齐与总长度,逐段锁定对应子块,同时维护原有 buddy 元数据结构,后续释放时可正常拆分回收、回归伙伴系统管理。
该方案可在碎片 VRAM 环境里提升大连续内存分配成功率,减少不必要内存浪费,但仅适用于同一块大空闲块内部的左右子块合并,无法跨完全不相邻的内存区域拼接,存在少量额外扫描开销,属于专用连续内存分配 fallback 逻辑而非全局默认模式。
对应到核心代码段:
list = &mm->free_list[order];if (list_empty(list))    return -ENOSPC;list_for_each_entry_reverse(block, list, link) {    /* Allocate blocks traversing RHS */    rhs_offset = drm_buddy_block_offset(block);    err =  __drm_buddy_alloc_range(mm, rhs_offset, size,                       &filled, blocks);    if (!err || err != -ENOSPC)        return err;    lhs_size = max((size - filled), min_block_size);    if (!IS_ALIGNED(lhs_size, min_block_size))        lhs_size = round_up(lhs_size, min_block_size);    /* Allocate blocks traversing LHS */    lhs_offset = drm_buddy_block_offset(block) - lhs_size;    err =  __drm_buddy_alloc_range(mm, lhs_offset, lhs_size,                       NULL, &blocks_lhs);    if (!err) {        list_splice(&blocks_lhs, blocks);        return 0;    }}
仍按照刚刚的场景为例的话,新算法会从order 2(order 0111B 首位)处的 Block 尝试 RHS继续搜寻,直至匹配成功。
最小管理粒度 4K

参考资料:

https://git.kernel.org/pub/scm/linux/kernel/git/next/linux-next.git/commit/drivers/gpu/drm/drm_buddy.c?id=0a1844bf0b532d84324453374ad6845f64066c28

最新文章

随机文章