别急着写策略,量化的第一步,是先把一段数据,真真切切地拿到你手里。
你大概见过这样的画面:有人聊量化,张口就是夏普比率、机器学习、因子挖掘,听着特别高级。
然后你打开电脑,想自己动手试试——
第一个问题就卡住了:数据,从哪来?怎么进到我的程序里?
不是不会写策略,是连「策略要处理的那张表」都还没在手上。
这一篇,我们就只解决这一件事。不灌鸡汤,不画大饼,就带你把环境装好,把第一段真实行情读进程序、打印出来看一眼。
这是第七季《用 Python 做量化》的第 ① 篇,先把整季的框架立起来。
回头看走过的路:
- • 第一季讲道——认知、风控、为什么人脑做不好交易;
- • 第二季讲术——我们用 MQL5 一行行写了个 EA,挂到 MT5 上跑;
- • 第四季讲验——回测会怎么骗你、前视偏差、过拟合、样本内外、walk-forward,一整套回测方法论。
这一季,是器:用工具把前面那些「想清楚的道理」和「验过的方法」,亲手落成代码。
说白了,第七季是第二季的姊妹篇。
那一季我们用 MQL5,这一季换成 Python——一个更通用、门槛更低的工具。
第四季告诉你「回测该怎么做才不骗自己」,这一季,我们就用 Python 把那套方法,一行行写出来。
为什么换 Python?下一节说。先记住这一季要走的那条线。
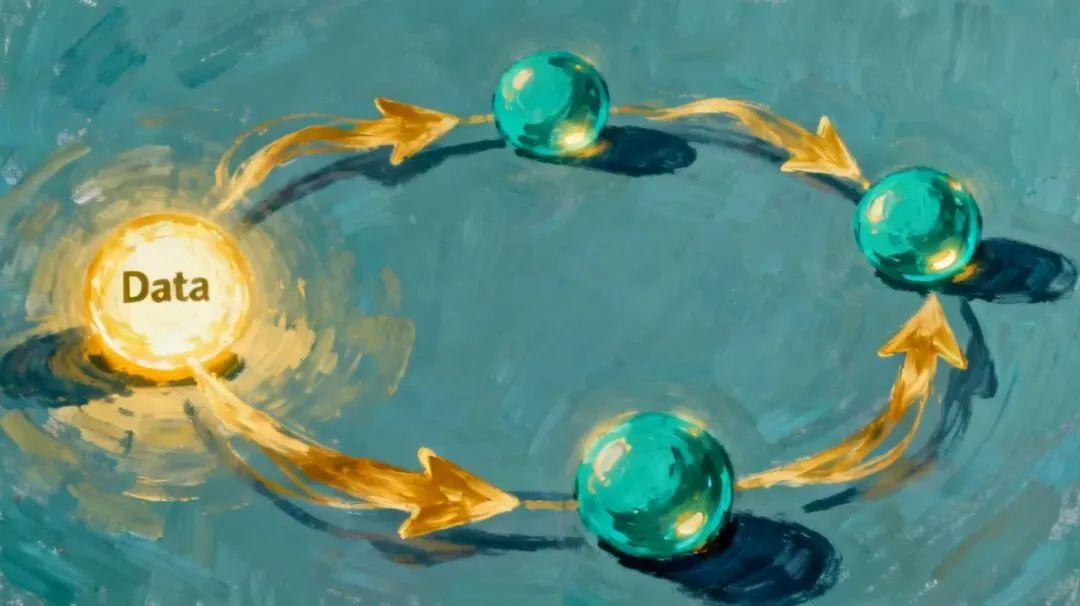
整个量化研究,其实是一个很朴素的闭环:
数据 → 指标 → 信号 → 回测 → 评估。
- • 评估:算清资金曲线、回撤、夏普,判断它到底行不行。
这一季 10 篇,正好把这个圈走完一整圈。
而今天这第 ① 篇,只解决最左边那个节点:数据。
数据都没进到程序里,后面四步都是空中楼阁。
这很「0.01手」——从最小处起步,先把一段数据跑通,别一上来就追求大而全。
🐍 为什么是 Python,它的边界又在哪
上一季我们用 MQL5,这一季为什么要换?
不是 MQL5 不好,而是两件事用的工具不一样。
先说 Python 顺手在哪:
- • 生态成熟:
pandas 处理表格、numpy 做数值计算、matplotlib 画图——做数据分析和回测研究,这套组合几乎是行业标配; - • 上手快:语法干净,几行代码就能读数据、算指标,不用陷在繁琐的类型声明和编译里;
- • 研究效率高:你想验证一个想法,在 Python 里改几行、跑一下、看结果,循环极快。
一句话:做研究、做回测、做分析,Python 比 MQL5 顺手得多。
但这里必须把话说死,免得你产生误会:
Python 顺手的是「研究」,不是「实盘挂单」。
真正要把策略挂上去、7×24 盯着行情自动下单,多数人最后还是会回到 MT5、回到券商接口。因为实盘要的是稳定、低延迟、和交易终端深度集成——这恰恰是 MQL5 那种「长在 MT5 里」的工具擅长的。
所以这一季的定位很清楚:
- • Python 负责:研究、回测、分析——在历史数据上把想法验明白;
- • MT5 / 交易接口负责:把验明白的策略,真正挂到市场上去跑。
两者是互补,不是替代。
「研究里用 Python、实盘怎么落地」这中间隔着什么——是个大话题,我们留到本季第 ⑨、⑩ 篇专门讲。
今天,先回到最具体的事:把环境装上。
🔧 动手:装环境,把第一段数据拉到手里
不啰嗦,跟着做。这一步做完,你手里会有一张真实的、可操作的行情数据表。
第一步,装 Python。
两条路,挑一条:
- • Anaconda(推荐新手):一个安装包,把 Python 和
pandas、numpy 这些常用库一次装齐,省去到处装库的麻烦; - • 官方 Python:从 python.org 装好后,再用一行命令补装库:
pip install pandas
这行命令的意思很直白:让 Python 把 pandas 这个处理表格的工具下载装好,之后才能用它。
第二步,把第一段数据读进来。
数据从哪来?最朴素的方式——一个 CSV 文件。
CSV 就是个纯文本的表格,逗号分隔,长得跟 Excel 导出来的没两样。很多平台、数据源都能导出日线或小时线行情成 CSV。你先随便拿一段到手,比如一只标的的日线历史。
然后,把它读进 Python,就这么三行:
import pandas as pddf = pd.read_csv("data.csv")print(df.head())
逐行用大白话讲它在干嘛:
- • 第一行
import pandas as pd——把 pandas 这个工具请进来,给它起个简称叫 pd,后面少打几个字; - • 第二行
pd.read_csv(...)——让 pandas 去读那个 CSV 文件,把里面的表格装进一个叫 df 的变量里(df 是 DataFrame 的简称,你就理解成「程序里的那张表」); - • 第三行
print(df.head())——把这张表的前几行打印出来看看,head() 默认给你看头 5 行。
按下回车,屏幕上就会蹦出一张整整齐齐的表:
- • 每一列是一个字段(开盘价、最高、最低、收盘、成交量……)。
那一刻,事情就变了。
刚才那段行情,还只是硬盘上一个看不懂的文件;现在,它是程序能处理的一张结构化数据表了。
你能 print 出这张表,就等于跨过了量化最实在的第一道门槛。
很多人卡在「量化是不是很难、要不要先学一年编程」——但你看,把数据弄进程序,本质就这三行。
剩下的,无非是在这张表上一点点做文章:算指标、出信号、跑回测。但底层逻辑,和这第一段数据,是一脉相承的。
这也正是「0.01手」的内核——别一上来就追求大而全,先用最少的代码、把最小的一段数据跑通,闭环跑通了,再慢慢加东西。
第一段数据能进到程序里,量化对你来说,就从「听别人说」变成了「自己动手」。
说明:本系列为纯编程与数据科普,文中代码仅作演示,非交易建议。任何涉及策略、信号的示例都仅为技术学习,请务必只在历史数据和模拟环境里练习。
📌 小结
- • 这一季是「器」:用 Python 把第四季「验」的回测方法论亲手落成代码,是第二季 MQL5 的姊妹篇——换更通用、门槛更低的工具。
- • 量化的最小闭环:数据 → 指标 → 信号 → 回测 → 评估,本季 10 篇走完一圈;第 ① 篇只解决「数据怎么进程序」。
- • 为什么 Python:生态成熟(pandas/numpy/matplotlib)、上手快、研究效率高;但边界要清楚——Python 适合研究回测,实盘挂单多数人仍回到 MT5/接口。
- • 今天动手的成果:装好 Python,用三行代码把一段 CSV 行情读进程序、
print 出一张结构化数据表。 - • 真正的收获:不是这三行代码,而是你确认了——量化的起点,是先有数据;而把数据拿到手,没那么难。
下一篇预告 ②数据是拿到了,但它往往是「脏」的——时间没对齐、有缺口、列名乱、类型不对。下一篇我们用 pandas 把这段 K 线数据捋顺:设好时间索引、对齐、清掉缺失值,让它真正能用。一张干净的数据表,才是后面所有计算的地基。
如果这一篇让你觉得「原来我也能上手量化」,点个赞和在看,关注「0.01手」,跟着这一季一行一行把量化研究的闭环搭起来。
本文仅为个人学习记录与编程笔记,所涉代码与方法均为技术科普,非交易建议,不构成任何操作建议。市场有风险,据此操作风险自负。
 10个月宝宝每天需要喝多少奶粉?