上一章我们用Pydantic把自由文本规整成有字段、有类型、有校验的实体,终于可以让Java后端像接普通接口一样接AI结果。
但很快你就会遇到一个新问题:
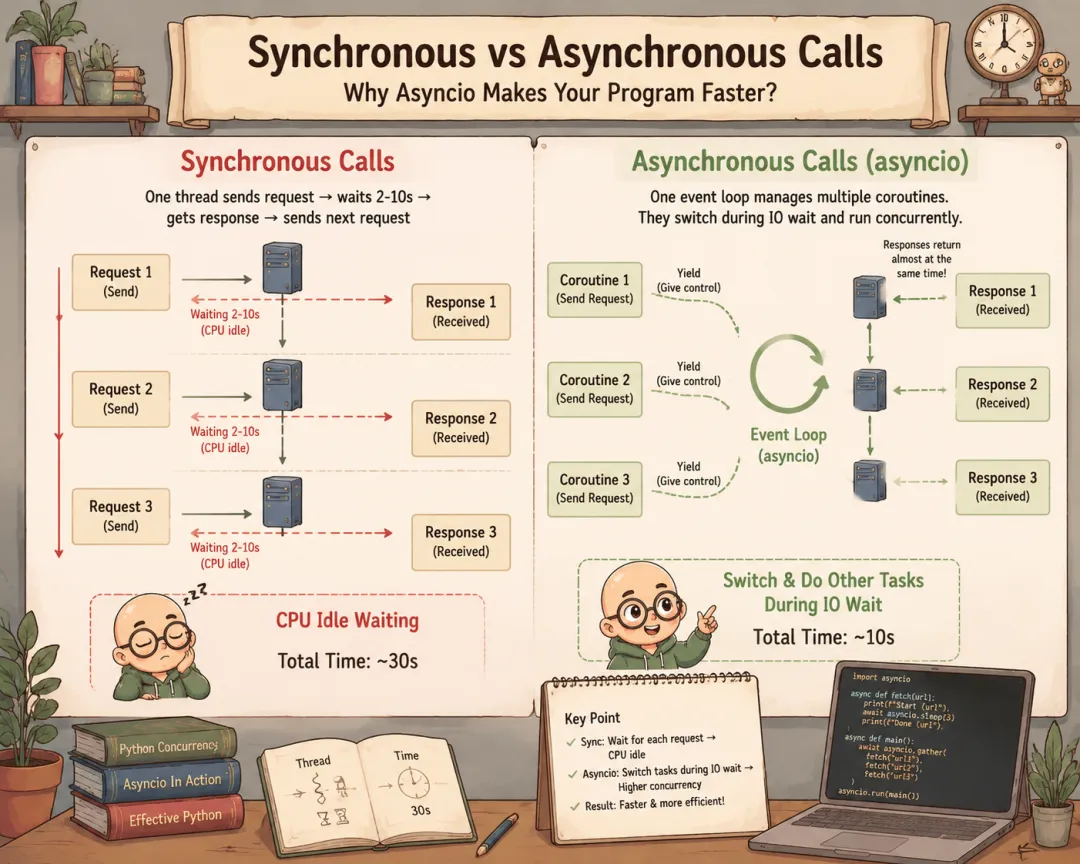
如果所有调用都“一个接一个”地跑,整个系统响应会非常难看。
这一章就专门解决一件事:
如何用Python的async异步机制,把AI调用从“串行排队”变成“并发、流式输出”,为后续LangChain流式接口和SSE打基础。
一、Java后端视角:先搞懂,LangChain为什么绕不开async?1、大模型API是重度IO阻塞场景,同步代码性能致命
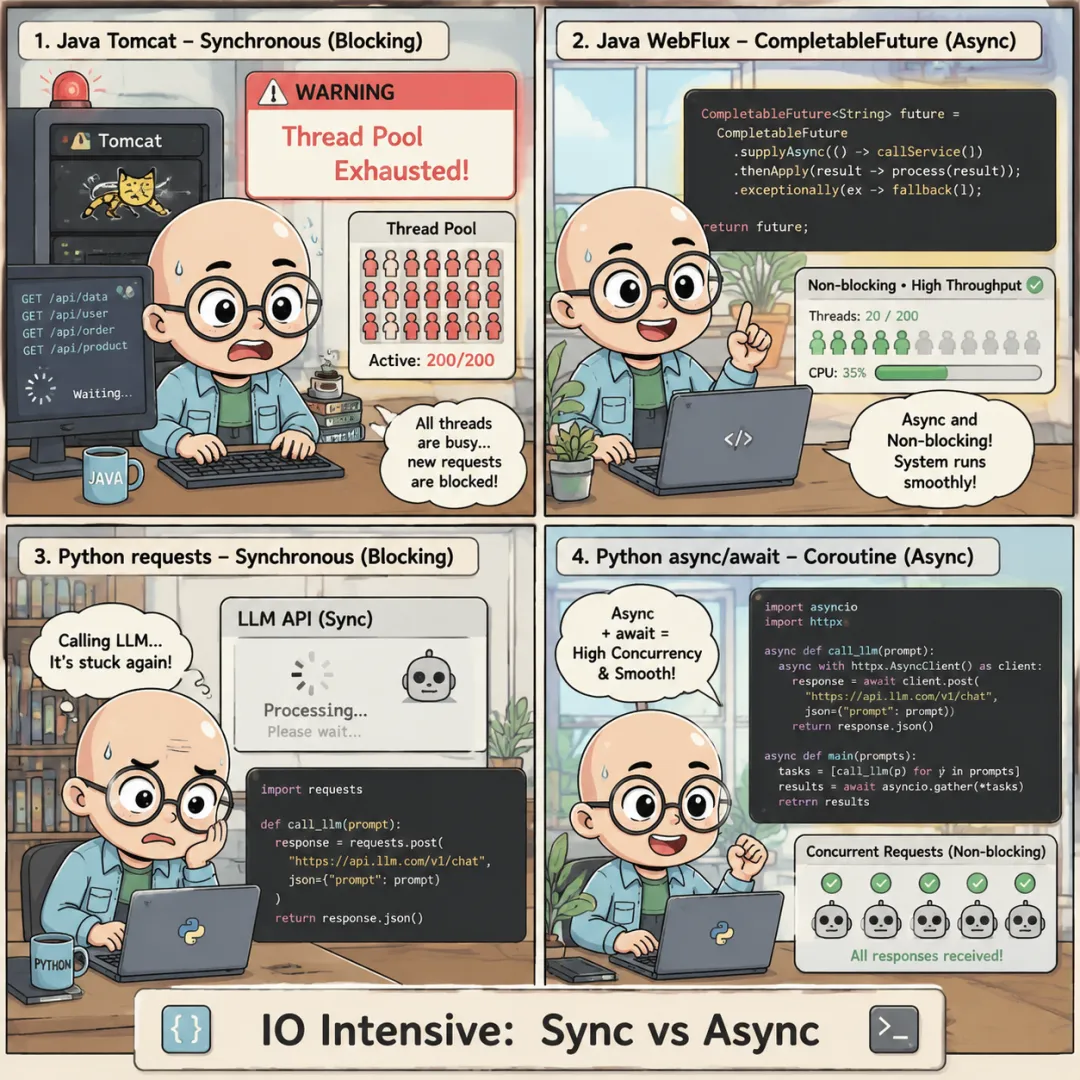
Java中的同步阻塞线程池,每一条请求占用一个线程,调用外部大模型API时,线程全程卡死等待返回,并发高时线程池直接打满、服务雪崩。
Python原生同步requests同理,同步调用llm.invoke():发起HTTP请求后,整个程序卡死,等待模型完整生成全部文字才释放资源。一个问答生成需要3~10秒,如果多用户同时访问,服务直接卡死无响应。
RAG场景要同时调用向量库、文档解析、大模型三重I/O,同步串行执行耗时翻倍。
所以Python的async异步机制,把AI调用从“串行排队”变成“并发、流式输出”,来进一步提升并发调用的效率。
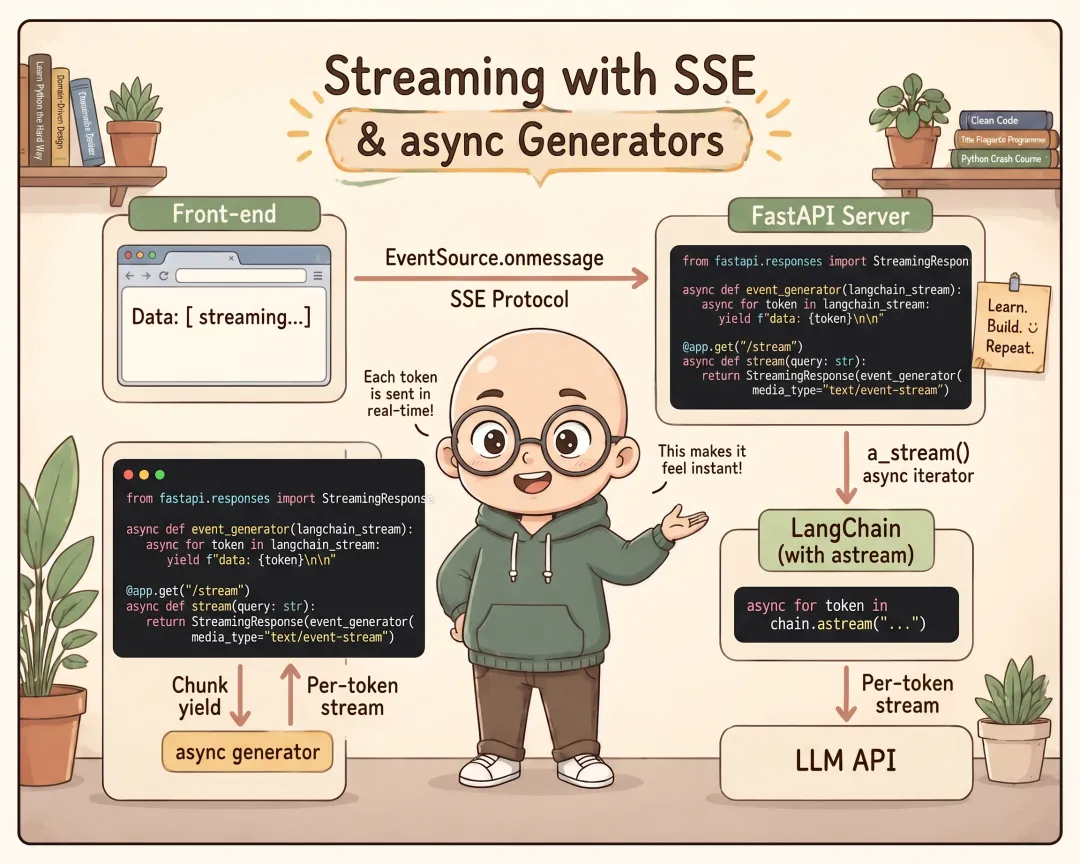
2、前端“打字机”流式对话,底层强制依赖异步流
现在所有AI产品(ChatGPT、企业知识库问答)都是逐字输出,而非等待几秒一次性返回全文,这套能力依赖SSE(Server-Sent-Events)流式协议:
二、Java vs Python异步核心概念对照,快速切换思维
干Java的不用从零理解异步,直接对标我们熟悉的技术:
维度 | Java | Python |
并发模型 | 线程池+同步阻塞I/O | 协程+事件循环 |
典型写法 | CompletableFuture 、WebFlux 、@Async | async def + await + asyncio.gather |
I/O等待时 | 线程阻塞,占用线程资源 | 协程挂起,事件循环可调度其他协程 |
适合场景 | 计算密集+阻塞I/O混合 | 大量I/O等待、少量CPU的场景(AI调用非常典型) |
调试难度 | 线程堆栈直观 | 协程堆栈有时不太直观,需要多练 |
协程:用户态轻量级子程序,程序自行调度,切换开销极小,单线程内就能并发。关键差异(Java 开发者最容易踩坑)
Java异步靠多线程实现并发,Python async靠单线程事件循环切换协程,没有线程切换开销,I/O密集场景效率更高
Java同步代码可随意嵌套异步,Python 同步函数不能直接await,所有 I/O操作必须封装async函数
Java流式输出兼容同步/异步,Python LangChain流式推荐全链路 async,同步stream生产环境极易出现连接超时、断流。
三、Python async基础语法:AI开发最小必备集
同步非流式(最基础):
# invoke:同步阻塞result = llm.invoke("讲个笑话")print(result.content) # 等全部生成完才打印
异步非流式(Web服务用):
# await a:异步挂起等待,但不阻塞result = await llm.ainvoke("讲个笑话")print(result.content)
同步流式(命令行工具用):
# llm.stream:同步流式生成器for chunk in llm.stream("讲个笑话"): print(chunk.content, end="") # 逐字打印
异步流式(Web SSE推送用):
# llm.astream:异步流式生成器(async for + astream)async for chunk in llm.astream("讲个笑话"): print(chunk.content, end="") # 异步逐字输出
流式输出的本质
需要特别说明一点,流式输出不是LangChain发明的功能,而是大模型本身就支持的能力。
大模型生成文本时是逐字/逐token生成的,不是一次性全部算出来再返回。流式输出就是把模型生成过程中的每个片段实时推送给客户端。
LangChain的stream()/astream()只是把模型的这个原生能力通过标准接口暴露出来。如果底层模型不支持流式输出,框架再怎么封装也做不到真正的流式。
四、Java转Python写异步,最容易踩的5个坑
1、同步函数直接调用await
2、忘记开启llm streaming=True
astream返回完整文本,无法分片输出,打字机效果失效。
3、SSE接口忘记media_type="text/event-stream"
前端EventSource无法识别流式数据,一次性接收全部内容。
4、混用同步requests做模型调用
阻塞事件循环,异步并发完全失效,推荐用httpx.AsyncClient异步HTTP客户端。
5、没有处理异步异常
大模型超时、网络失败、向量库连接中断会直接杀死整个事件循环,所有异步任务崩溃。
LangChain用async,是因为AI应用本质上是IO密集型(调用LLM API要等2-10秒),而Python的asyncio能用单线程高效处理大量并发IO等待,比Java的线程池方案内存占用小得多。
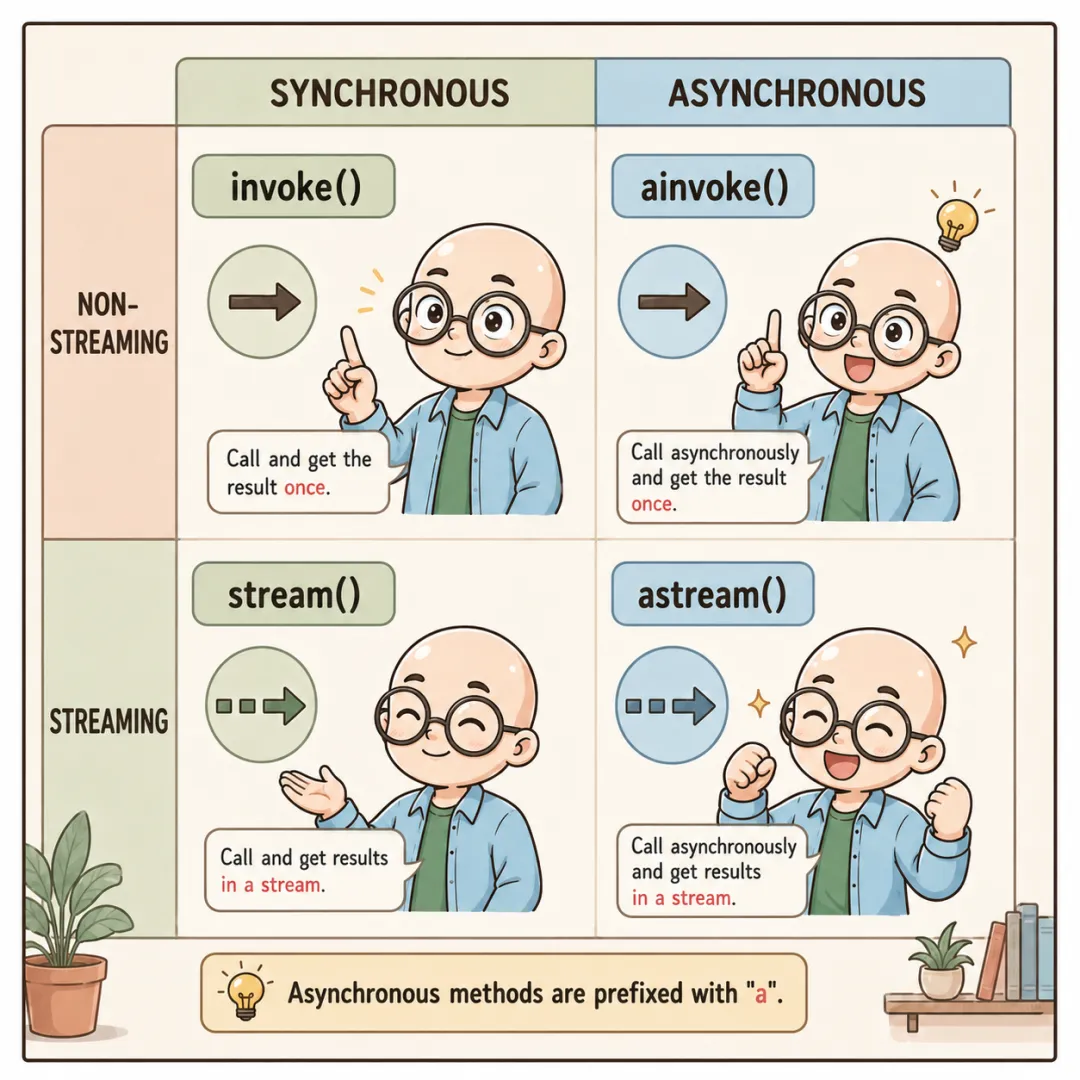
记住LangChain的命名规律:凡是同步方法,异步版本加a前缀:
invoke → ainvoke
stream → astream
batch → abatch
下一章开始,我们会正式进入第二部分LangChain的核心基础,从“LLM、ChatModel、PromptTemplate、Chain”这些概念开始,逐步把AI应用搭起来。一定要点赞关注收藏哟!~
备注:有需要上述项目完整代码和示例文件的同学可以关注公众号后台私信领取😄刚从Java转Python时,我用线程池思维写异步,结果服务卡成PPT。后来才悟了:await不是"等结果",而是"我先让出CPU,好了喊我"。
这种协作式调度对IO密集型很友好,不用开几百个线程,单线程轻松扛高并发。
对企业来说,异步、流式不是花活,是AI系统能稳定承载并发用户的底层根基。
对开发来说,异步不是“高级语法”,而是“性能与体验的工程选择”。
下期预告:【码途手记-AI】第7章:LangChain是什么?从一个后端开发者视角理解它的核心组件
互动提问:你有没有被同步阻塞线程池坑过?评论区聊聊踩坑经历。