使用 Python 和 C++ 数值积分计算圆周率 Pi
- 2026-09-07 14:10:41
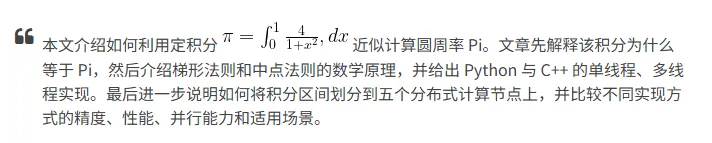
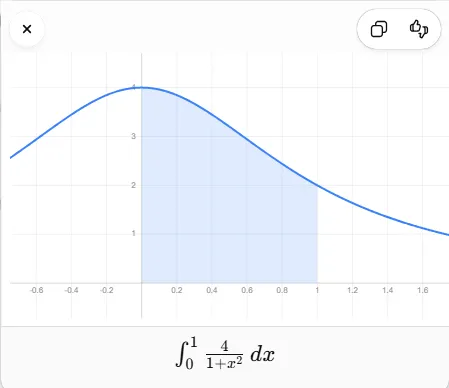
圆周率 Pi,通常写作  ,广泛出现在数学、物理、工程、统计学和计算机科学中。虽然大多数编程语言都已经提供了内置的 Pi 常量,但亲自计算 Pi 仍然是学习微积分、数值积分、多线程和分布式计算的一个很好的学习的例子。
本文将通过下面这个定积分计算 Pi:
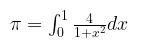
本文将介绍:
为什么这个积分等于 Pi 数值积分如何近似计算定积分 梯形法则 中点法则 单线程 Python 实现 多线程 Python 实现 单线程 C++ 实现 多线程 C++ 实现 如何将同一个算法分配到五个计算节点上
为什么这个积分等于 Pi?
考虑下面的定积分:

关键在于,反正切函数的导数是:
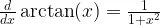
因此:
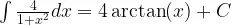
将积分上下限零和一代入:
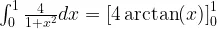
也就是:
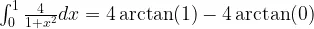
我们知道:
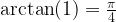
并且:
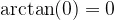
因此:
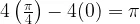
所以:
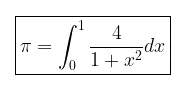
这就为我们提供了一种通过数值积分计算 Pi 的方法。
数值积分是如何工作的?
计算机不一定要通过符号运算直接求出积分的解析解。它可以把积分区间分成许多很小的部分,然后近似计算曲线下面的面积。
假设我们需要计算:
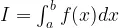
将区间  分成
 个长度相等的小区间。
每个小区间的宽度为:

划分区间的各个点为:

其中:
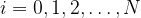
近似计算每一个小区域的面积有多种方法。两种常见的方法是:
梯形法则 中点法则
梯形法则
你可能记得的那个包含  、
 和除以二的公式,就是梯形法则。
对于从  到
 的一个小区间,我们使用一条直线连接函数在两个端点上的值。
这样形成的区域是一个梯形。
它的面积近似为:
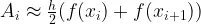
将所有梯形的面积相加,可以得到:
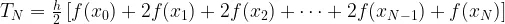
一个等价并且通常更容易编程实现的公式是:
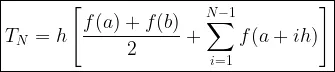
两个端点只计算一半的权重:

所有内部点使用完整权重:
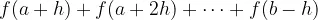
对于我们的 Pi 积分:

并且:
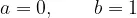
因此:

梯形法则对 Pi 的近似公式为:
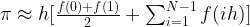
因为:
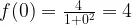
并且:
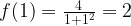
所以还可以写成:
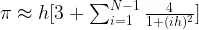
一个简单的梯形法则示例
假设我们把积分区间分成四份:

每个小区间的宽度为:
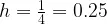
五个边界点为:
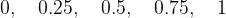
函数在这些点上的值大约为:

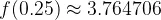
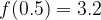
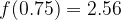

应用梯形法则:
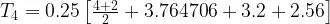
因此:
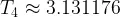
Pi 的真实值大约为:
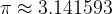
即使只划分为四个小区间,我们也已经得到了一个比较合理的近似值。增大  可以进一步提高结果的精度。
中点法则
本文后面的主要代码使用的是中点法则。
梯形法则在每个小区间的边界上计算函数值,而中点法则在每个小区间的中心位置计算函数值。
第  个区间的中点为:
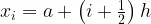
该小区间的面积可以近似看成一个矩形:
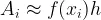
将所有矩形面积相加:
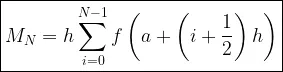
对于 Pi 的积分, 、
 ,并且
 。
因此:
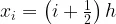
并且:
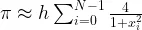
代入  :
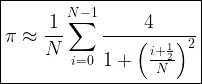
 越大,计算结果通常越接近 Pi 的真实值。
梯形法则与中点法则的比较
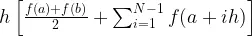 | ||
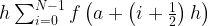 |
对于足够平滑的函数,这两种方法的误差通常都与下面的量成正比:

不过,在使用相同数量小区间的情况下,中点法则通常比梯形法则更加精确。
使用中点法则的单线程 Python 实现
下面的 Python 程序将积分区间划分成 2500 万个小区间。
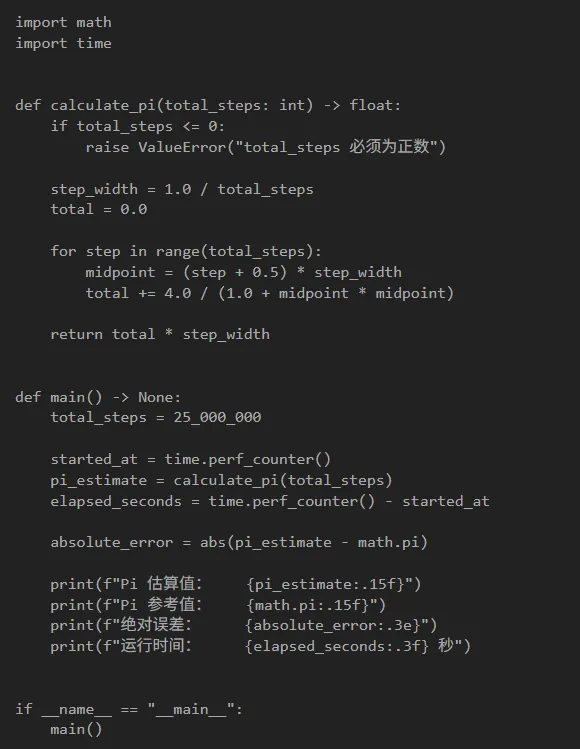
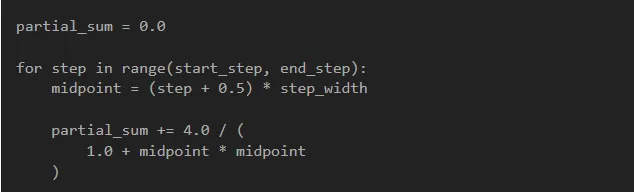
核心计算代码是:
midpoint = (step + 0.5) * step_width total += 4.0 / (1.0 + midpoint * midpoint)第一行计算当前小区间的中点:
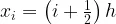
第二行计算函数值:
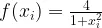
在累加所有函数值之后,再乘以每个小区间的宽度:
return total * step_width这在数学上对应:
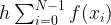
使用梯形法则的单线程 Python 实现
梯形法则版本在各个小区间的边界位置计算函数值,而不是在中点计算。
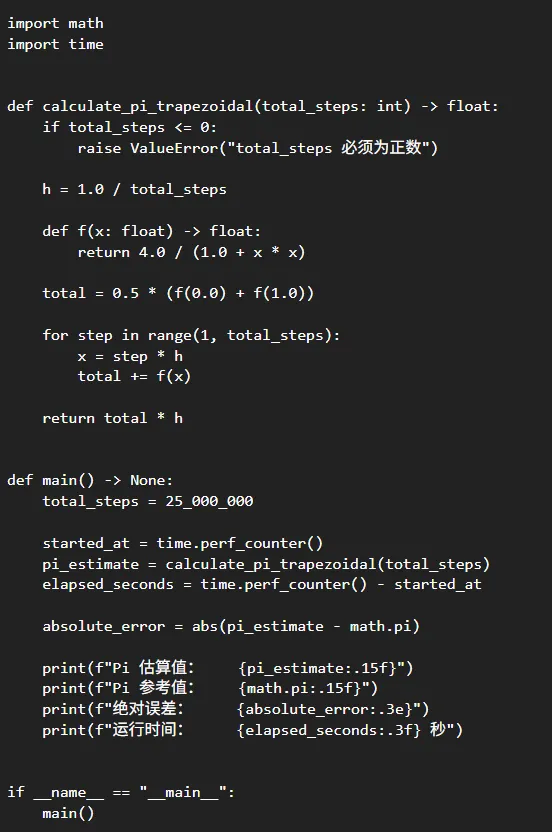
两个端点的贡献通过下面的代码计算:
total = 0.5 * (f(0.0) + f(1.0))这对应:

循环计算所有内部点的函数值之和:
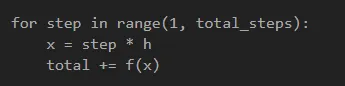
这对应:

最后再乘以  :
return total * h使用中点法则的多线程 Python 实现
我们可以把 2500 万个小区间分配给五个工作线程。
对于总共  个工作线程中的第
 个工作线程,它的起始位置为:
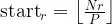
结束位置为:
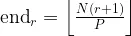
对于五个工作线程和 2500 万个小区间:
下面使用 ThreadPoolExecutor实现:
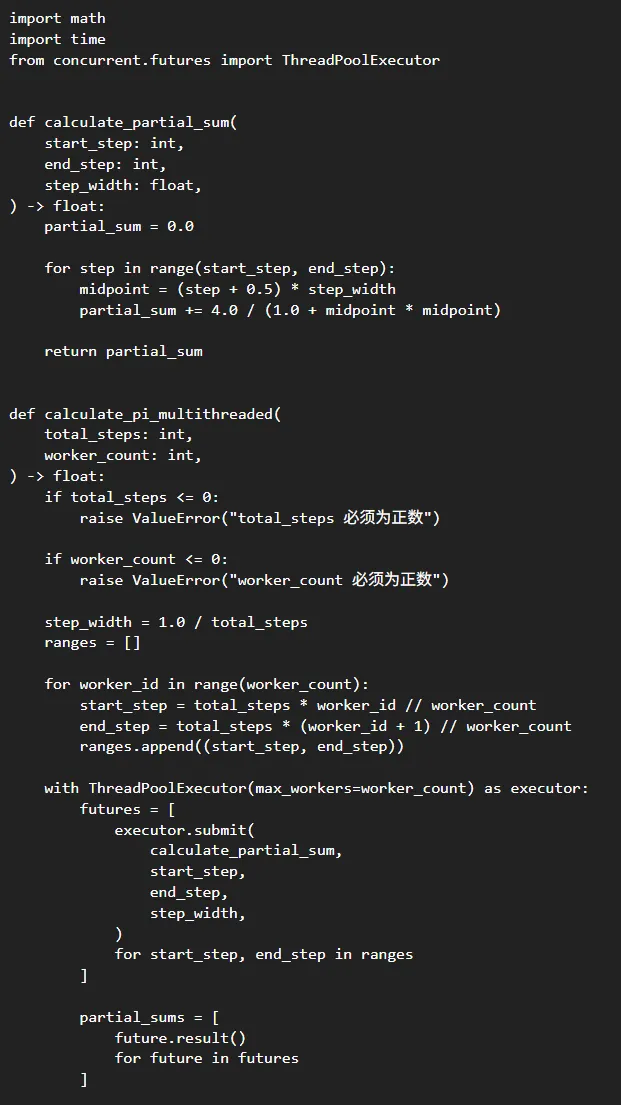
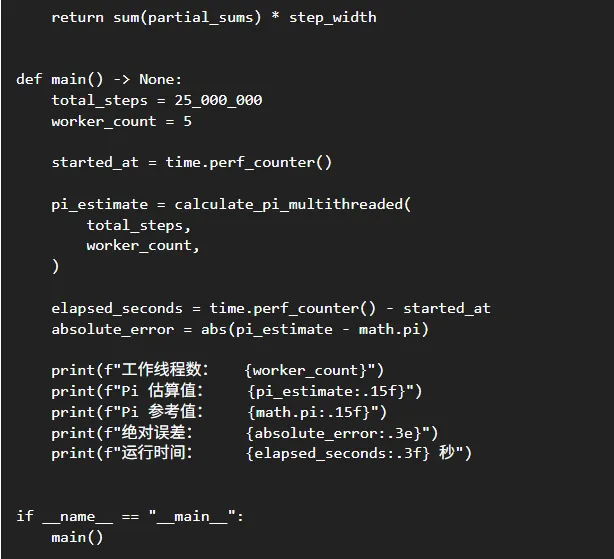
每个工作线程计算一个部分和:
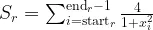
主线程再把这些结果合并起来:
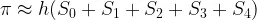
Python 多线程的一个重要限制
这个多线程 Python 版本展示了如何把计算划分为多个独立区间,但它不一定比单线程版本运行得更快。
标准 CPython 存在全局解释器锁,也就是通常所说的 GIL。
对于 CPU 密集型 Python 代码,在同一时刻通常只有一个线程能够执行 Python 字节码。
因此,五个 Python 线程并不意味着能够有效地同时使用五个 CPU 核心。
这个多线程版本可能会出现以下情况:
运行速度与单线程版本基本相同 由于线程管理开销,运行速度反而稍慢 适合演示如何分配计算任务 不适合在普通 CPython 中实现真正的 CPU 并行计算
如果需要在 Python 中实现真正的 CPU 并行,可以考虑:
ProcessPoolExecutormultiprocessing模块 NumPy 本地编译扩展 MPI 独立的分布式进程
使用中点法则的单线程 C++ 实现
C++ 非常适合执行这种紧密的数值循环,因为它可以被编译为本地机器代码/Native Code。
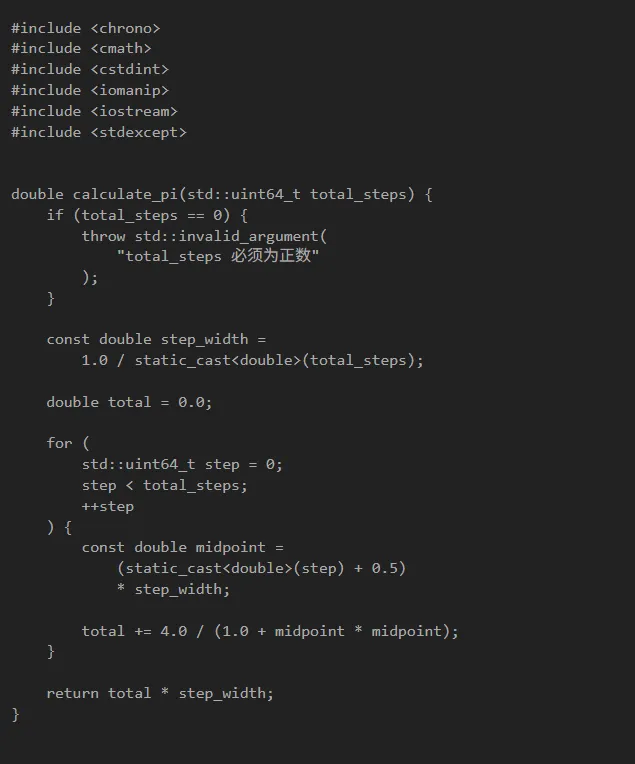
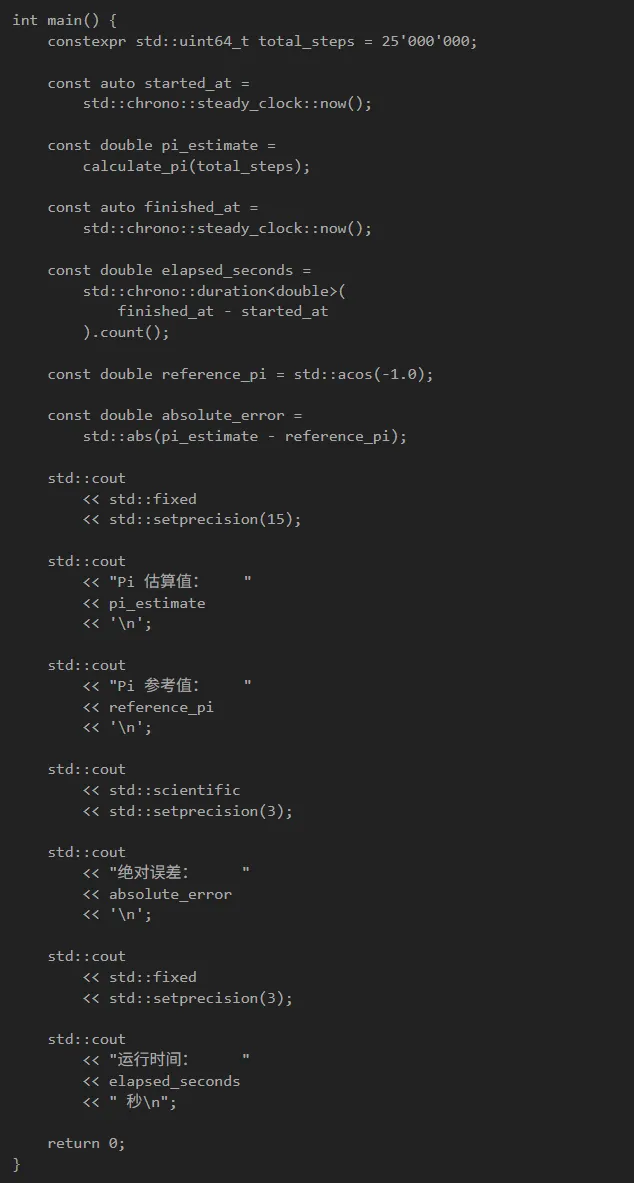
使用优化选项进行编译:
g++ -O3 -std=c++17 pi_single.cpp -o pi_single运行程序:
./pi_single-O3选项会启用较为激进的编译器优化。如果不启用优化,程序的运行速度可能会慢很多。
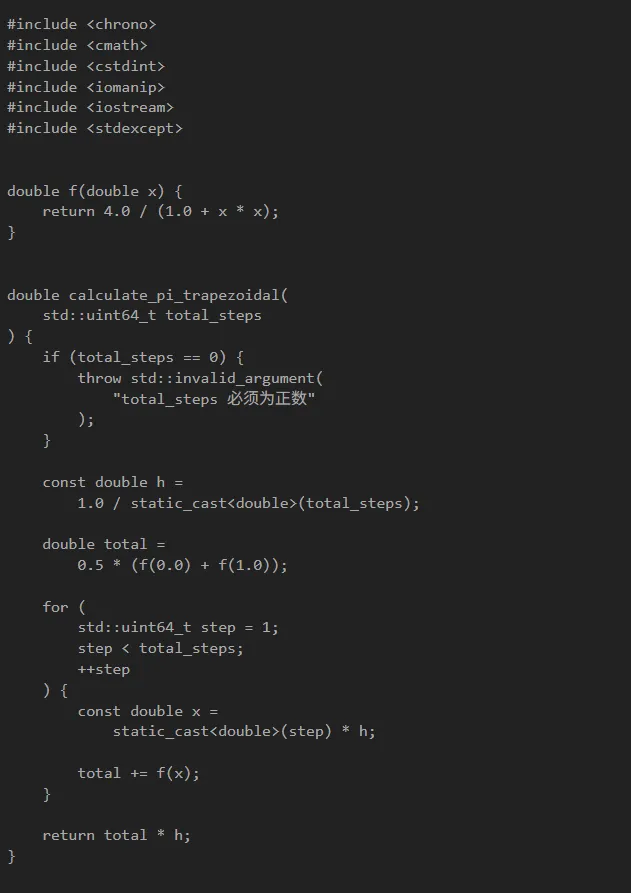
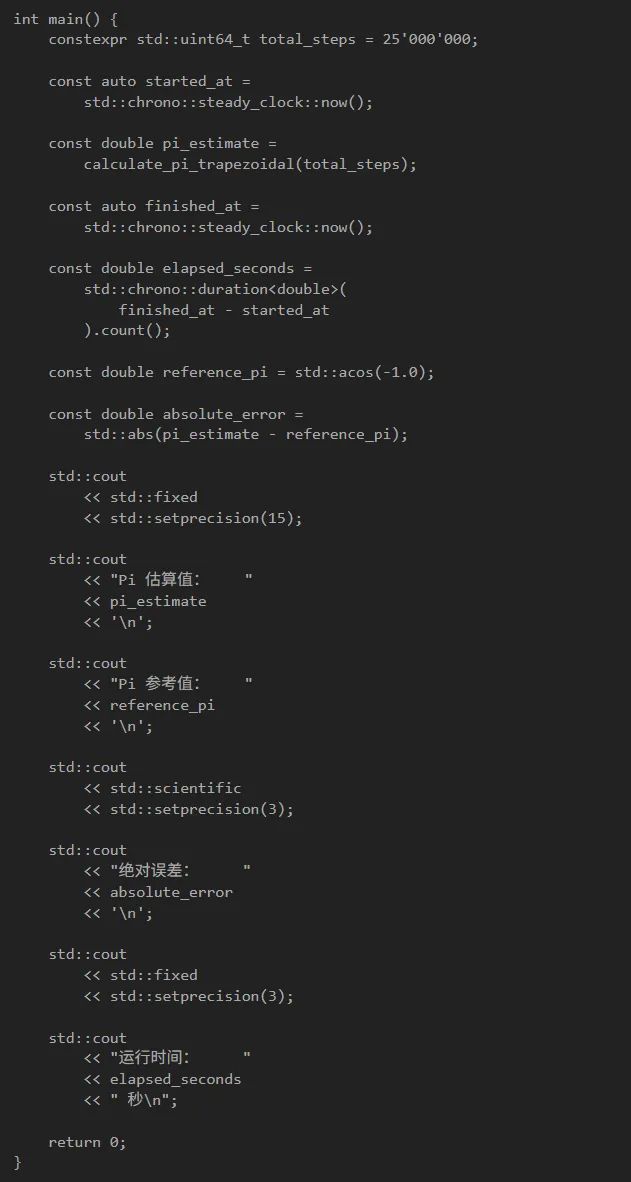
使用梯形法则的单线程 C++ 实现
下面的 C++ 程序实现了梯形法则:
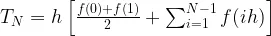
g++ -O3 -std=c++17 pi_trapezoidal.cpp -o pi_trapezoidal使用中点法则的多线程 C++ 实现
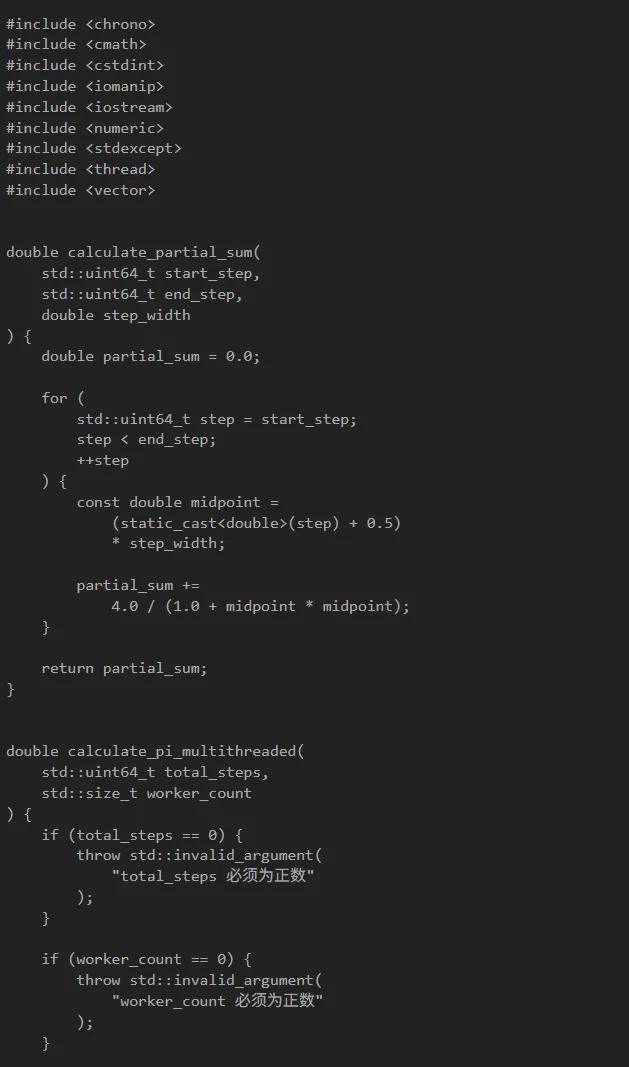
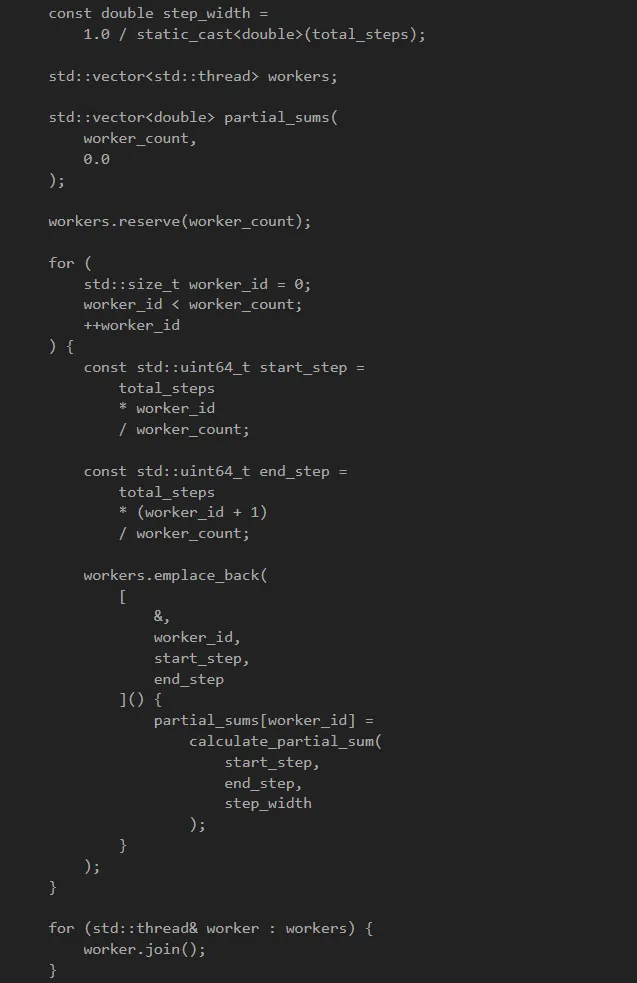
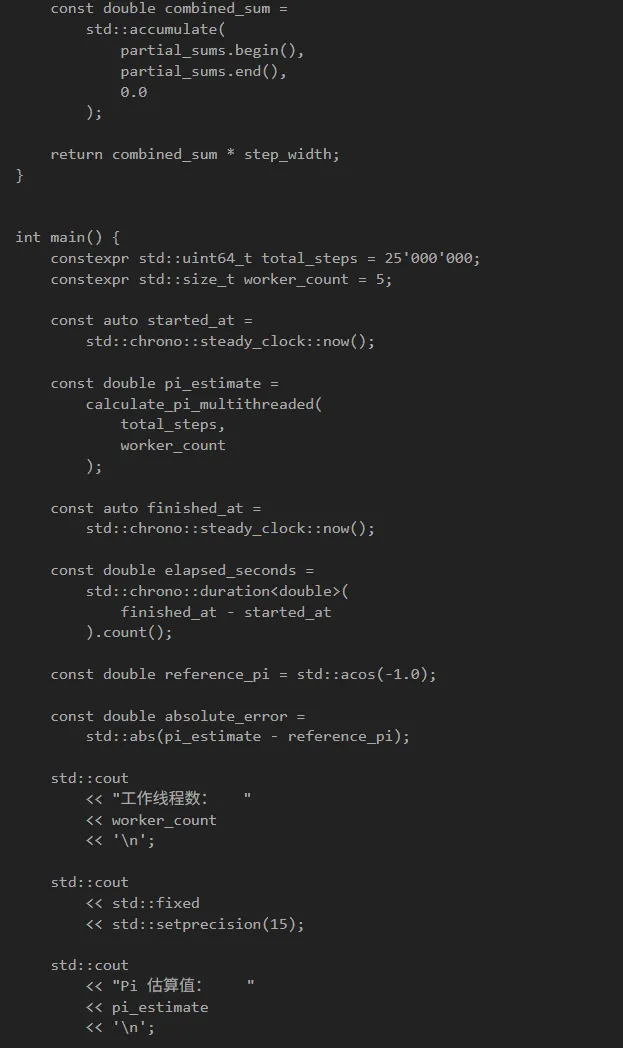
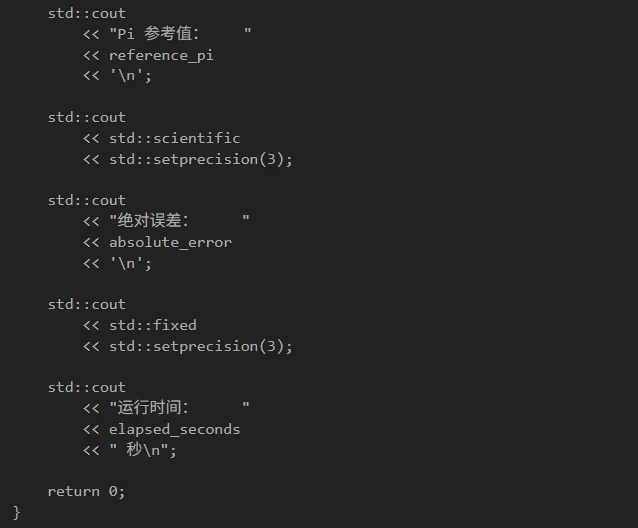
与普通 CPython 线程不同,C++ 线程可以在多个 CPU 核心上同时执行 CPU 密集型计算。
下面的实现将计算任务分配给五个线程。
使用线程支持和优化选项进行编译:
g++ -O3 -std=c++17 -pthread pi_multithreaded.cpp -o pi_multithreaded运行程序:
./pi_multithreaded为什么每个线程都使用自己的局部求和变量?
每个线程内部首先使用一个局部变量进行计算:
double partial_sum = 0.0;线程不会在每一次循环中都修改同一个共享的全局变量。
如果所有线程不断更新同一个共享变量,程序就需要使用互斥锁或者原子操作。
这会引入同步开销和线程竞争,可能抵消多线程带来的性能优势。
因此,程序采用了类似 MapReduce 的模式:
为每个工作线程分配一段积分区间。 让每个工作线程独立完成计算。 每个线程保存一个部分结果。 等待所有线程结束。 将所有部分结果相加。
在数学上:
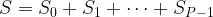
最终近似值为:

将算法扩展到五个分布式计算节点
多线程和分布式计算使用相同的数学划分方法,但它们是两种不同的执行模型。
线程通常具有以下特点:
运行在同一台机器上 共享相同的内存空间 属于同一个进程 通过共享变量进行通信
分布式工作进程通常具有以下特点:
作为独立进程运行 可能运行在不同的物理机器上 不共享普通的进程内存 通过文件、Socket、MPI、RPC 或其他分布式运行时进行通信
在一个五节点任务中,每个进程都会获得一个 Rank:
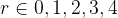
进程总数为:

每个 Rank 使用下面的公式计算自己的任务起始位置:
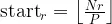
结束位置为:
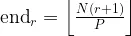
在 Python 中,可以这样分配计算范围:
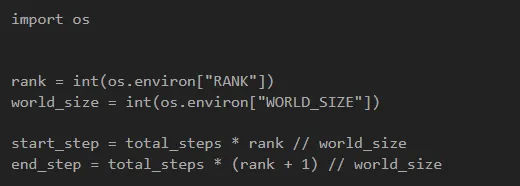
每个 Rank 只计算自己负责的区间:
对于五个 Rank,最终结果为:
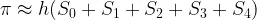
在前面的 Singularity 示例中,每个 Rank 都会写入一个结果文件:
rank-0.json rank-1.json rank-2.json rank-3.json rank-4.jsonRank 0 等待全部五个文件生成,然后读取每个文件中的部分和,将它们相加,最终得到 Pi 的估算值。
这个过程实现了三种分布式操作:
- 屏障同步(Barrier):
等待所有工作节点完成计算 - 收集(Gather):
收集所有节点的部分结果 - 归约(Reduce):
将所有部分和相加
基于文件的实现比较简单,也很容易理解,但它假设所有节点都可以访问同一个共享输出目录。
在正式的生产级分布式程序中,通常会使用 MPI 或其他支持集合通信的框架,以获得更加可靠和高效的通信机制。
数值积分方法的精度
对于足够平滑的函数,梯形法则和中点法则的误差通常都与下面的量成正比:

这意味着,当小区间数量加倍时,数值积分误差可能大约缩小为原来的四分之一。
不过,无限增大  并不意味着可以获得无限精度。
计算机使用有限精度的浮点数存储数据。当程序累加几百万甚至几十亿个数值时,舍入误差也可能逐渐累积。
并行版本和单线程版本在最后几位数字上也可能略有不同,因为浮点数加法并不严格满足结合律:
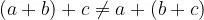
这些表达式在数学上是等价的,但是在有限精度浮点计算中,改变加法顺序可能会改变最终的舍入结果。
性能方面的注意事项
在以下条件下,多线程 C++ 实现通常会比单线程版本更快:
计算机拥有多个 CPU 核心 计算任务足够大 工作线程数量设置合理 启用了编译器优化
使用五个线程并不保证一定能够获得五倍性能提升。
程序性能还会受到以下因素影响:
CPU 核心数量 处理器运行频率 CPU 温度以及降频 操作系统的线程调度 CPU 缓存行为 线程创建和销毁开销 计算机上正在运行的其他任务
对于 Python,GIL 是主要限制。增加 Python 线程数量通常无法加速纯 Python 的 CPU 密集型循环。
对于分布式计算,节点分配、进程启动、共享存储访问以及结果合并也都会产生额外开销。
使用 2500 万个区间计算 Pi 是一个很好的教学示例,但在真实生产环境中,这个计算任务过于简单,不值得为此分配多个昂贵的 GPU 计算节点。
不同实现方式的比较
总结
下面这个恒等式:
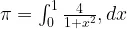
为我们提供了一个简单的例子,展示如何把微积分问题转换成计算机可以执行的数值计算问题。
梯形法则使用相邻边界点之间的直线近似曲线:
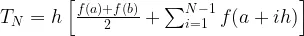
中点法则使用每个小区间的中心位置计算函数值:
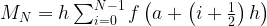
同一个数学计算可以通过多种方式执行:
在一个 CPU 核心上运行单个循环 在同一台机器上使用多个线程 使用多个进程和多个 CPU 核心 使用运行在不同计算节点上的分布式工作进程
无论使用哪一种执行模型,背后的数学算法基本不变。
真正发生变化的是:如何划分积分区间、在哪里计算部分和,以及如何将所有部分结果重新合并起来。
这也是很多并行算法背后的核心模式:
任务分割 —> 计算部分结果 —> 合并计算最终结果
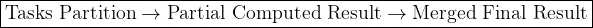
虽然计算 Pi 只是一个简单的示例,但同样的 MapReduce 思想广泛应用于科学模拟、机器学习、数据处理、图形渲染、金融建模和大规模分布式系统中。
同步到博客:
https://justyy.com/archives/72131
英文:
https://helloacm.com/calculating-pi-with-numerical-integration-in-python-and-c/
谢谢赏饭吃!
假期里的乐团时光: 孩子们参加 Holiday Orchestra 的一次经历
儿子的Perse Proms小交响乐团表演(大提琴): 加勒比海盗与舞王
微软剑桥研究院 2026 夏日派对: 三年后重回 Shepreth Wildlife Park
PayPal 也能像银行卡一样刷了: Debit Card 使用体验
在 Shepreth Wildlife Park 遇见长鼻浣熊: 微软剑桥研究院 Summer Party 小记 (2026)
教娃编程 vLog: Harness Engineering - 指挥 AI 干活
英国Tesco超市推出Plus订阅服务: 每月两次Big Shop
去剑桥Addenbrooke医院做了个除痣小手术-然后走了近两小时回家
花了288英镑修了我那佳能24-70mm红圈镜头/还能让这个镜头再战几年
通过了AI-900和DP-900两门微软认证考试! 新时代应该人手一个AI-900证书
微软研究院2025冬天派对/Winter Party (Boom Battle Bar)
数学之美: Sigma 函数的推导公式与 Python 实现
在英国搞了一个私人车牌: 求而不得的 X86, 意外收获的 X8 CPU
英国银行透支申请/Overdraft详解: 以HSBC为例的真实申请经历
Alpha Arena: AI 在真实市场的实盘对决与深度分析
第一次参加竞标英国私人车牌 X86 CPU, 太贵了/要不起
教孩子编程: 证明根号2是个无理数的两种方法(反证法/几何无限下降法)
废物利用, 找出2TB的WD硬盘外接硬盘盒挂到树莓派当网络硬盘(Raspberry Pi Network Drive)
微软剑桥研究院2025夏日花园派对 Summer Garden Party
借助AI快速开源了三个小工具: 写代码越来越像做产品了, AI 真把我宠坏了(Vibe Coding)
写了十几年代码, 谷歌/Google认为我还不够Senior
一万个比特币买披萨的男人: Laszlo Hanyecz 的传奇故事
2024年: 生活比工作忙, 又混/活了一年, 打工是挣不到钱的
简单的投资策略: 美元成本平均法: 定投大饼/比特币/BTC
三次冲击谷歌软件工程师: 我的面试起伏录 (谷歌面试是不是一生只有三次机会?)
低风险的投资回报: 火币HTX交易所的3/7天的鲨鱼鳍DeFi金融理财产品(SharkFin)
Microbit 游戏编程: 不会吃胖的贪食蛇 (自带人工智能)
个人扯蛋号: ACM-er
公众订阅号: JustYYUK 小赖子的英国生活和资讯
随机文章
-
 10个月宝宝每天需要喝多少奶粉?
- Linux Mint 版正式发布桌面环境全面升级向更稳定更易用
- 手滑 rm 了文件?别急,Linux 自带一个“后悔药”
- 那些我真希望有人早点告诉我的 Linux 内置工具
- 从零搭一台 Linux 虚拟机:VMware + Linux 入门教程
- Linux 文件查找:find、locate、which、whereis 用法对比
- Linux 7.2-rc4发布:8月稳定版进入倒计时
- Nexpose 8.52.0 for Linux & Windows - 漏洞扫描
- 同样是操作系统,为什么 Linux 能吊打 Windows?
- Linux WMI驱动将支持AArch64:Windows on ARM笔记本更近了
- Linux 7.3将支持更多华硕主板传感器:DIY监控再完善