做舆情分析、写行业周报,最头疼的就是找不到权威数据源。
澎湃新闻作为国内头部时政媒体,数据权威、更新快,但网页端无限滚动加载,根本没法一键复制。
今天不讲废话,只讲核心思路:
监听 search/web/news 接口,把澎湃全站搜索结果“搬”进 Excel。
核心逻辑
输入关键词 → 打开澎湃搜索页 → 监听接口 → 滚动加载 → 清洗 HTML → 写入 CSV。
全程无 Selenium,无 JS 逆向,适合新手。
关键代码
1. 监听接口(核心)
dp.listen.start('search/web/news')dp.get(f'https://www.thepaper.cn/searchResult?id={keyword}')
👉 澎湃的搜索结果是Ajax 动态加载,直接监听接口比解析 DOM 稳得多。
2. 滚动触发加载
dp.scroll.to_bottom()resp = dp.listen.wait(timeout=8)
👉 澎湃用的是无限滚动,滚到底才会触发下一次请求。
3. 清洗 HTML(很重要)
澎湃返回的标题和摘要里自带 HTML 标签
def clean_html(text): return re.sub(r'<.*?>', '', text or '')
👉 不清洗,CSV 里全是 <em>、<span>,没法看。
4. 标签拼接
tags = ' '.join(tag.get('tag','') for tag in item.get('tagList',[]))
👉 把数组变成字符串,方便后续做词频统计。
你能拿到什么数据?
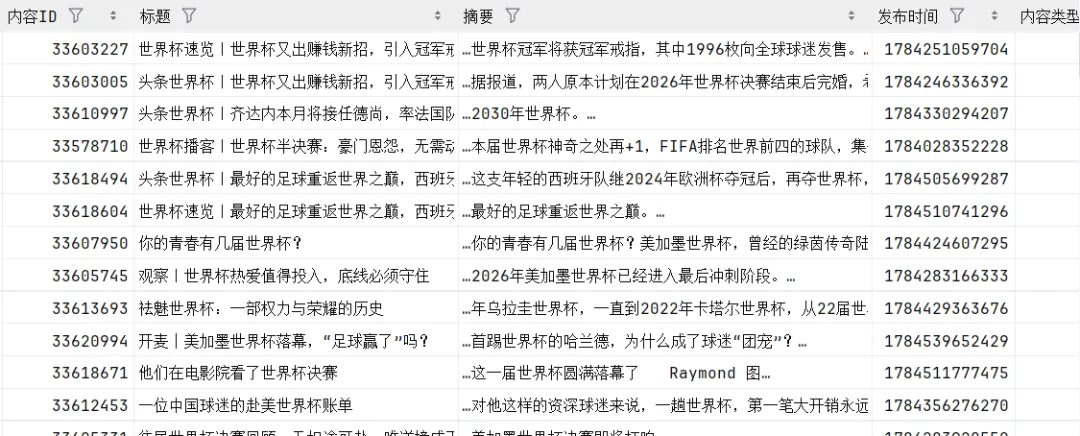
除了常规的标题、摘要、发布时间,你还能拿到:
点赞数 / 互动数:判断文章热度
栏目名称:看内容归属(时政、财经、文化…)
标签集合:做舆情关键词分析
音视频地址:不只是图文,连直播、音频都能抓
是否置顶 / 关评:判断媒体态度
这些数据,拿来画舆情走势图、做热点事件复盘,非常合适。
为什么这个方法稳?
接口稳定:search/web/news 是官方搜索接口,字段长期稳定。
不怕前端改版:只要接口不改,网页怎么换皮都不影响。
数据全:图文、视频、音频、直播,一网打尽。
常见坑位提醒(省你1小时)
❗ 搜索结果为 0:澎湃搜索页 URL 是 id= 而不是 q=,直接拼中文会失效,建议先用浏览器手动搜一次,复制 URL 中的参数。
❗ 滚动无效:澎湃有时需要多次 scroll.to_bottom() 才能触发接口。
❗ 字段缺失:部分老文章没有 nodeInfo 或 tagList,一定要用 .get(),否则直接报错。
延展玩法
舆情日报:定时跑脚本,每天拉一次关键词数据,自动生成热点榜单。
事件复盘:比如“某地暴雨”“某政策出台”,拉一周数据,看传播趋势。
媒体对比:同一事件,对比澎湃、新华网、财新的报道角度。
💡 划重点
爬虫不是拼代码长度,而是拼谁能更快找到接口、更稳地清洗数据。
这一篇,本质上是教你如何爬“搜索结果页”——这个思路,换到知乎、微博、B站,几乎通用。
完整代码及字段说明已整理,关注后回复“澎湃新闻”获取。
(注:仅供学习交流,请勿高频请求,遵守澎湃新闻 Robots 协议)