Python开发从零开始-49.11-数据库操作
- 2026-10-11 05:37:36
接上文Python开发从零开始-49.10-数据库操作,本文小编与大家分享 Python 数据库操作的相关知识。
(20)数据排序
ORDER BY 子句可以用来基于一个或多个字段按升序或降序顺序排列数据。ORDER BY 子句的基本语法如下:
SELECT column-list FROM table_name [WHERE condition] [ORDER BY column1[ASC| DESC] [, column2[ASC| DESC] ,,, columnN[ASC| DESC]]; 语法解释:
|
ORDER BY 子句的使用实例演示如下:
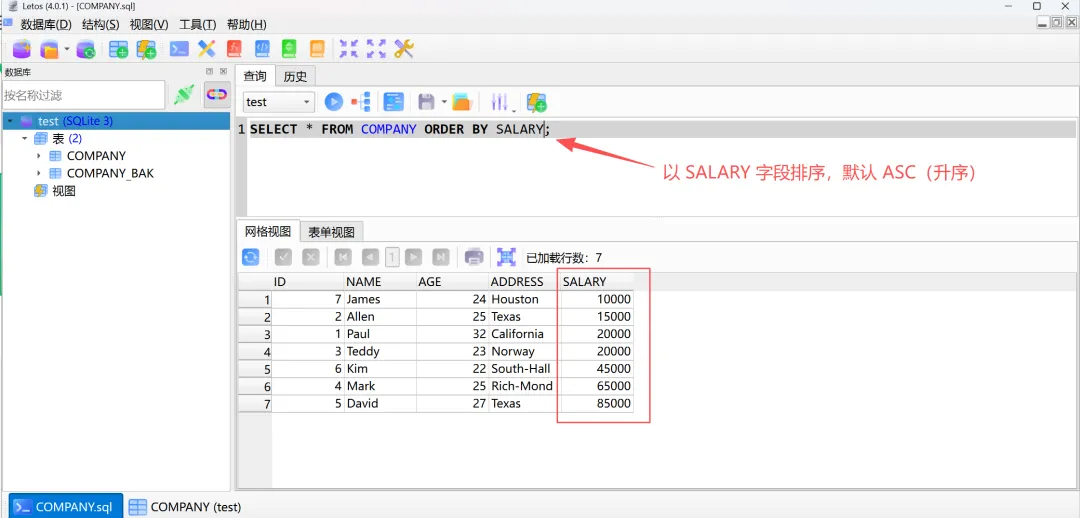
1)查询 COMPANY 表,结果以 SALARY 升序排序,可不显式使用 ASC(升序),因为默认为 ASC。
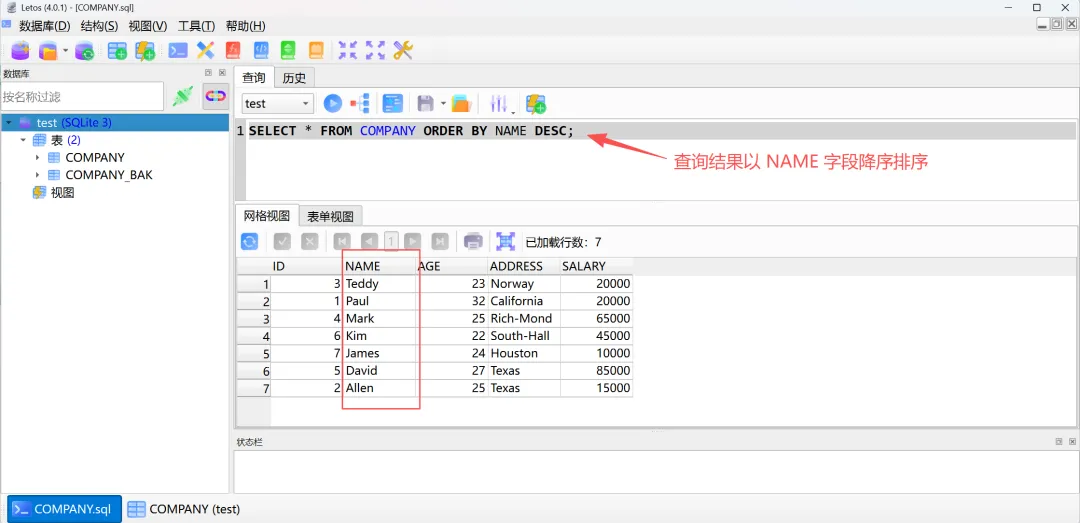
2)查询 COMPANY 表,结果以 NAME 降序排序。
3)查询 COMPANY 表,结果以 NAME 和 SALARY 升序排序。
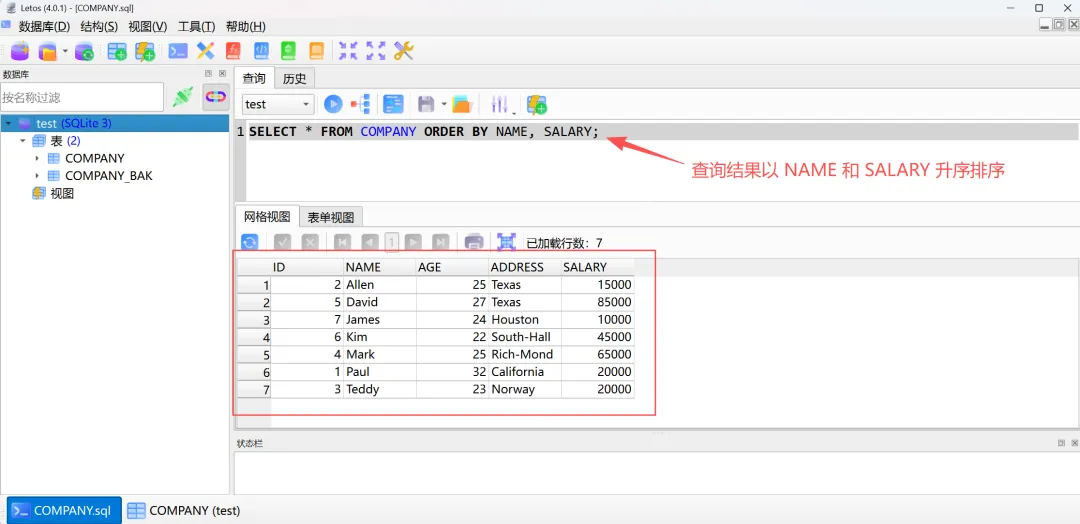
当使用多个字段进行排序时,SQLite 首先按照第一个指定的字段进行排序。如果第一个字段的值相同,那么它会根据第二个字段进行排序,以此类推。 |
(21)数据分组
GROUP BY 子句与 SELECT 语句一起使用,用于对相同的数据进行分组。在 SELECT 语句中,GROUP BY 子句放在 WHERE 子句之后,放在 ORDER BY 子句之前。GROUP BY 子句的基本语法如下:
SELECT column-list FROM table_name [WHERE conditions] GROUP BY column1[, column2,,, columnN] [ORDER BYstatements] 语法解释:
|
GROUP BY 子句使用实例演示如下:
1)查询 COMPANY 表,结果以 SALARY 分组。
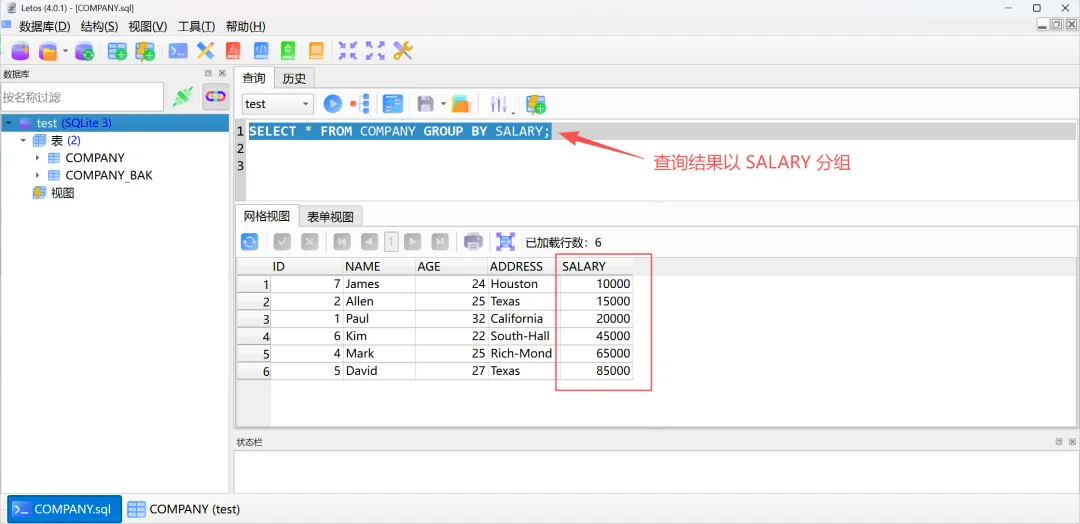
SALARY 字段中有一个重复值 20000,所以返回的查询结果只有 6 条。
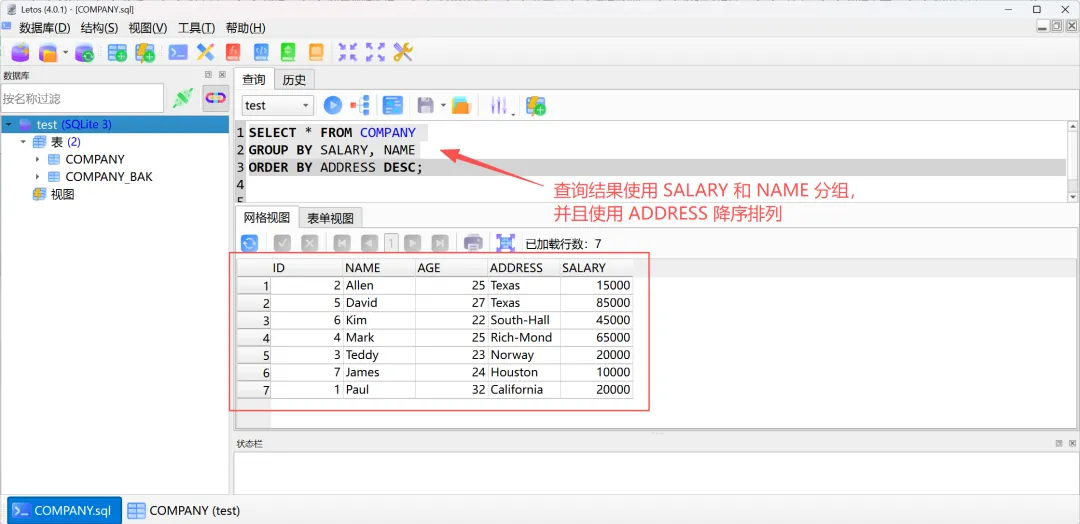
2)查询 COMPANY 表,结果以 SALARY 和 NAME 分组,并按照 ADDRESS 字段降序排列。
【小编提示】 GROUP BY 语句通常与聚合函数(如COUNT()、SUM()、AVG()、 MAX()、MIN()等)一起使用,以便对每个分组执行计算。关于聚合函数后续章节会进行介绍。 |
(22)分组结果过滤
HAVING 子句用于在分组后对结果进行过滤。它与 WHERE 子句的区别在于:WHERE 子句用于过滤行(分组前),HAVING 子句用于过滤组(分组后)。HAVING 子句通常与聚合函数一起使用。
HAVING 子句必须放在 GROUP BY 子句之后,ORDER BY 子句之前,其在 SELECT 语句中基本语法如下:
SELECT column-list FROM table_name [WHERE conditions] GROUP BY column1[, column2,,, columnN] HAVING conditions [ORDER BY statements] 语法解释:
|
HAVING 子句使用实例演示如下:
1)为方便演示,先向 COMPANY 表插入几条重复数据。
INSERT INTO COMPANY VALUES (8, 'Paul', 24, 'Houston', 20000.00 );INSERT INTO COMPANY VALUES (9, 'James', 44, 'Norway', 5000.00 );INSERT INTO COMPANY VALUES (10, 'James', 45, 'Texas', 5000.00 );
此时 COMPANY 表记录如下
ID NAME AGE ADDRESS SALARY---------- ---------- ---------- ---------- ----------1 Paul 32 California 20000.02 Allen 25 Texas 15000.03 Teddy 23 Norway 20000.04 Mark 25 Rich-Mond 65000.05 David 27 Texas 85000.06 Kim 22 South-Hall 45000.07 James 24 Houston 10000.08 Paul 24 Houston 20000.09 James 44 Norway 5000.010 James 45 Texas 5000.0
2)查询 COMPANY 表,对 NAME 分组,筛选同名计数小于 2 的记录。COUNT() 函数用于计算行数,语法为 COUNT(column_name) 或 COUNT(*)。
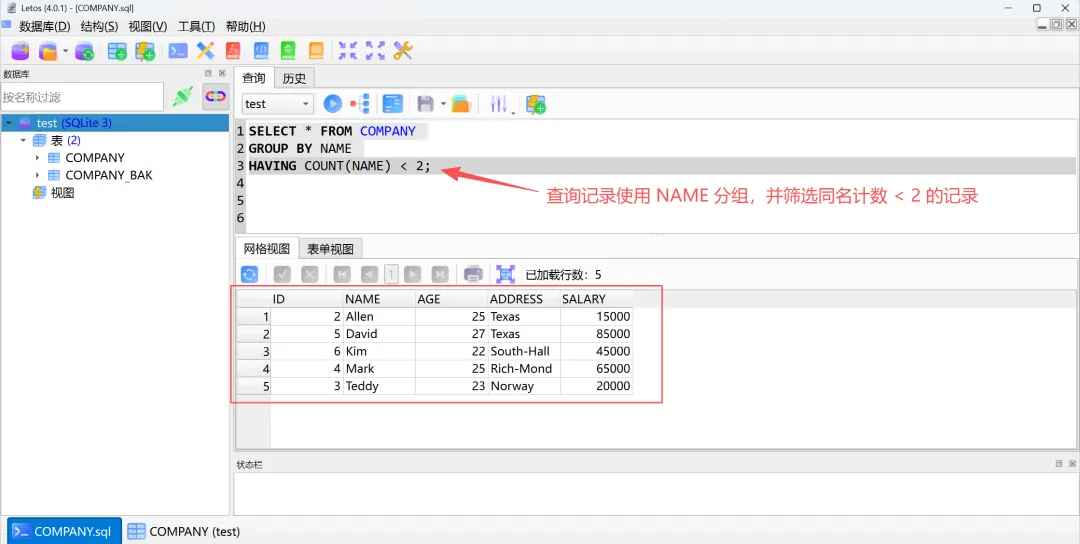
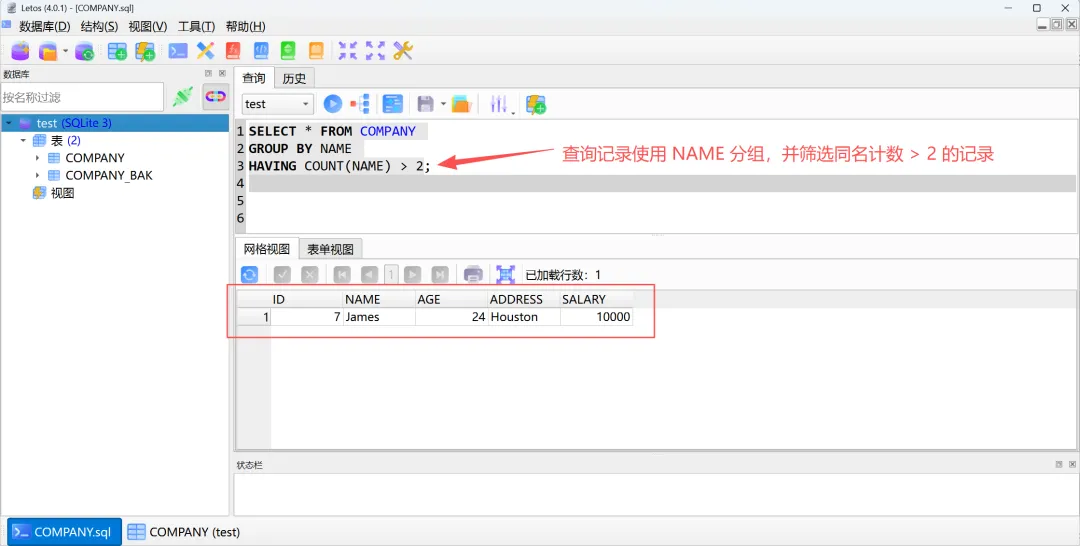
3)查询 COMPANY 表,对 NAME 分组,筛选同名计数大于 2 的记录。
(23)清除重复记录
DISTINCT 关键字与 SELECT 语句一起使用,来消除所有重复的记录,并只获取唯一一次记录。
DISTINCT 关键字的基本语法
SELECT DISTINCT column-list FROM table_name
|
DISTINCT 关键字使用示例如下:
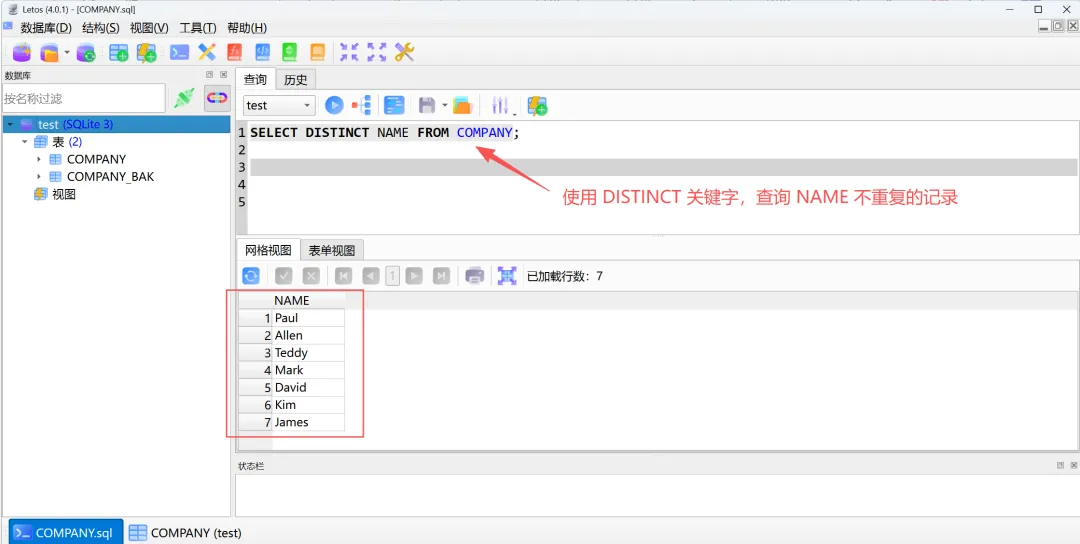
使用已有重复记录的 COMPANY 表,查询 NAME 的值不重复的记录。
受文章篇幅所限,下文将继续介绍 Python 数据库操作的相关知识。
