别再只画两根柱子:用 Python 看清每个对象的前后变化
- 2026-10-11 06:16:45
同一批对象在干预前后各测一次,是业务分析和科研中很常见的数据结构。最省事的做法,是把两个均值画成柱状图;但这样会把最重要的信息藏起来:究竟有多少对象改善、谁在下降、变化幅度是否一致?
今天用一组模拟的门店服务评分,完整演示两种配对变化图:斜率图负责保留每条个体轨迹,排序哑铃图负责突出变化方向与异质性。所有数据、统计量和图片均由下方代码实际生成。
解决的问题
假设 36 家门店在流程优化前后各接受一次服务评分。我们希望回答:
整体平均得分提高了多少? 平均变化的不确定性有多大? 有多少门店改善,又有多少门店下降? 不同区域以及不同门店的变化是否一致?
这是典型的配对数据。每家门店的“前”和“后”属于同一个观察单位,两次得分不能拆开当作独立样本。
方法原理
对第 (i) 家门店,先定义配对差值:
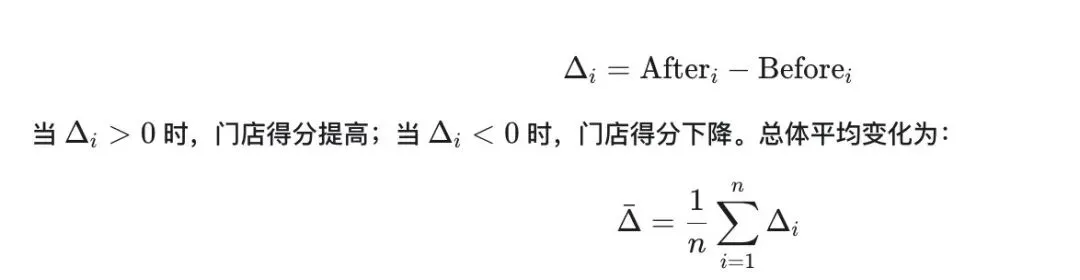
为了给平均变化提供区间估计,本文使用成对 Bootstrap:每次抽样都抽取完整门店记录,保留同一门店的前后测量,再计算平均差值。绝不能分别重抽“前”和“后”,否则配对关系会被破坏。
两张图承担不同任务:
斜率图把每家门店的前后得分连接起来,适合快速观察整体方向和个体轨迹。 排序哑铃图按差值排列对象,用线段长度呈现变化幅度,用线段方向呈现改善或下降。
数据与实现思路
本例使用可复现的模拟数据,而不是现实业务数据。36 家门店均分为 East、Central 和 West 三个区域;模拟时让区域拥有不同的平均变化,同时保留门店层面的随机波动。
实现分为四步:
Python完整实战
1. 生成配对数据
import randomimport osfrom pathlib import Path# 将Matplotlib缓存放到当前环境可写目录os.environ[”MPLCONFIGDIR”] = ”/tmp/matplotlib-wechat-python”Path(os.environ[”MPLCONFIGDIR”]).mkdir(parents=True, exist_ok=True)import matplotlibmatplotlib.use(”Agg”)import matplotlib.pyplot as pltfrom matplotlib.lines import Line2Dimport numpy as npimport pandas as pd# 同时固定Python与NumPy随机种子random.seed(20260725)np.random.seed(20260725)rng = np.random.default_rng(20260725)# 构造36家门店的配对测量数据regions = np.repeat([”East”, ”Central”, ”West”], 12)baseline_effect = pd.Series(regions).map({”East”: 2.0, ”Central”: 0.0, ”West”: -1.5}).to_numpy()change_effect = pd.Series(regions).map({”East”: 2.5, ”Central”: 4.5, ”West”: 6.0}).to_numpy()# 前后得分共享同一门店标识,不能当作独立样本before = np.clip(rng.normal(68 + baseline_effect, 5.5, 36),45,90,)change = rng.normal(change_effect, 3.8, 36)after = np.clip(before + change, 45, 98)paired = pd.DataFrame({”store”: [f”S{i:02d}” for i in range(1, 37)],”region”: regions,”before”: before,”after”: after,})paired[”change”] = paired[”after”] - paired[”before”]# 先检查样本规模和变化方向overview = pd.DataFrame({”stores”: [len(paired)],”mean_before”: [paired[”before”].mean()],”mean_after”: [paired[”after”].mean()],”mean_change”: [paired[”change”].mean()],”improved”: [(paired[”change”] > 0).sum()],”declined”: [(paired[”change”] < 0).sum()],})print(overview.round(3).to_string(index=False))print(paired.head(2).round(2).to_string(index=False))
输出:
stores mean_before mean_after mean_change improved declined36 66.874 71.26 4.386 29 7store region before after changeS01 East 63.85 61.77 -2.08S02 East 69.14 75.27 6.13
36 家门店中有 29 家提高、7 家下降。总体均值从 66.874 上升到 71.260,但仅凭两个均值还看不到门店之间的差异。
2. 估计平均变化及其区间
# 对门店整行重抽样,保留前后测量的配对关系bootstrap_rng = np.random.default_rng(20260726)bootstrap_index = bootstrap_rng.integers(0,len(paired),size=(10000, len(paired)),)bootstrap_changes = paired[”change”].to_numpy()[bootstrap_index]bootstrap_means = bootstrap_changes.mean(axis=1)# 用百分位数法得到平均变化的95%区间ci_low, ci_high = np.quantile(bootstrap_means,[0.025, 0.975],)change_summary = pd.DataFrame({”mean_change”: [paired[”change”].mean()],”median_change”: [paired[”change”].median()],”bootstrap_ci_low”: [ci_low],”bootstrap_ci_high”: [ci_high],})print(change_summary.round(3).to_string(index=False))# 分区汇总只用于描述异质性,不解释为因果差异region_summary = (paired.groupby(”region”, sort=False).agg(stores=(”store”, ”size”),mean_before=(”before”, ”mean”),mean_after=(”after”, ”mean”),mean_change=(”change”, ”mean”),).reset_index())print(region_summary.round(3).to_string(index=False))
输出:
mean_change median_change bootstrap_ci_low bootstrap_ci_high4.386 4.889 2.908 5.847region stores mean_before mean_after mean_changeEast 12 67.179 69.442 2.263Central 12 67.950 70.724 2.774West 12 65.492 73.613 8.121
平均变化为 4.386 分,成对 Bootstrap 95% 区间为 2.908~5.847 分。模拟数据中 West 区域的平均增幅最大,但区域结果只是描述性发现,不能据此作因果解释。
3. 用斜率图保留每条个体轨迹
# 为每家门店画一条配对连线fig, ax = plt.subplots(figsize=(7.2, 6.0))for row in paired.itertuples():line_color = ”#2A9D8F” if row.change >= 0 else ”#D95F59”ax.plot([0, 1],[row.before, row.after],color=line_color,alpha=0.42,linewidth=1.3,)ax.scatter([0, 1],[row.before, row.after],color=line_color,alpha=0.72,s=20,)# 用粗线突出整体均值,但保留个体轨迹overall_means = [paired[”before”].mean(),paired[”after”].mean(),]ax.plot([0, 1],overall_means,color=”#1F2937”,marker=”o”,markersize=8,linewidth=3.2,label=”Overall mean”,)# 完成英文标注并保存第一张图ax.set(xticks=[0, 1],xticklabels=[”Before”, ”After”],ylabel=”Service score”,title=”Paired Change Across 36 Stores”,)ax.grid(axis=”y”, alpha=0.22)ax.spines[[”top”, ”right”]].set_visible(False)slope_legend = [Line2D([0], [0], color=”#2A9D8F”,linewidth=2, label=”Improved store”,),Line2D([0], [0], color=”#D95F59”,linewidth=2, label=”Declined store”,),Line2D([0], [0], color=”#1F2937”,marker=”o”, linewidth=3,markersize=7, label=”Overall mean”,),]ax.legend(handles=slope_legend,frameon=False,loc=”upper left”,)fig.tight_layout()fig.savefig(”/tmp/python_paired_slope.png”,dpi=180,bbox_inches=”tight”,)plt.close(fig)# 同时输出均值线位置与文件大小mean_line_check = pd.DataFrame({”mean_before”: [overall_means[0]],”mean_after”: [overall_means[1]],})print(mean_line_check.round(3).to_string(index=False))print(pd.DataFrame({”file”: [”python_paired_slope.png”],”bytes”: [Path(”/tmp/python_paired_slope.png”).stat().st_size],}).to_string(index=False))
输出:
mean_before mean_after66.874 71.26file bytespython_paired_slope.png 220123
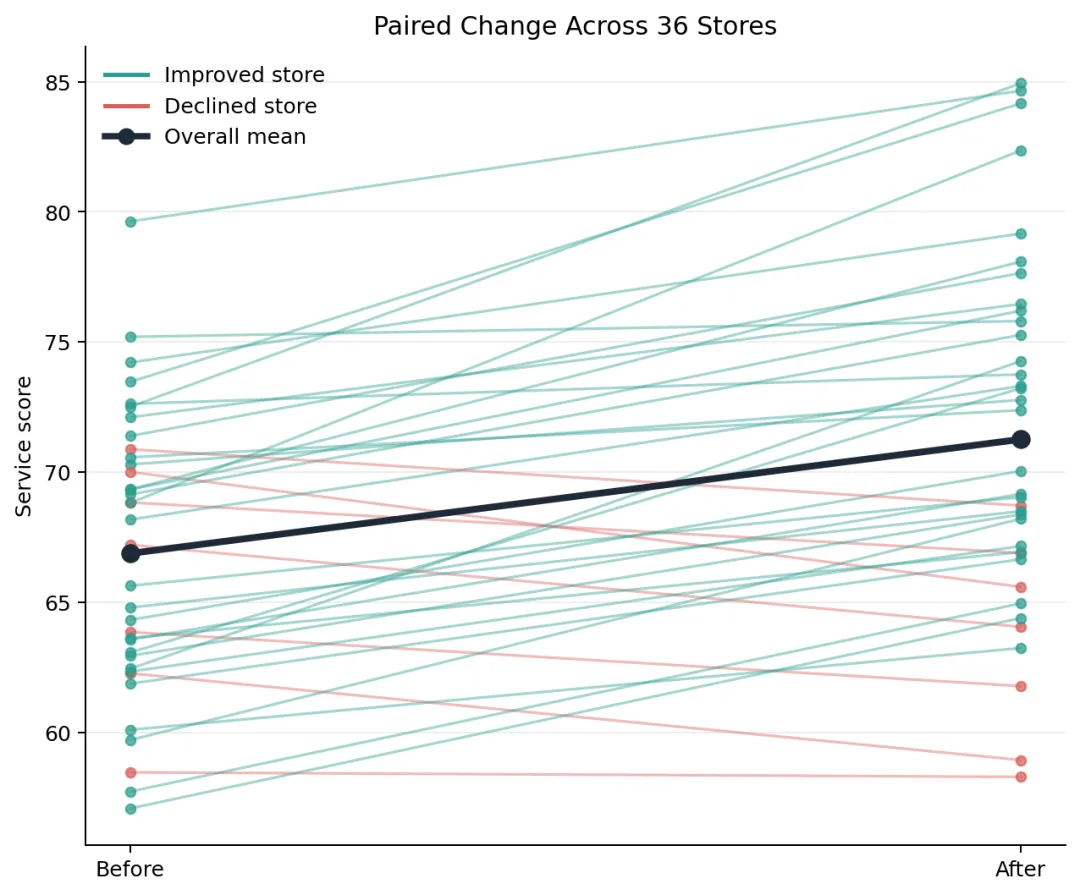
绿色轨迹表示得分提高,红色轨迹表示得分下降,深色粗线是总体均值。图中多数线条向上,但少数向下的门店没有被总体均值掩盖,这正是配对图相较于两根柱子的优势。
4. 用排序哑铃图突出变化幅度
# 按变化值排序,让改善与下降幅度可以逐行比较ordered = paired.sort_values(”change”).reset_index(drop=True)y_position = np.arange(len(ordered))line_colors = np.where(ordered[”change”] >= 0,”#2A9D8F”,”#D95F59”,)# 横线连接同一门店的前后得分,端点颜色区分时点fig, ax = plt.subplots(figsize=(8.2, 9.0))ax.hlines(y=y_position,xmin=ordered[”before”],xmax=ordered[”after”],color=line_colors,linewidth=2.0,alpha=0.78,)ax.scatter(ordered[”before”],y_position,color=”#4575B4”,s=32,zorder=3,)ax.scatter(ordered[”after”],y_position,color=”#F4A261”,s=32,zorder=3,)# 添加门店标签、图例和整体均值参考线ax.set_yticks(y_position)ax.set_yticklabels(ordered[”store”] + ” · ” + ordered[”region”],fontsize=7.5,)ax.axvline(paired[”before”].mean(),color=”#4575B4”,linestyle=”:”,linewidth=1.2,alpha=0.8,)ax.axvline(paired[”after”].mean(),color=”#F4A261”,linestyle=”:”,linewidth=1.2,alpha=0.8,)legend_items = [Line2D([0], [0], marker=”o”, color=”none”,markerfacecolor=”#4575B4”, markeredgecolor=”none”,markersize=7, label=”Before”,),Line2D([0], [0], marker=”o”, color=”none”,markerfacecolor=”#F4A261”, markeredgecolor=”none”,markersize=7, label=”After”,),]# 保存按变化排序的哑铃图ax.set(xlabel=”Service score”,ylabel=”Store and region”,title=”Sorted Store-Level Dumbbell Plot”,)ax.grid(axis=”x”, alpha=0.22)ax.spines[[”top”, ”right”, ”left”]].set_visible(False)ax.legend(handles=legend_items, frameon=False, loc=”lower right”)fig.tight_layout()fig.savefig(”/tmp/python_paired_dumbbell.png”,dpi=180,bbox_inches=”tight”,)plt.close(fig)# 输出变化最小和最大的门店,并检查图像文件extremes = pd.concat([ordered.head(2),ordered.tail(2),])[[”store”, ”region”, ”before”, ”after”, ”change”]]print(extremes.round(2).to_string(index=False))print(pd.DataFrame({”file”: [”python_paired_dumbbell.png”],”bytes”: [Path(”/tmp/python_paired_dumbbell.png”).stat().st_size],}).to_string(index=False))
输出:
store region before after changeS14 Central 70.00 65.58 -4.42S04 East 62.26 58.93 -3.34S36 West 72.51 84.95 12.44S27 West 68.82 82.36 13.55file bytespython_paired_dumbbell.png 144369
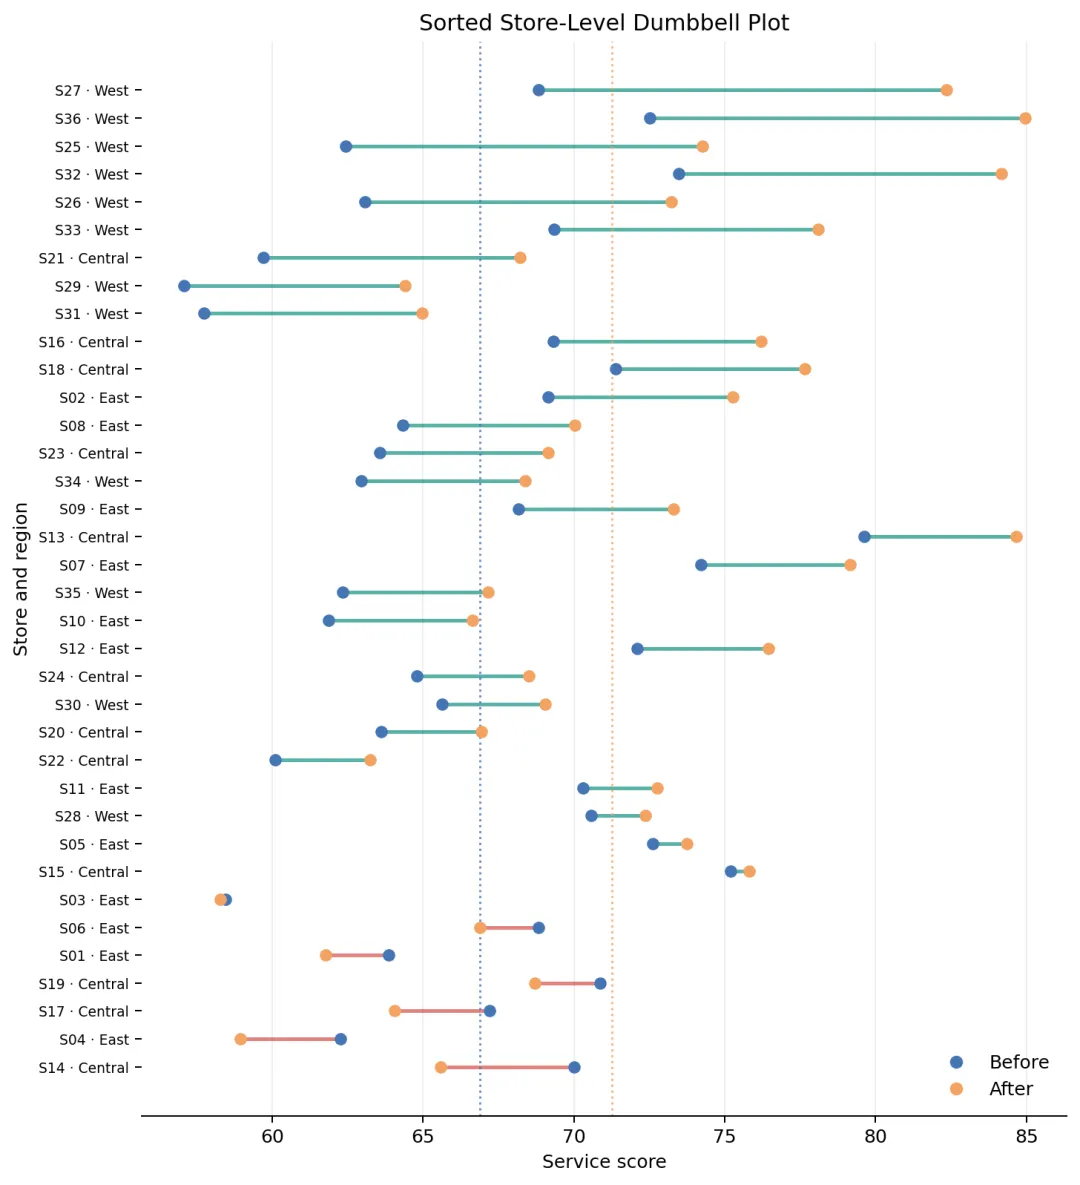
蓝色端点是优化前,橙色端点是优化后;绿色连线表示提高,红色连线表示下降。排序后,S14 和 S04 的下降以及 S36、S27 的大幅提高都非常醒目。
结果解释
这组模拟数据传递了三个重要信息。
第一,整体方向明确。平均得分提高 4.386 分,Bootstrap 区间未跨过 0;29 家门店提高,说明上升并非只由一两家极端门店推动。
第二,平均值不能代替个体轨迹。仍有 7 家门店下降,斜率图把这些反向变化直接保留下来。若只展示前后均值,管理者可能错过需要进一步排查的对象。
第三,变化具有异质性。门店级差值从负值延伸到两位数正值,区域均值也不相同。哑铃图适合定位具体对象,但当对象数量很多时会变得拥挤,此时可先按业务分组筛选,或改用差值分布图。
需要强调:数据是为教学而模拟,区域差异由生成机制设定。这里展示的是分析与可视化逻辑,不是对真实门店或某项干预效果的证据。
结论
分析前后测量时,不要急着画两根独立柱子。先保留对象标识,计算配对差值,再根据表达目标选图:
想看每条轨迹和总体方向,用斜率图。 想比较对象的变化方向与幅度,用排序哑铃图。 想估计总体平均变化的不确定性,用保留配对关系的 Bootstrap。
这套方法同样适用于患者治疗前后指标、学生培训前后成绩、产品改版前后用户评分,以及任何“一人两次”或“一对象两时点”的数据。