从 3 个 PKL 文件里抓出 6 个隐藏错误,拼出 18 万行训练表
做 AI 药物研发,很多人一上来就想训练 Random Forest、XGBoost,甚至直接谈大模型。
但真实的数据分析往往没那么浪漫。
模型还没见到,数据表里已经埋好了六颗雷:
NaN
False
-inf
MUT_ERROR
category dtype
以及一个看起来正常、实际会把行数合错的 merge key
这次练习的任务很明确:
输入:3 个 PKL 文件
输出:merged2

最终尺寸:
182,853 rows × 23,542 columns

其中 Random Forest 输入特征:
23,538 columns
原始练习要求先理解三张表的结构,再完成两次 merge,Random Forest 训练暂时不做。
一、先别急着 merge,先看清三张表
我们有三个数据集。
1. Response data
194,750 行 × 3 列
三列分别是:
cellLine
drug
IC50(LN)
一行代表:
某个药物作用于某个细胞系时,对应的 IC50。
2. Drug data
217 行 × 2,326 列
其中:
1 列 Drug name
2,325 列药物分子描述符
这些 descriptor 可以理解为机器学习眼中的“分子体检报告”,包括不同维度的物理化学和拓扑特征。
3. Mutation data
21,213 行 × 1,002 列
当前结构是:
行:mutation
列:cell line
值:0 或 1
问题也在这里。
Response 表是一行一个 cellLine,但 Mutation 表却是一列一个 cellLine。
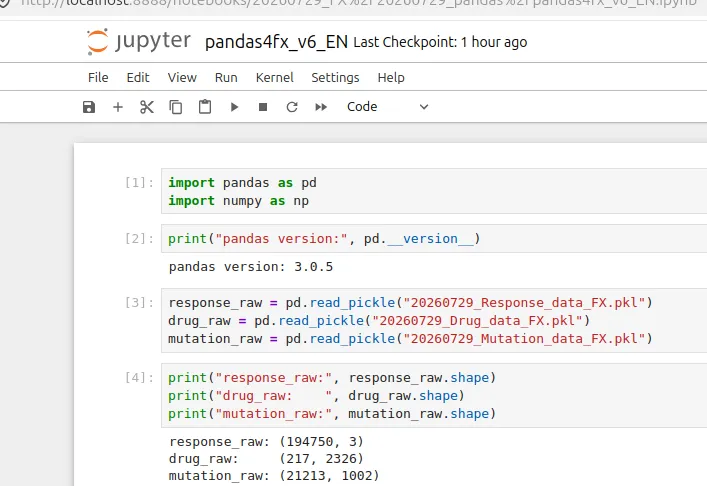
所以它不能直接 merge,必须先转置。三张原始表的实际尺寸和最终目标都在配套 Notebook 中进行了明确检查。
二、第一原则:不要相信“成功读取”的数据
import pandas as pd
import numpy as np

response = pd.read_pickle("20260729_Response_data_FX.pkl")
drug = pd.read_pickle("20260729_Drug_data_FX.pkl")
mutation = pd.read_pickle("20260729_Mutation_data_FX.pkl")
程序没有报错,不等于数据没有错误。
先检查尺寸:
print("response:", response.shape)
print("drug:    ", drug.shape)
print("mutation:", mutation.shape)
再看一小部分:
display(response.head())
display(drug.iloc[:5, :8])
display(mutation.iloc[:5, :8])
为什么不用直接输入:
drug
因为它有 2,326 列。
Jupyter 会努力展示,你的浏览器会努力活着。
三、Error 1:IC50 中藏了一个 NaN
先检查真正的缺失值:
missing_ic50 = response["IC50(LN)"].isna()

response.loc[missing_ic50]
发现一行:
cellLine: KMS-12-BM
drug: AS601245
IC50(LN): NaN
最简单的考试处理方法是用中央值填补:
ic50_numeric = pd.to_numeric(
    response["IC50(LN)"],
    errors="coerce"
)

ic50_median = ic50_numeric.median()

response.loc[
    missing_ic50,
"IC50(LN)"
] = ic50_median
这里每行代码都值得理解。
pd.to_numeric(...)
尝试把所有值转换为数字。
errors="coerce"
表示:
遇到无法转换成数字的内容,不要报错,把它改成 NaN。
median()
计算有效 IC50 数值的中位数。
四、Error 2:IC50 里还有一个假装成数据的 "False"
如果只检查:
response["IC50(LN)"].isna()
你只能发现真正的 NaN。
但字符串 "False" 并不是缺失值,它只是不能用于回归。
解决办法是先尝试数字转换:
ic50_numeric = pd.to_numeric(
    response["IC50(LN)"],
    errors="coerce"
)
然后找出:
text_ic50 = (
    ic50_numeric.isna()
    & response["IC50(LN)"].notna()
)

response.loc[text_ic50]
这样就找到了:
cellLine: LB1047-RCC
drug: GSK1070916
IC50(LN): "False"
修复:
response.loc[
    text_ic50,
"IC50(LN)"
] = ic50_median

response["IC50(LN)"] = pd.to_numeric(
    response["IC50(LN)"]
)
最后检查:
print(response["IC50(LN)"].isna().sum())
print(response["IC50(LN)"].dtype)
期待结果:
0
float64
这两个 IC50 错误,一个是真正的缺失值,一个是隐藏在数值列里的字符串。
五、中位数填补,到底是救命还是造数据?
这一步需要单独谈一下。
中位数的优点
第一,不删除行。
如果直接删除 IC50 错误行,样本会减少。删除某个药物 descriptor 行时,甚至会连带失去数百或数千条药物响应记录。
第二,不容易被极端值带跑。
例如:
1, 2, 3, 4, 100
平均值是:
22
中位数是:
3
对于偏态数据,中位数通常比平均值更稳。
第三,简单、快速、容易考试。
一行代码就能解决:
df["x"] = df["x"].fillna(df["x"].median())
中位数的缺点
问题也很直接:
中位数不是实验测出来的,是我们填进去的。
它会带来几个后果:
- 可能破坏不同 descriptor 之间的化学关系
更重要的是,正式训练模型时不能先对全部数据计算中位数,再划分 train 和 test。
正确顺序是:
先划分 train/test
只用 train 计算中位数
用 train 的中位数处理 train 和 test
否则测试集的信息会提前泄漏到训练流程里。
这次考试使用中位数,是为了修复错误并保留原始行数,从而得到规定的最终 shape。真实研究中,优先选择应当是回到原始数据库或计算流程,找回正确数值。配套 Notebook 也明确区分了这一点。
六、Error 3:Drug descriptor 中有一个 NaN
先统计每列缺失值:
drug_missing_count = drug.isna().sum()

drug_missing_count[
    drug_missing_count > 0
]
结果:
SpAbs_Dze 1
找出是哪一个药物:
drug.loc[
    drug["SpAbs_Dze"].isna(),
    ["Drug name", "SpAbs_Dze"]
]
发现:
NSC-87877
SpAbs_Dze = NaN
修复:
spabs_median = drug["SpAbs_Dze"].median()

drug["SpAbs_Dze"] = drug["SpAbs_Dze"].fillna(
    spabs_median
)
注意,这里填的是 SpAbs_Dze 自己这一列的中位数,不是随便从整个 DataFrame 里找一个数字。
七、Error 4:isna() 看不到的 -inf
另一个 descriptor 错误是:
T0901317
GATS3v = -inf
-inf 不是 NaN。
所以:
drug["GATS3v"].isna()
抓不到它。
必须使用:
np.isinf()
检查:
infinite_gats3v = np.isinf(
    drug["GATS3v"]
)

drug.loc[
    infinite_gats3v,
    ["Drug name", "GATS3v"]
]
修复分三步。
drug["GATS3v"] = drug["GATS3v"].replace(
    [np.inf, -np.inf],
    np.nan
)
先把正负无穷改成 NaN。
gats3v_median = drug["GATS3v"].median()
再计算有效数值的中位数。
drug["GATS3v"] = drug["GATS3v"].fillna(
    gats3v_median
)
最后填补。
这两类 Drug 错误分别是 SpAbs_Dze 的缺失值和 GATS3v 的负无穷。
验证:
drug_feature_columns = drug.columns.drop("Drug name")

print(
    drug[drug_feature_columns]
    .isna()
    .sum()
    .sum()
)

print(
    np.isinf(
        drug[drug_feature_columns].to_numpy()
    ).sum()
)
应该都是:
0
八、Error 5:Mutation 的 0/1 世界里混进了 "MUT_ERROR"
Mutation 数据理论上应该是:
0 或 1
先找出不是数值类型的列:
mutation_feature_columns = mutation.columns.drop(
"Mutation"
)

non_numeric_columns = (
    mutation[mutation_feature_columns]
    .select_dtypes(exclude="number")
    .columns
)

print(non_numeric_columns.tolist())
得到:
['Hs683', 'KE-37']
别急着一起处理。
这两个列看起来都不是普通数值列,但病因完全不同。
检查 Hs683
hs683_numeric = pd.to_numeric(
    mutation["Hs683"],
    errors="coerce"
)

bad_hs683 = (
    hs683_numeric.isna()
    & mutation["Hs683"].notna()
)

mutation.loc[
    bad_hs683,
    ["Mutation", "Hs683"]
]
发现:
Mutation: ENST00000264463/c.2182C>T
Hs683: MUT_ERROR
由于这是二元数据,使用中位数的解释不如众数自然。
hs683_mode = (
    hs683_numeric
    .dropna()
    .mode()
    .iloc[0]
)
然后修复:
mutation.loc[
    bad_hs683,
"Hs683"
] = hs683_mode

mutation["Hs683"] = pd.to_numeric(
    mutation["Hs683"]
)
九、Error 6:KE-37 的值没错,dtype 错了
检查 category 类型:
category_columns = (
    mutation
    .select_dtypes(include="category")
    .columns
)

print(category_columns.tolist())
结果:
['KE-37']
这次不需要填补。
因为 KE-37 中的值本来就是有效的 0 和 1,只是被存成了 category。
直接转换:
mutation["KE-37"] = mutation["KE-37"].astype(
"int8"
)
这里还有一个实用点。
int8 足够保存:
0
1
没有必要使用更占内存的 int64。
Hs683 是字符串污染,KE-37 则只是 category dtype,两者需要不同的处理逻辑。
最后把所有 mutation feature 都转成 int8:
mutation[
    mutation_feature_columns
] = mutation[
    mutation_feature_columns
].astype("int8")
十、把 Mutation 表转过来
当前 Mutation 表是:
行:21,213 个 mutation
列:1,001 个 cell line
我们需要:
行:1,001 个 cell line
列:21,213 个 mutation
代码:
mutation_wide = (
    mutation
    .set_index("Mutation")
    .T
)

mutation_wide.index.name = "cellLine"

mutation_wide = mutation_wide.reset_index()
逐行理解。
.set_index("Mutation")
把 mutation 名称设为行索引。
.T
行列交换。
mutation_wide.index.name = "cellLine"
告诉 pandas,现在每一行的索引代表 cell line。
.reset_index()
把索引重新变成普通列,方便 merge。
检查:
print(mutation_wide.shape)
正确答案:
(1001, 21214)
为什么是 21,214 列?
21,213 mutation features
+ 1 cellLine
= 21,214
配套 Notebook 对转置后的 shape 和 cellLine 唯一性进行了双重验证。
十一、第一次 merge:Response + Drug
Response 中药物列名是:
drug
Drug 数据中药物列名是:
Drug name
名字不同,所以不能写:
on="drug"
正确写法:
merged1 = pd.merge(
    response,
    drug,
    left_on="drug",
    right_on="Drug name",
    how="inner",
    validate="many_to_one"
)
解释两个重要参数。
how="inner"
只保留两边都能匹配的药物。
validate="many_to_one"
检查数据关系是否符合:
很多条 response
对应
一条 drug descriptor
检查:
assert merged1.shape == (194750, 2329)
列数为什么是 2,329?
Response 3列
+ Drug 2,326列
= 2,329列
drug 和 Drug name 名字不同,因此都会保留下来。第一次 merge 的预期结果是 194,750 × 2,329。
十二、第二次 merge:加入 Mutation
merged2 = pd.merge(
    merged1,
    mutation_wide,
    on="cellLine",
    how="inner",
    validate="many_to_one"
)
这次两张表都叫:
cellLine
所以直接使用:
on="cellLine"
检查最终答案:
assert merged2.shape == (182853, 23542)

print(merged2.shape)
输出:
(182853, 23542)
行数计算:
194,750 response rows
- 11,897 个无法与 mutation 精确匹配的 rows
= 182,853 rows
列数计算:
merged1:        2,329
mutation_wide: 21,214
重复 cellLine:     -1
----------------------
最终:           23,542
最终行列数和计算方式都在 Notebook 中通过 assert 固定下来。
十三、为什么 Random Forest 特征是 23,538,而不是 23,542?
最终表有 23,542 列,但下面四列不能作为普通输入特征:
cellLine
drug
IC50(LN)
Drug name
其中:
所以:
23,542 - 4 = 23,538
代码:
non_feature_columns = [
"cellLine",
"drug",
"IC50(LN)",
"Drug name"
]

rf_feature_columns = [
    column
for column in merged2.columns
if column notin non_feature_columns
]

assert len(rf_feature_columns) == 23538
这也正是原始任务给出的 Random Forest 输入特征数量。
十四、最容易把答案做错的一步:不要过度清洗名字
很多人看到细胞系名字,第一反应是统一格式:
.str.lower()
.str.replace("-", "")
.str.replace("_", "")
.str.replace(" ", "")
听起来很专业,但可能是在给数据制造亲戚关系。
例如:
KMH-2
KM-H2
它们未必是同一个细胞系。
如果把连字符全部删除,两者都会变成:
kmh2
结果就是错误匹配。
之前出现过一个结果:
185,194 rows
比正确答案多:
185,194 - 182,853 = 2,341 rows
这些不是模型捡到的免费样本,而是过度规范化制造出来的错误匹配。
这次考试的原则是:
使用原始药物名和 cellLine 名称进行精确匹配。
十五、最终核心代码
import pandas as pd
import numpy as np

response = pd.read_pickle(
"20260729_Response_data_FX.pkl"
)

drug = pd.read_pickle(
"20260729_Drug_data_FX.pkl"
)

mutation = pd.read_pickle(
"20260729_Mutation_data_FX.pkl"
)

# 1. 修复 IC50
ic50 = pd.to_numeric(
    response["IC50(LN)"],
    errors="coerce"
)

response["IC50(LN)"] = ic50.fillna(
    ic50.median()
)

# 2. 修复 Drug descriptor NaN
drug["SpAbs_Dze"] = drug["SpAbs_Dze"].fillna(
    drug["SpAbs_Dze"].median()
)

# 3. 修复 Drug descriptor -inf
drug["GATS3v"] = drug["GATS3v"].replace(
    [np.inf, -np.inf],
    np.nan
)

drug["GATS3v"] = drug["GATS3v"].fillna(
    drug["GATS3v"].median()
)

# 4. 修复 Hs683 字符串
hs683 = pd.to_numeric(
    mutation["Hs683"],
    errors="coerce"
)

mutation["Hs683"] = hs683.fillna(
    hs683.dropna().mode().iloc[0]
).astype("int8")

# 5. 修复 KE-37 dtype
mutation["KE-37"] = mutation["KE-37"].astype(
"int8"
)

# 6. 转置 Mutation
mutation_wide = (
    mutation
    .set_index("Mutation")
    .T
)

mutation_wide.index.name = "cellLine"

mutation_wide = mutation_wide.reset_index()

# 7. 第一次 merge
merged1 = pd.merge(
    response,
    drug,
    left_on="drug",
    right_on="Drug name",
    how="inner",
    validate="many_to_one"
)

# 8. 第二次 merge
merged2 = pd.merge(
    merged1,
    mutation_wide,
    on="cellLine",
    how="inner",
    validate="many_to_one"
)

# 9. 最终检查
assert merged1.shape == (194750, 2329)
assert mutation_wide.shape == (1001, 21214)
assert merged2.shape == (182853, 23542)

print("Mission complete:", merged2.shape)
十六、课后测试
先自己回答,不要急着往下翻。
1
为什么要使用:
errors="coerce"
A. 自动删除错误行 B. 把不能转换成数字的内容变成 NaNC. 把所有数字变成字符串 D. 自动计算中位数
2
下面哪个函数能够发现 -inf?
A. isna()B. isnull()C. np.isinf()D. duplicated()
3
为什么 Mutation 数据需要 .T?
A. 为了删除 mutation B. 为了让 cell line 从列变成行 C. 为了计算 IC50 D. 为了降低特征数量
4
为什么 Hs683 更适合用众数,而不是中位数?
A. 它是药物名称 B. 它是连续型 descriptor C. 它是 0/1 二元数据 D. 它是 IC50
5
第一次 merge 为什么使用:
left_on="drug"
right_on="Drug name"
A. 两张表的 merge key 名称不同 B. 两张表的行数相同 C. 为了自动删除重复列 D. 因为 cellLine 不存在
6
validate="many_to_one" 检查的是什么?
A. 左表每行只能对应左表自己 B. 多条 response 可以对应一个 drug descriptor C. 两张表必须有相同列数 D. 所有数据必须是整数
7
最终为什么有 23,542 列?
请完成:
2,329 + 21,214 - ___ = 23,542
8
Random Forest 为什么只有 23,538 个输入特征?
9
对 cellLine 执行下面操作有什么风险?
.str.replace("-", "")
10
最终最重要的验证代码是什么?
答案
1
B。
errors="coerce" 会把不能转换成数字的字符串变成 NaN。
2
C。
-inf 不是普通缺失值,需要用:
np.isinf()
3
B。
原始 Mutation 表中 cell line 在列上,而 merge 需要一个 cell line 对应一行。
4
C。
Mutation 是 0/1 二元数据,众数比连续型数据常用的中位数更容易解释。
5
A。
左表叫 drug,右表叫 Drug name。
6
B。
多条药物响应记录对应一个药物 descriptor 行。
7
答案是:
1
因为 cellLine 是两张表共有的 merge key,只保留一次。
8
因为需要排除:
cellLine
drug
IC50(LN)
Drug name
所以:
23,542 - 4 = 23,538
9
可能把原本不同的细胞系名称变成相同 key,造成错误匹配和行数膨胀。
10
assert merged2.shape == (182853, 23542)
没有这句,代码跑完了,你也不知道自己是完成任务,还是安静地做错了。
最后一句
这次练习真正训练的,不是 pd.merge()。
而是三个更重要的习惯:
先理解数据结构
再识别数据错误
最后验证结果尺寸
Random Forest 不会因为你写了 n_estimators=500 就自动变聪明。
如果输入表里混着 "False"、-inf 和错误匹配,它只是会用五百棵树,非常认真地学习错误。
 10个月宝宝每天需要喝多少奶粉?